


 Heim
Das weltweit erste auf Ereignisebene basierende Weltmodell für verkörperte Intelligenz macht dem frameweisen Lernen für Roboter ein Ende
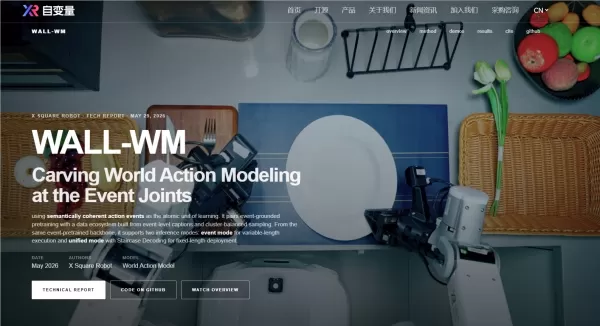
Am 29. Mai stellte das Team von Variable Robot WALL-WM vor, das weltweit erste Weltmodell mit verkörperter Intelligenz, das auf „Vorhersagen auf Ereignisebene“ basiert. Dieses Modell löst sich von herkömmlichen großen Modellen der verkörperten Intelligenz, die Aktionen im Laufe der Zeit Frame für Frame lernen, und verlagert stattdessen die Vorhersageeinheit des Weltmodells auf semantische Ereignisse. Es markiert eine neue Etappe in der Art und Weise, wie Roboter Aufgaben verstehen und ausführen.
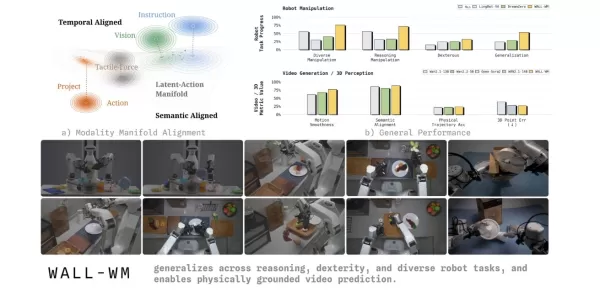
In der aktuellen Branche der verkörperten Intelligenz verwenden gängige Vision-Language-Action-Modelle (VLA) in der Regel ein aktuelles Bild und eine Anweisung, um einen Aktionsblock fester Länge vorherzusagen. Dieser Frame-für-Frame-Trainingsansatz führt oft dazu, dass sich Roboter auf kleine körperliche Bewegungen konzentrieren und dabei das eigentliche Ziel der Aktion aus den Augen verlieren. In Szenarien wie dem Wechseln von Tassen oder Tischen scheitern Roboter häufig aufgrund mangelnder Generalisierungsfähigkeit. Um diesen Schwachpunkt der Branche anzugehen, wies das Variable-Team in seiner wissenschaftlichen Arbeit darauf hin, dass Text-, Bild- und Handlungsinformationen in der realen Welt naturgemäß auf unterschiedlichen Zeitskalen und in vielfältigen Geometrien existieren. Werden diese in einen einzigen gemeinsamen Raum gezwängt, kann dies leicht die vortrainierte geometrische Priorität beeinträchtigen.
Um diese Herausforderung zu bewältigen, führt das WALL-WM-Weltmodell einen innovativen ereigniszentrierten Trainings- und Ausführungsmechanismus ein. Es zerlegt komplexe Aufgaben in semantisch klare Ereignisverbindungen wie Greifen, Ergreifen und Bewegen. Im Betrieb berechnet das Modell den nächsten Bildframe nicht mehr starr. Stattdessen simuliert es zunächst, wie sich die Welt durch das nächste Ereignis verändern wird, und übersetzt diese visuelle Veränderung dann präzise in die Bewegungsbahn des Roboterarms.
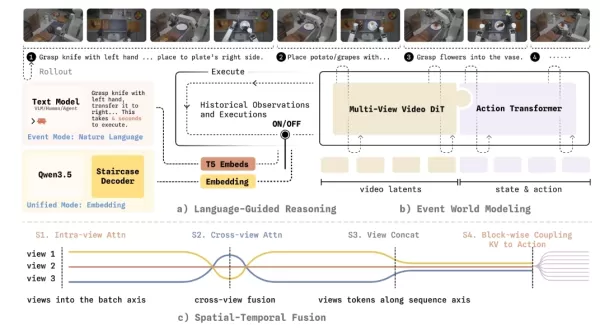
Um sicherzustellen, dass diese neue Architektur zuverlässig in der physischen Welt eingesetzt werden kann, führte das Variable-Robot-Team eine Reihe umfassender technischer Überarbeitungen durch. Das System unterstützt den flexiblen Wechsel zwischen dem „Ereignismodus“ (mit Aktionsausgabe variabler Länge) und dem „Unified-Modus“ (mit Echtzeit-Regelung) auf Basis derselben Grundgewichte. Außerdem erreicht es eine Einwegkopplung zwischen Videomodellen und Aktionsmodellen, wodurch verhindert wird, dass wertvolle dynamische Vorinformationen aus Internetvideos vorzeitig durch Aktionsdaten verzerrt werden. Für die geometrische Wahrnehmung über mehrere Kameras hinweg führt das Modell Frustum-Masken und röhrenförmige Masken ein, wodurch die KI gezwungen wird, eine sichtfeldübergreifende, echte dreidimensionale geometrische Entsprechung zu entwickeln. Um die Entscheidungslatenz zu verringern, wird eine neue „Stepped Chain-of-Thought Decoding“-Technik eingesetzt, die die Dekodierungsverzögerung deutlich reduziert und gleichzeitig die logische Interpretierbarkeit gewährleistet.
Verwandter Artikel
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (1)
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
Am 29. Mai stellte das Team von Variable Robot WALL-WM vor, das weltweit erste Weltmodell mit verkörperter Intelligenz, das auf „Vorhersagen auf Ereignisebene“ basiert. Dieses Modell löst sich von herkömmlichen großen Modellen der verkörperten Intelligenz, die Aktionen im Laufe der Zeit Frame für Frame lernen, und verlagert stattdessen die Vorhersageeinheit des Weltmodells auf semantische Ereignisse. Es markiert eine neue Etappe in der Art und Weise, wie Roboter Aufgaben verstehen und ausführen.
In der aktuellen Branche der verkörperten Intelligenz verwenden gängige Vision-Language-Action-Modelle (VLA) in der Regel ein aktuelles Bild und eine Anweisung, um einen Aktionsblock fester Länge vorherzusagen. Dieser Frame-für-Frame-Trainingsansatz führt oft dazu, dass sich Roboter auf kleine körperliche Bewegungen konzentrieren und dabei das eigentliche Ziel der Aktion aus den Augen verlieren. In Szenarien wie dem Wechseln von Tassen oder Tischen scheitern Roboter häufig aufgrund mangelnder Generalisierungsfähigkeit. Um diesen Schwachpunkt der Branche anzugehen, wies das Variable-Team in seiner wissenschaftlichen Arbeit darauf hin, dass Text-, Bild- und Handlungsinformationen in der realen Welt naturgemäß auf unterschiedlichen Zeitskalen und in vielfältigen Geometrien existieren. Werden diese in einen einzigen gemeinsamen Raum gezwängt, kann dies leicht die vortrainierte geometrische Priorität beeinträchtigen.
Um diese Herausforderung zu bewältigen, führt das WALL-WM-Weltmodell einen innovativen ereigniszentrierten Trainings- und Ausführungsmechanismus ein. Es zerlegt komplexe Aufgaben in semantisch klare Ereignisverbindungen wie Greifen, Ergreifen und Bewegen. Im Betrieb berechnet das Modell den nächsten Bildframe nicht mehr starr. Stattdessen simuliert es zunächst, wie sich die Welt durch das nächste Ereignis verändern wird, und übersetzt diese visuelle Veränderung dann präzise in die Bewegungsbahn des Roboterarms.
Um sicherzustellen, dass diese neue Architektur zuverlässig in der physischen Welt eingesetzt werden kann, führte das Variable-Robot-Team eine Reihe umfassender technischer Überarbeitungen durch. Das System unterstützt den flexiblen Wechsel zwischen dem „Ereignismodus“ (mit Aktionsausgabe variabler Länge) und dem „Unified-Modus“ (mit Echtzeit-Regelung) auf Basis derselben Grundgewichte. Außerdem erreicht es eine Einwegkopplung zwischen Videomodellen und Aktionsmodellen, wodurch verhindert wird, dass wertvolle dynamische Vorinformationen aus Internetvideos vorzeitig durch Aktionsdaten verzerrt werden. Für die geometrische Wahrnehmung über mehrere Kameras hinweg führt das Modell Frustum-Masken und röhrenförmige Masken ein, wodurch die KI gezwungen wird, eine sichtfeldübergreifende, echte dreidimensionale geometrische Entsprechung zu entwickeln. Um die Entscheidungslatenz zu verringern, wird eine neue „Stepped Chain-of-Thought Decoding“-Technik eingesetzt, die die Dekodierungsverzögerung deutlich reduziert und gleichzeitig die logische Interpretierbarkeit gewährleistet.








 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
 Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












