


 Дом
Первая в мире глобальная модель воплощенного интеллекта на уровне событий положит конец покадровому обучению роботов
29 мая команда Variable Robot представила WALL-WM — первую в мире модель окружающего мира с встроенным интеллектом, основанную на «прогнозировании на уровне событий». Эта модель отходит от традиционных крупных моделей с воплощенным интеллектом, которые обучаются действиям кадр за кадром с течением времени, и вместо этого переключает блок прогнозирования модели мира на семантические события. Это знаменует собой новый этап в том, как роботы понимают и выполняют задачи.
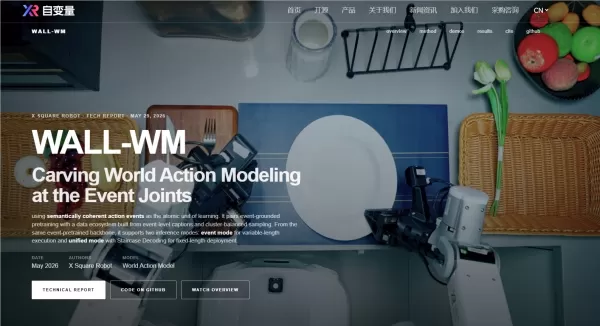
В современной индустрии воплощенного интеллекта основные модели «зрение-язык-действие» (VLA) обычно используют текущее изображение и инструкцию для прогнозирования блока действий фиксированной длины. Такой подход к обучению кадр за кадром часто приводит к тому, что роботы сосредотачиваются на незначительных физических движениях, теряя из виду конечную цель действия. Столкнувшись с такими сценариями, как смена чашек или столов, роботы часто терпят неудачу из-за отсутствия обобщения. Чтобы решить эту проблему отрасли, команда Variable указала в своей научной статье, что информация о тексте, зрении и действиях естественным образом существует в реальном мире в разных временных масштабах и многомерных геометриях. Принудительное объединение их в единое общее пространство может легко повредить предварительно обученную геометрическую априорную модель.
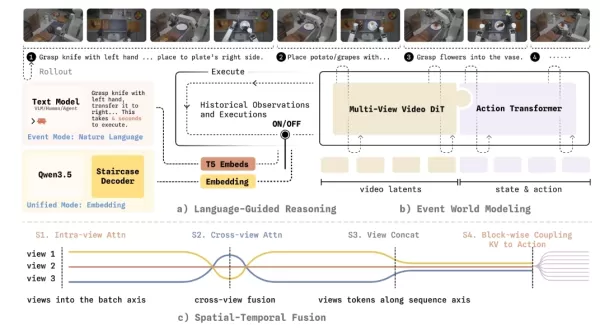
Чтобы решить эту проблему, модель мира WALL-WM вводит инновационный механизм обучения и выполнения, ориентированный на события. Она разбивает сложные задачи на семантически понятные событийные узлы, такие как достижение, захват и перемещение. В процессе работы модель больше не вычисляет следующий кадр изображения жестким образом. Вместо этого она сначала моделирует, как изменится мир в результате следующего события, а затем точно преобразует это визуальное изменение в траекторию движения роботизированной руки.
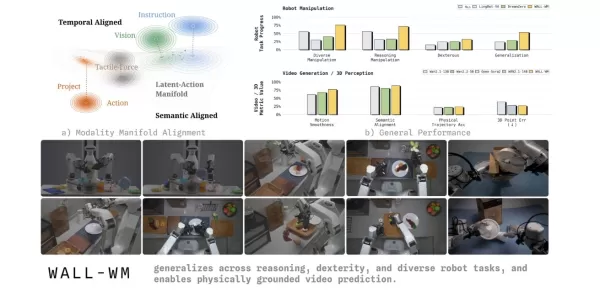
Чтобы обеспечить надежное внедрение этой новой архитектуры в физическом мире, команда Variable Robot провела серию серьезных инженерных доработок. Система поддерживает гибкое переключение между «режимом событий» (с выходом действий переменной длины) и «унифицированным режимом» (с управлением в реальном времени по замкнутому циклу) на основе одних и тех же базовых весов. Она также обеспечивает одностороннюю связь между видеомоделями и моделями действий, предотвращая преждевременное смещение ценных динамических априорных значений из интернет-видео данными о действиях. Для геометрического восприятия с помощью нескольких камер в модели введены маски в виде пирамидального среза и трубчатые маски, что заставляет ИИ развивать истинное трехмерное геометрическое соответствие между различными ракурсами. Для решения проблемы задержки принятия решений используется новая техника «ступенчатого декодирования цепочки мыслей», которая значительно сокращает задержку декодирования, сохраняя при этом логическую интерпретируемость.
Связанная статья
 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
 9 инструментов
 xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai
код
Инструменты на базе ИИ для проверки пулл-реквестов в командах GitHub, занимающихся рефакторингом, устранением ошибок и устранением уязвимостей
2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

 Комментарии (1)
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
29 мая команда Variable Robot представила WALL-WM — первую в мире модель окружающего мира с встроенным интеллектом, основанную на «прогнозировании на уровне событий». Эта модель отходит от традиционных крупных моделей с воплощенным интеллектом, которые обучаются действиям кадр за кадром с течением времени, и вместо этого переключает блок прогнозирования модели мира на семантические события. Это знаменует собой новый этап в том, как роботы понимают и выполняют задачи.
В современной индустрии воплощенного интеллекта основные модели «зрение-язык-действие» (VLA) обычно используют текущее изображение и инструкцию для прогнозирования блока действий фиксированной длины. Такой подход к обучению кадр за кадром часто приводит к тому, что роботы сосредотачиваются на незначительных физических движениях, теряя из виду конечную цель действия. Столкнувшись с такими сценариями, как смена чашек или столов, роботы часто терпят неудачу из-за отсутствия обобщения. Чтобы решить эту проблему отрасли, команда Variable указала в своей научной статье, что информация о тексте, зрении и действиях естественным образом существует в реальном мире в разных временных масштабах и многомерных геометриях. Принудительное объединение их в единое общее пространство может легко повредить предварительно обученную геометрическую априорную модель.
Чтобы решить эту проблему, модель мира WALL-WM вводит инновационный механизм обучения и выполнения, ориентированный на события. Она разбивает сложные задачи на семантически понятные событийные узлы, такие как достижение, захват и перемещение. В процессе работы модель больше не вычисляет следующий кадр изображения жестким образом. Вместо этого она сначала моделирует, как изменится мир в результате следующего события, а затем точно преобразует это визуальное изменение в траекторию движения роботизированной руки.
Чтобы обеспечить надежное внедрение этой новой архитектуры в физическом мире, команда Variable Robot провела серию серьезных инженерных доработок. Система поддерживает гибкое переключение между «режимом событий» (с выходом действий переменной длины) и «унифицированным режимом» (с управлением в реальном времени по замкнутому циклу) на основе одних и тех же базовых весов. Она также обеспечивает одностороннюю связь между видеомоделями и моделями действий, предотвращая преждевременное смещение ценных динамических априорных значений из интернет-видео данными о действиях. Для геометрического восприятия с помощью нескольких камер в модели введены маски в виде пирамидального среза и трубчатые маски, что заставляет ИИ развивать истинное трехмерное геометрическое соответствие между различными ракурсами. Для решения проблемы задержки принятия решений используется новая техника «ступенчатого декодирования цепочки мыслей», которая значительно сокращает задержку декодирования, сохраняя при этом логическую интерпретируемость.








 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
 Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
 Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












