


 Maison
Le premier modèle mondial d'intelligence incarnée au niveau des événements met fin à l'apprentissage image par image pour les robots
Le 29 mai, l'équipe de Variable Robot a dévoilé WALL-WM, le premier modèle du monde doté d'une intelligence incarnée au monde, fondé sur la « prédiction au niveau des événements ». Ce modèle s'affranchit des grands modèles incarnés conventionnels qui apprennent les actions image par image au fil du temps, en orientant plutôt l'unité de prédiction du modèle du monde vers des événements sémantiques. Il marque une nouvelle étape dans la manière dont les robots comprennent et exécutent les tâches.
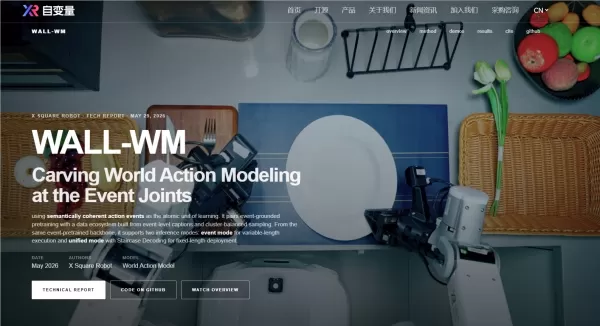
Dans le secteur actuel de l’intelligence incarnée, les modèles VLA (vision-langage-action) dominants utilisent généralement une image et une instruction du moment pour prédire un bloc d’action de longueur fixe. Cette approche d’entraînement image par image conduit souvent les robots à se concentrer sur des mouvements physiques mineurs tout en perdant de vue l’objectif final de l’action. Face à des scénarios tels que le changement de tasses ou de tables, les robots échouent fréquemment en raison d’un manque de généralisation. Pour remédier à ce problème majeur du secteur, l’équipe de Variable a souligné dans son article scientifique que les informations textuelles, visuelles et d’action existent naturellement à différentes échelles de temps et dans des géométries multiples dans le monde réel. Les forcer à cohabiter dans un seul espace commun peut facilement endommager le modèle géométrique pré-entraîné.
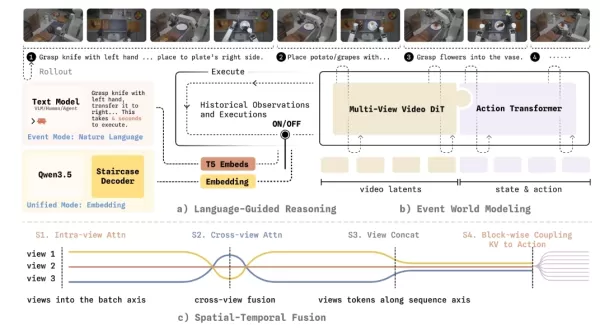
Pour relever ce défi, le modèle du monde WALL-WM introduit un mécanisme innovant d’entraînement et d’exécution centré sur les événements. Il décompose les tâches complexes en événements sémantiquement clairs, tels que tendre le bras, saisir et déplacer. En fonctionnement, le modèle ne calcule plus de manière rigide l'image suivante. Au lieu de cela, il simule d'abord comment le monde va changer en raison de l'événement suivant, puis traduit précisément ce changement visuel en trajectoire de mouvement du bras robotique.
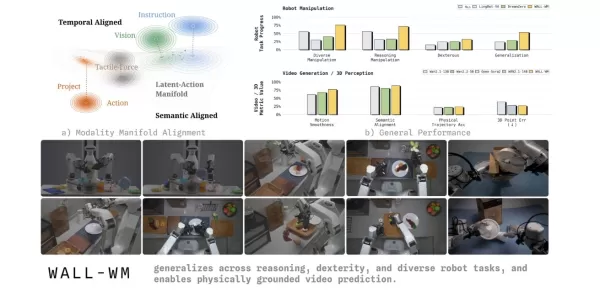
Pour garantir que cette nouvelle architecture puisse être déployée de manière fiable dans le monde physique, l'équipe de Variable Robot a procédé à une série de révisions techniques approfondies. Le système prend en charge une commutation flexible entre le « mode événement » (avec une sortie d'action de longueur variable) et le « mode unifié » (avec un contrôle en boucle fermée en temps réel) sur les mêmes poids de base. Il réalise également un couplage unidirectionnel entre les modèles vidéo et les modèles d’action, empêchant ainsi que les précieuses informations a priori dynamiques issues des vidéos Internet ne soient prématurément biaisées par les données d’action. Pour la perception géométrique à partir de plusieurs caméras, le modèle introduit des masques de frustum et des masques tubulaires, forçant l'IA à développer une correspondance géométrique tridimensionnelle réelle entre les différentes vues. Pour remédier à la latence de décision, il utilise une nouvelle technique de « décodage par chaîne de pensée par étapes » qui réduit considérablement le délai de décodage tout en conservant l'interprétabilité logique.
Article connexe
 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss
Recommandations de sujets spéciaux liés
Éducation et apprentissage
 Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

 commentaires (1)
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
Le 29 mai, l'équipe de Variable Robot a dévoilé WALL-WM, le premier modèle du monde doté d'une intelligence incarnée au monde, fondé sur la « prédiction au niveau des événements ». Ce modèle s'affranchit des grands modèles incarnés conventionnels qui apprennent les actions image par image au fil du temps, en orientant plutôt l'unité de prédiction du modèle du monde vers des événements sémantiques. Il marque une nouvelle étape dans la manière dont les robots comprennent et exécutent les tâches.
Dans le secteur actuel de l’intelligence incarnée, les modèles VLA (vision-langage-action) dominants utilisent généralement une image et une instruction du moment pour prédire un bloc d’action de longueur fixe. Cette approche d’entraînement image par image conduit souvent les robots à se concentrer sur des mouvements physiques mineurs tout en perdant de vue l’objectif final de l’action. Face à des scénarios tels que le changement de tasses ou de tables, les robots échouent fréquemment en raison d’un manque de généralisation. Pour remédier à ce problème majeur du secteur, l’équipe de Variable a souligné dans son article scientifique que les informations textuelles, visuelles et d’action existent naturellement à différentes échelles de temps et dans des géométries multiples dans le monde réel. Les forcer à cohabiter dans un seul espace commun peut facilement endommager le modèle géométrique pré-entraîné.
Pour relever ce défi, le modèle du monde WALL-WM introduit un mécanisme innovant d’entraînement et d’exécution centré sur les événements. Il décompose les tâches complexes en événements sémantiquement clairs, tels que tendre le bras, saisir et déplacer. En fonctionnement, le modèle ne calcule plus de manière rigide l'image suivante. Au lieu de cela, il simule d'abord comment le monde va changer en raison de l'événement suivant, puis traduit précisément ce changement visuel en trajectoire de mouvement du bras robotique.
Pour garantir que cette nouvelle architecture puisse être déployée de manière fiable dans le monde physique, l'équipe de Variable Robot a procédé à une série de révisions techniques approfondies. Le système prend en charge une commutation flexible entre le « mode événement » (avec une sortie d'action de longueur variable) et le « mode unifié » (avec un contrôle en boucle fermée en temps réel) sur les mêmes poids de base. Il réalise également un couplage unidirectionnel entre les modèles vidéo et les modèles d’action, empêchant ainsi que les précieuses informations a priori dynamiques issues des vidéos Internet ne soient prématurément biaisées par les données d’action. Pour la perception géométrique à partir de plusieurs caméras, le modèle introduit des masques de frustum et des masques tubulaires, forçant l'IA à développer une correspondance géométrique tridimensionnelle réelle entre les différentes vues. Pour remédier à la latence de décision, il utilise une nouvelle technique de « décodage par chaîne de pensée par étapes » qui réduit considérablement le délai de décodage tout en conservant l'interprétabilité logique.








 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
 MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
 La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












