


 Lar
OpenAI e NVIDIA desenvolvem o protocolo MRC para transformar as redes de treinamento de IA
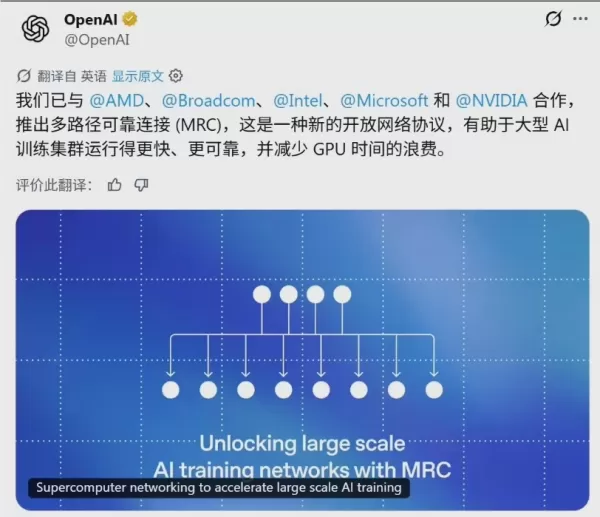
A OpenAI anunciou oficialmente uma colaboração com cinco líderes do setor — AMD, Broadcom, Intel, Microsoft e NVIDIA — para lançar o protocolo Multipath Reliable Connection (MRC). Esse protocolo de código aberto, lançado por meio do Open Compute Project (OCP), foi projetado para lidar com a latência de rede e as falhas comumente encontradas no treinamento de IA em grande escala.
Eliminando o “ponto único de falha”: da arquitetura de três camadas para a de duas camadas
No treinamento tradicional de modelos de IA, o congestionamento da rede ou uma pequena falha em um único link pode causar um efeito dominó, forçando dezenas de milhares de GPUs a ficarem ociosas e levando a um desperdício computacional significativo.
Para melhorar fundamentalmente a resiliência do sistema, o protocolo MRC introduz um projeto de rede multiplano. Ele divide de forma inteligente uma única interface de 800 Gb/s em vários links menores. Essa otimização estrutural permite que o sistema suporte clusters massivos de até aproximadamente 131.000 GPUs usando apenas duas camadas de switch. Em comparação com as arquiteturas tradicionais de duas ou quatro camadas, essa mudança não apenas reduz drasticamente o número de componentes físicos e o consumo de energia, mas também diminui significativamente os custos de construção.
Gerenciamento avançado de tráfego: “dispersão” de pacotes e recuperação em nível de microssegundos
Além da simplificação arquitetônica, o MRC introduz uma abordagem inovadora para a distribuição de tráfego. Ele emprega tecnologia adaptativa de pulverização de pacotes, afastando-se da transmissão tradicional de caminho único. Esse método divide os pacotes de tarefas e os distribui por centenas de caminhos paralelos. Mesmo que os pacotes cheguem fora de ordem, o receptor pode remontá-los com precisão, prevenindo efetivamente o congestionamento localizado na rede central.
Para o controle de rede, o MRC substitui protocolos complexos de roteamento dinâmico (como o BGP) pela tecnologia de roteamento de origem SRv6. Isso permite que o remetente especifique diretamente o caminho, enquanto os switches realizam apenas um encaminhamento estático simples. Esse projeto reduz drasticamente o tempo de recuperação de falhas de rede de segundos para microssegundos, permitindo que o sistema alcance uma “autocorreção quase perfeita” diante da instabilidade do link.
Validação no mundo real: o “estabilizador” do supercomputador
O protocolo MRC já está implantado no supercomputador GB200 da NVIDIA e na infraestrutura de nuvem da Oracle. Dados de teste confirmam que, mesmo durante cenários de treinamento ativo, o MRC pode redirecionar automaticamente em torno de interrupções — como jitter repentino de link ou reinicializações de switch — garantindo que tarefas complexas de treinamento continuem sem interrupção.
Artigo relacionado
 MiniMax Lança Programa de Equipes 10x para Incentivar Especialistas Globais em IA
A MiniMax (Xiyu Technology), o Laboratório de Inteligência Artificial Geral, lançou oficialmente o "Equipe 10x", uma iniciativa global de colaboração de talentos. Este programa visa recrutar os melhores especialistas de diversos setores para explorar
A Coreia do Sul inicia a construção do Centro Nacional de Computação em IA, investindo 2,5 trilhões de won com meta para 2028
O outlet sul-coreano EtNews relata que a cerimônia de lançamento da pedra fundamental do Centro de Computação em IA da Coreia (KOACC) ocorreu em 3 de agosto no parque de data centers Solar City, em Sunan, Jeollanam-do. Com um investimento total de 2,
Seis Gigantes da Tecnologia Apoiam a Linux Foundation com US$ 12,5 Milhões para Enfrentar o Ruído das Vulnerabilidades de IA
Para enfrentar o fluxo de relatórios de segurança de baixa qualidade produzidos por ferramentas de automação de IA, seis grandes empresas de tecnologia — Anthropic, Amazon (AWS), GitHub, Google, Microsoft e OpenAI — contribuíram coletivamente com US$
Recomendações de tópicos especiais relacionados
Composição musical
 Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
 9 ferramentas
 xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai
Educação e Aprendizagem
Plataformas de Construção de Questionários de IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes
2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai
código
Ferramentas de revisão de pull requests com IA para equipes do GitHub que lidam com refatorações, bugs e falhas de segurança
As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai

 Comentários (0)
A OpenAI anunciou oficialmente uma colaboração com cinco líderes do setor — AMD, Broadcom, Intel, Microsoft e NVIDIA — para lançar o protocolo Multipath Reliable Connection (MRC). Esse protocolo de código aberto, lançado por meio do Open Compute Project (OCP), foi projetado para lidar com a latência de rede e as falhas comumente encontradas no treinamento de IA em grande escala.
Eliminando o “ponto único de falha”: da arquitetura de três camadas para a de duas camadas
No treinamento tradicional de modelos de IA, o congestionamento da rede ou uma pequena falha em um único link pode causar um efeito dominó, forçando dezenas de milhares de GPUs a ficarem ociosas e levando a um desperdício computacional significativo.
Para melhorar fundamentalmente a resiliência do sistema, o protocolo MRC introduz um projeto de rede multiplano. Ele divide de forma inteligente uma única interface de 800 Gb/s em vários links menores. Essa otimização estrutural permite que o sistema suporte clusters massivos de até aproximadamente 131.000 GPUs usando apenas duas camadas de switch. Em comparação com as arquiteturas tradicionais de duas ou quatro camadas, essa mudança não apenas reduz drasticamente o número de componentes físicos e o consumo de energia, mas também diminui significativamente os custos de construção.
Gerenciamento avançado de tráfego: “dispersão” de pacotes e recuperação em nível de microssegundos
Além da simplificação arquitetônica, o MRC introduz uma abordagem inovadora para a distribuição de tráfego. Ele emprega tecnologia adaptativa de pulverização de pacotes, afastando-se da transmissão tradicional de caminho único. Esse método divide os pacotes de tarefas e os distribui por centenas de caminhos paralelos. Mesmo que os pacotes cheguem fora de ordem, o receptor pode remontá-los com precisão, prevenindo efetivamente o congestionamento localizado na rede central.
Para o controle de rede, o MRC substitui protocolos complexos de roteamento dinâmico (como o BGP) pela tecnologia de roteamento de origem SRv6. Isso permite que o remetente especifique diretamente o caminho, enquanto os switches realizam apenas um encaminhamento estático simples. Esse projeto reduz drasticamente o tempo de recuperação de falhas de rede de segundos para microssegundos, permitindo que o sistema alcance uma “autocorreção quase perfeita” diante da instabilidade do link.
Validação no mundo real: o “estabilizador” do supercomputador
O protocolo MRC já está implantado no supercomputador GB200 da NVIDIA e na infraestrutura de nuvem da Oracle. Dados de teste confirmam que, mesmo durante cenários de treinamento ativo, o MRC pode redirecionar automaticamente em torno de interrupções — como jitter repentino de link ou reinicializações de switch — garantindo que tarefas complexas de treinamento continuem sem interrupção.








 MiniMax Lança Programa de Equipes 10x para Incentivar Especialistas Globais em IA
A MiniMax (Xiyu Technology), o Laboratório de Inteligência Artificial Geral, lançou oficialmente o "Equipe 10x", uma iniciativa global de colaboração de talentos. Este programa visa recrutar os melhores especialistas de diversos setores para explorar
 A Coreia do Sul inicia a construção do Centro Nacional de Computação em IA, investindo 2,5 trilhões de won com meta para 2028
O outlet sul-coreano EtNews relata que a cerimônia de lançamento da pedra fundamental do Centro de Computação em IA da Coreia (KOACC) ocorreu em 3 de agosto no parque de data centers Solar City, em Sunan, Jeollanam-do. Com um investimento total de 2,
 Seis Gigantes da Tecnologia Apoiam a Linux Foundation com US$ 12,5 Milhões para Enfrentar o Ruído das Vulnerabilidades de IA
Para enfrentar o fluxo de relatórios de segurança de baixa qualidade produzidos por ferramentas de automação de IA, seis grandes empresas de tecnologia — Anthropic, Amazon (AWS), GitHub, Google, Microsoft e OpenAI — contribuíram coletivamente com US$

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai












