


 Heim
OpenAI und NVIDIA entwickeln gemeinsam das MRC-Protokoll zur Optimierung von KI-Trainingsnetzwerken
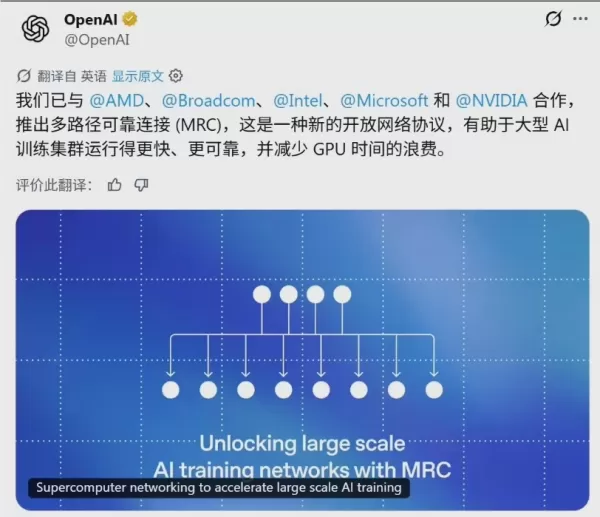
OpenAI hat offiziell eine Zusammenarbeit mit fünf Branchenführern – AMD, Broadcom, Intel, Microsoft und NVIDIA – bekannt gegeben, um das „Multipath Reliable Connection“ (MRC)-Protokoll einzuführen. Dieses Open-Source-Protokoll, das über das Open Compute Project (OCP) veröffentlicht wird, soll die Netzwerklatenz und Ausfälle bekämpfen, die beim Training großer KI-Modelle häufig auftreten.
Beseitigung des „Single Point of Failure“: Von einer dreistufigen zu einer zweistufigen Architektur
Beim herkömmlichen Training von KI-Modellen können Netzwerküberlastungen oder kleinere Ausfälle an einer einzelnen Verbindung wie Dominosteine eine Kettenreaktion auslösen, wodurch Zehntausende von GPUs in den Leerlaufzustand versetzt werden und erhebliche Rechenkapazitäten verschwendet werden.
Um die Systemresilienz grundlegend zu verbessern, führt das MRC-Protokoll ein Multi-Plane-Netzwerkdesign ein. Es unterteilt eine einzelne 800-Gb/s-Schnittstelle intelligent in mehrere kleinere Verbindungen. Diese strukturelle Optimierung ermöglicht es dem System, riesige Cluster mit bis zu etwa 131.000 GPUs mit nur zwei Switch-Ebenen zu unterstützen. Im Vergleich zu herkömmlichen Zwei- oder Vier-Ebenen-Architekturen reduziert dieser Ansatz nicht nur die Anzahl der physischen Komponenten und den Energieverbrauch drastisch, sondern senkt auch die Baukosten erheblich.
Fortschrittliches Verkehrsmanagement: „Paket-Spraying“ und Wiederherstellung im Mikrosekundenbereich
Über die Vereinfachung der Architektur hinaus führt MRC einen neuartigen Ansatz zur Datenverkehrsverteilung ein. Es nutzt adaptive Packet-Spraying-Technologie und löst sich damit von der herkömmlichen Einzelpfadübertragung. Diese Methode zerlegt Aufgabenpakete und verteilt sie auf Hunderte paralleler Pfade. Selbst wenn Pakete in falscher Reihenfolge ankommen, kann der Empfänger sie korrekt wieder zusammensetzen, wodurch lokale Überlastungen im Kernnetzwerk wirksam verhindert werden.
Für die Netzwerksteuerung ersetzt MRC komplexe dynamische Routing-Protokolle (wie BGP) durch die SRv6-Source-Routing-Technologie. Dies ermöglicht es dem Absender, den Pfad direkt festzulegen, während Switches nur einfache statische Weiterleitung durchführen. Dieses Design verkürzt die Wiederherstellungszeit bei Netzwerkfehlern von Sekunden auf Mikrosekunden und ermöglicht es dem System, bei Verbindungsinstabilität eine nahezu „nahtlose Selbstheilung“ zu erreichen.
Praxistest: Der Supercomputer „Stabilizer“
Das MRC-Protokoll ist bereits im GB200-Supercomputer von NVIDIA und in der Cloud-Infrastruktur von Oracle im Einsatz. Testdaten bestätigen, dass MRC selbst während aktiver Trainingsszenarien Störungen – wie plötzliche Verbindungsschwankungen oder Switch-Neustarts – automatisch umgehen kann und so sicherstellt, dass komplexe Trainingsaufgaben ohne Unterbrechung fortgesetzt werden.
Verwandter Artikel
 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
OpenAI hat offiziell eine Zusammenarbeit mit fünf Branchenführern – AMD, Broadcom, Intel, Microsoft und NVIDIA – bekannt gegeben, um das „Multipath Reliable Connection“ (MRC)-Protokoll einzuführen. Dieses Open-Source-Protokoll, das über das Open Compute Project (OCP) veröffentlicht wird, soll die Netzwerklatenz und Ausfälle bekämpfen, die beim Training großer KI-Modelle häufig auftreten.
Beseitigung des „Single Point of Failure“: Von einer dreistufigen zu einer zweistufigen Architektur
Beim herkömmlichen Training von KI-Modellen können Netzwerküberlastungen oder kleinere Ausfälle an einer einzelnen Verbindung wie Dominosteine eine Kettenreaktion auslösen, wodurch Zehntausende von GPUs in den Leerlaufzustand versetzt werden und erhebliche Rechenkapazitäten verschwendet werden.
Um die Systemresilienz grundlegend zu verbessern, führt das MRC-Protokoll ein Multi-Plane-Netzwerkdesign ein. Es unterteilt eine einzelne 800-Gb/s-Schnittstelle intelligent in mehrere kleinere Verbindungen. Diese strukturelle Optimierung ermöglicht es dem System, riesige Cluster mit bis zu etwa 131.000 GPUs mit nur zwei Switch-Ebenen zu unterstützen. Im Vergleich zu herkömmlichen Zwei- oder Vier-Ebenen-Architekturen reduziert dieser Ansatz nicht nur die Anzahl der physischen Komponenten und den Energieverbrauch drastisch, sondern senkt auch die Baukosten erheblich.
Fortschrittliches Verkehrsmanagement: „Paket-Spraying“ und Wiederherstellung im Mikrosekundenbereich
Über die Vereinfachung der Architektur hinaus führt MRC einen neuartigen Ansatz zur Datenverkehrsverteilung ein. Es nutzt adaptive Packet-Spraying-Technologie und löst sich damit von der herkömmlichen Einzelpfadübertragung. Diese Methode zerlegt Aufgabenpakete und verteilt sie auf Hunderte paralleler Pfade. Selbst wenn Pakete in falscher Reihenfolge ankommen, kann der Empfänger sie korrekt wieder zusammensetzen, wodurch lokale Überlastungen im Kernnetzwerk wirksam verhindert werden.
Für die Netzwerksteuerung ersetzt MRC komplexe dynamische Routing-Protokolle (wie BGP) durch die SRv6-Source-Routing-Technologie. Dies ermöglicht es dem Absender, den Pfad direkt festzulegen, während Switches nur einfache statische Weiterleitung durchführen. Dieses Design verkürzt die Wiederherstellungszeit bei Netzwerkfehlern von Sekunden auf Mikrosekunden und ermöglicht es dem System, bei Verbindungsinstabilität eine nahezu „nahtlose Selbstheilung“ zu erreichen.
Praxistest: Der Supercomputer „Stabilizer“
Das MRC-Protokoll ist bereits im GB200-Supercomputer von NVIDIA und in der Cloud-Infrastruktur von Oracle im Einsatz. Testdaten bestätigen, dass MRC selbst während aktiver Trainingsszenarien Störungen – wie plötzliche Verbindungsschwankungen oder Switch-Neustarts – automatisch umgehen kann und so sicherstellt, dass komplexe Trainingsaufgaben ohne Unterbrechung fortgesetzt werden.








 ByteDance erhöht die Kern-KI-Anreize, während Doubao um 14,6 % steigt
ByteDance hat kürzlich ein Equity-Briefing für DouBao abgehalten, um neue Anreizrichtlinien für Mitarbeiter der DouBao-Sparte vorzustellen. Der Ausübungspreis für DouBao-Anteile wurde von 14,85 US-Dollar im Juni 2026 auf 17,02 US-Dollar angehoben, wa
 MiniMax stellt 10x-Teamprogramm vor, um globale KI-Experten zu motivieren
MiniMax (Xiyu Technology), das General Artificial Intelligence Lab, hat offiziell „10x Team“ gestartet, eine globale Initiative zur Talentsuche und Zusammenarbeit. Dieses Programm zielt darauf ab, führende Experten aus verschiedenen Branchen zu rekru
 Südkorea beginnt mit dem Bau des nationalen KI-Rechenzentrums und investiert 2,5 Billionen Won mit einem Zieljahr von 2028
Der südkoreanische Ableger von EtNews berichtet, dass am 3. August im Solar City-Datenzentrumspark in Sunan, Provinz Jeollanam-do, der Grundstein für das Korea AI Computing Center (KOACC) gelegt wurde. Mit einer Gesamtinvestition von 2,5 Billionen KR

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












