


 Maison
OpenAI et NVIDIA s'associent pour développer le protocole MRC afin de transformer les réseaux d'entraînement en IA
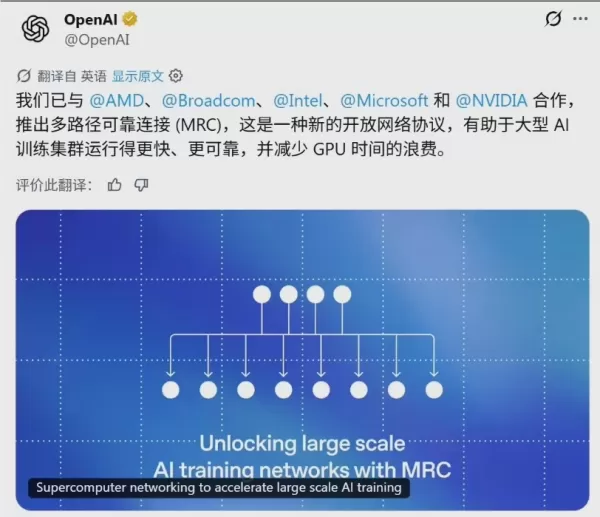
OpenAI a officiellement annoncé une collaboration avec cinq leaders du secteur — AMD, Broadcom, Intel, Microsoft et NVIDIA — en vue du lancement du protocole MRC (Multipath Reliable Connection). Ce protocole open source, publié dans le cadre de l'Open Compute Project (OCP), est conçu pour remédier aux problèmes de latence et aux pannes réseau fréquemment rencontrés lors de l'entraînement de l'IA à grande échelle.
Éliminer le « point de défaillance unique » : passer d'une architecture à trois niveaux à une architecture à deux niveaux
Dans l'entraînement traditionnel des modèles d'IA, la congestion du réseau ou une défaillance mineure sur une seule liaison peut se propager en cascade, comme des dominos, forçant des dizaines de milliers de GPU à passer en état d'inactivité et entraînant un gaspillage informatique considérable.
Afin d’améliorer fondamentalement la résilience du système, le protocole MRC introduit une conception de réseau multiplan. Il divise intelligemment une interface unique de 800 Gb/s en plusieurs liaisons plus petites. Cette optimisation structurelle permet au système de prendre en charge des clusters massifs comptant jusqu’à environ 131 000 GPU en utilisant seulement deux couches de commutation. Par rapport aux architectures traditionnelles à deux ou quatre niveaux, cette évolution réduit non seulement de manière drastique le nombre de composants physiques et la consommation d'énergie, mais diminue également considérablement les coûts de construction.
Gestion avancée du trafic : « pulvérisation » de paquets et récupération à l'échelle de la microseconde
Au-delà de la simplification architecturale, le MRC introduit une approche novatrice de la distribution du trafic. Il utilise une technologie de « pulvérisation » adaptative des paquets, s'éloignant de la transmission traditionnelle à chemin unique. Cette méthode décompose les paquets de tâches et les distribue sur des centaines de chemins parallèles. Même si les paquets arrivent dans le désordre, le récepteur peut les réassembler avec précision, empêchant ainsi efficacement la congestion localisée au sein du réseau central.
Pour le contrôle du réseau, le MRC remplace les protocoles de routage dynamique complexes (tels que le BGP) par la technologie de routage par source SRv6. Cela permet à l’expéditeur de spécifier directement le chemin, tandis que les commutateurs n’effectuent qu’un simple transfert statique. Cette conception réduit le temps de récupération en cas de défaillance du réseau de quelques secondes à quelques microsecondes, permettant au système d’atteindre une « auto-réparation quasi transparente » face à l’instabilité des liaisons.
Validation en conditions réelles : le « stabilisateur » du supercalculateur
Le protocole MRC est déjà déployé dans le supercalculateur GB200 de NVIDIA et l'infrastructure cloud d'Oracle. Les données de test confirment que même lors de scénarios d'entraînement actifs, le MRC peut automatiquement contourner les perturbations — telles que la gigue soudaine des liaisons ou les redémarrages de commutateurs —, garantissant ainsi la poursuite sans interruption des tâches d'entraînement complexes.
Article connexe
 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss
Recommandations de sujets spéciaux liés
Éducation et apprentissage
 Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

 commentaires (0)
OpenAI a officiellement annoncé une collaboration avec cinq leaders du secteur — AMD, Broadcom, Intel, Microsoft et NVIDIA — en vue du lancement du protocole MRC (Multipath Reliable Connection). Ce protocole open source, publié dans le cadre de l'Open Compute Project (OCP), est conçu pour remédier aux problèmes de latence et aux pannes réseau fréquemment rencontrés lors de l'entraînement de l'IA à grande échelle.
Éliminer le « point de défaillance unique » : passer d'une architecture à trois niveaux à une architecture à deux niveaux
Dans l'entraînement traditionnel des modèles d'IA, la congestion du réseau ou une défaillance mineure sur une seule liaison peut se propager en cascade, comme des dominos, forçant des dizaines de milliers de GPU à passer en état d'inactivité et entraînant un gaspillage informatique considérable.
Afin d’améliorer fondamentalement la résilience du système, le protocole MRC introduit une conception de réseau multiplan. Il divise intelligemment une interface unique de 800 Gb/s en plusieurs liaisons plus petites. Cette optimisation structurelle permet au système de prendre en charge des clusters massifs comptant jusqu’à environ 131 000 GPU en utilisant seulement deux couches de commutation. Par rapport aux architectures traditionnelles à deux ou quatre niveaux, cette évolution réduit non seulement de manière drastique le nombre de composants physiques et la consommation d'énergie, mais diminue également considérablement les coûts de construction.
Gestion avancée du trafic : « pulvérisation » de paquets et récupération à l'échelle de la microseconde
Au-delà de la simplification architecturale, le MRC introduit une approche novatrice de la distribution du trafic. Il utilise une technologie de « pulvérisation » adaptative des paquets, s'éloignant de la transmission traditionnelle à chemin unique. Cette méthode décompose les paquets de tâches et les distribue sur des centaines de chemins parallèles. Même si les paquets arrivent dans le désordre, le récepteur peut les réassembler avec précision, empêchant ainsi efficacement la congestion localisée au sein du réseau central.
Pour le contrôle du réseau, le MRC remplace les protocoles de routage dynamique complexes (tels que le BGP) par la technologie de routage par source SRv6. Cela permet à l’expéditeur de spécifier directement le chemin, tandis que les commutateurs n’effectuent qu’un simple transfert statique. Cette conception réduit le temps de récupération en cas de défaillance du réseau de quelques secondes à quelques microsecondes, permettant au système d’atteindre une « auto-réparation quasi transparente » face à l’instabilité des liaisons.
Validation en conditions réelles : le « stabilisateur » du supercalculateur
Le protocole MRC est déjà déployé dans le supercalculateur GB200 de NVIDIA et l'infrastructure cloud d'Oracle. Les données de test confirment que même lors de scénarios d'entraînement actifs, le MRC peut automatiquement contourner les perturbations — telles que la gigue soudaine des liaisons ou les redémarrages de commutateurs —, garantissant ainsi la poursuite sans interruption des tâches d'entraînement complexes.








 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
 MiniMax dévoile un programme d’équipe 10x pour encourager les experts mondiaux en intelligence artificielle
MiniMax (Xiyu Technology), le laboratoire d’intelligence artificielle générale, a officiellement lancé « 10x Team », une initiative mondiale de collaboration avec des talents. Ce programme vise à recruter des experts de premier plan dans divers secte
 La Corée du Sud pose la première pierre du centre national de calcul en intelligence artificielle, investissant 2,5 billions de wons avec un objectif pour 2028
Le journal sud-coréen EtNews rapporte que la cérémonie de pose de la première pierre du Centre de calcul IA de Corée (KOACC) s’est tenue le 3 août au parc de centres de données Solar City à Sunan, dans la province du Jeollanam-do. Doté d’un investiss

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai












