


 家
ByteDanceの「Seedance 2.5」が公開:ストーリーを伝える30秒のワンカットAI動画
ByteDanceは、動画生成モデル「Seedance 2.5」を正式にリリースしました。これにより、1動画あたりの最大出力時間が15秒から30秒へと倍増しました。 同プラットフォームは「Ji Meng AI」および「Dou Bao Professional Edition」で順次展開され、まもなく「Volcano Argo」へのAPI統合も予定されており、映画、広告、教育、工業製造、自動運転など、多様な分野での活用が期待される。
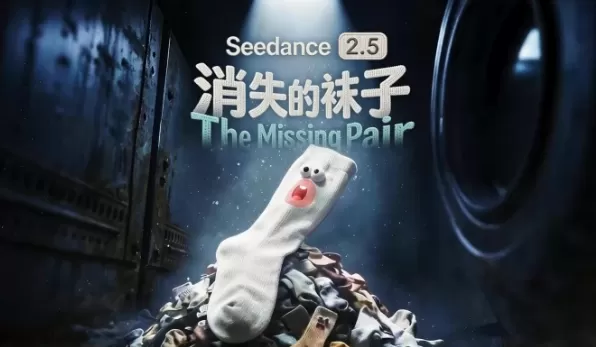
公式発表によると、「Seedance 2.5」は統一されたマルチモーダルな視聴覚アーキテクチャを維持しつつ、長編ナラティブ、マルチモーダル参照、編集精度において大幅なアップグレードを実現しています。この進化により、AI生成動画は、断片的なクリップから、明確な「序・中・結」を備えた一貫性のあるストーリーへと進化します。
30秒以内のシームレスなマルチショット・ストーリーテリングを実現し、生成範囲の拡大を通じて一貫性を確保
公式デモでは、30秒という時間枠内で複雑な物語を構築するモデルの能力が強調されている。その一例として、歌手のパフォーマンスが紹介されており、カメラは赤いカーテンの後ろから舞台裏の楽屋へと追跡する。このシーケンスでは、歌手がイヤホンを調整し、ステージの合図を受け取り、廊下を歩き、パートナーとやり取りし、最終的にステージに上がる様子が捉えられている。 カメラが引くと、観客、照明、歓声を上げる群衆を含むスタジアム全体が映し出されます。このモデルは、制限時間内に、導入、展開、クライマックス、結末という論理的に連なるショットをうまく構成することに成功しています。
このモデルの「マルチラウンド拡張」機能も同様に堅牢で、既存の映像に基づいてさらに30秒間の動画を生成することが可能です。登場人物、設定、ビジュアルスタイル、音響効果の一貫性を維持しています。 あるデモでは、サッカーボールを持った少年が地下鉄の車両から降りると、男に追われ、最終的に捕まります。この連続したアクションは、映像や物語の流れに途切れなく、シームレスに展開されます。
複雑なグループ物語のために、最大30枚の画像と10本の動画を同時に処理可能
Seedance 2.5では、ユーザーが最大30枚の画像、10本の動画クリップ、10個の音声ファイルを参照用入力としてアップロードできます。モデルはこれらの素材全体の構図、シーン、スタイル、登場人物、小道具を分析し、ユーザーの指示に従ってそれらを正確に適用します。 複数の登場人物が登場するシーンでは、メインの被写体を安定させつつ、各人物の外見や声を維持します。この機能は、ピアニスト、チェリスト、バイオリニスト、ボーカリスト、オーケストラ、合唱団、観客などを参照素材として、16:9のシネマティックフォーマットで制作された30秒のコンサートクリップで実証されました。 AI動画ツールが単純なエフェクト生成ツールから包括的な物語制作プラットフォームへと進化するにつれ、ショート動画制作のワークフローは抜本的な見直しが必要になるかもしれません。
関連記事
 Amazon、Decartを70億ドルで買収し、主要なAIチップアダプターの確保に成功
ウォール・ストリート・ジャーナル紙によると、アマゾンはAIスタートアップのDecartを買収するために交渉を行っており、その評価額は推定70億ドルに達している。競合入札がない場合、この取引はまもなく完了する可能性があり、これは継続するチップ供給制約の中で主要なテクノロジー企業が計算資源を確保することに急務であることを示している。Decartのクロスチップソフトウェアの重要性サンフランシスコを拠点とするDecartは、開発者が摩擦なく異なるハードウェア間でAIモデルを移行できるようにする互換性
Locusがロボット工学における最大の課題の一つである「マニピュレーション」にどう取り組んでいるか
NeuraGraspは、小型容器、多孔質のポリ袋、繊維製品など、さまざまな物品を扱います。 | 出典:Locus RoboticsLocus Robotics社は、実際の運用環境において数多くのロボット技術上の課題を解決してきました。同社の自律移動ロボット(AMR)は、さまざまな施設内で広範囲を移動し、60億回以上のピッキングを支援してきました。現在、同社はロボットによるマニピュレーション分野へと
マッキンゼーは、AIが労働市場を再構築する中で、1,100万人のアメリカ人が職務内容の変更やキャリアチェンジに直面すると警告している
マッキンゼーが9月29日に発表したAIと雇用に関する報告書は、重要な課題として、雇用の喪失ではなく、数百万人の労働者を新たな職務に再配置するという膨大な課題を浮き彫りにしている。2035年までに、AIによって現在の仕事が自動化されることで、推定1,100万人の米国労働者(現在の労働力の約7%)が転職を余儀なくされる可能性がある。これは、年間平均21万5,000人という過去の転職者数から劇的な変化を
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
ByteDanceは、動画生成モデル「Seedance 2.5」を正式にリリースしました。これにより、1動画あたりの最大出力時間が15秒から30秒へと倍増しました。 同プラットフォームは「Ji Meng AI」および「Dou Bao Professional Edition」で順次展開され、まもなく「Volcano Argo」へのAPI統合も予定されており、映画、広告、教育、工業製造、自動運転など、多様な分野での活用が期待される。
公式発表によると、「Seedance 2.5」は統一されたマルチモーダルな視聴覚アーキテクチャを維持しつつ、長編ナラティブ、マルチモーダル参照、編集精度において大幅なアップグレードを実現しています。この進化により、AI生成動画は、断片的なクリップから、明確な「序・中・結」を備えた一貫性のあるストーリーへと進化します。
30秒以内のシームレスなマルチショット・ストーリーテリングを実現し、生成範囲の拡大を通じて一貫性を確保
公式デモでは、30秒という時間枠内で複雑な物語を構築するモデルの能力が強調されている。その一例として、歌手のパフォーマンスが紹介されており、カメラは赤いカーテンの後ろから舞台裏の楽屋へと追跡する。このシーケンスでは、歌手がイヤホンを調整し、ステージの合図を受け取り、廊下を歩き、パートナーとやり取りし、最終的にステージに上がる様子が捉えられている。 カメラが引くと、観客、照明、歓声を上げる群衆を含むスタジアム全体が映し出されます。このモデルは、制限時間内に、導入、展開、クライマックス、結末という論理的に連なるショットをうまく構成することに成功しています。
このモデルの「マルチラウンド拡張」機能も同様に堅牢で、既存の映像に基づいてさらに30秒間の動画を生成することが可能です。登場人物、設定、ビジュアルスタイル、音響効果の一貫性を維持しています。 あるデモでは、サッカーボールを持った少年が地下鉄の車両から降りると、男に追われ、最終的に捕まります。この連続したアクションは、映像や物語の流れに途切れなく、シームレスに展開されます。
複雑なグループ物語のために、最大30枚の画像と10本の動画を同時に処理可能
Seedance 2.5では、ユーザーが最大30枚の画像、10本の動画クリップ、10個の音声ファイルを参照用入力としてアップロードできます。モデルはこれらの素材全体の構図、シーン、スタイル、登場人物、小道具を分析し、ユーザーの指示に従ってそれらを正確に適用します。 複数の登場人物が登場するシーンでは、メインの被写体を安定させつつ、各人物の外見や声を維持します。この機能は、ピアニスト、チェリスト、バイオリニスト、ボーカリスト、オーケストラ、合唱団、観客などを参照素材として、16:9のシネマティックフォーマットで制作された30秒のコンサートクリップで実証されました。 AI動画ツールが単純なエフェクト生成ツールから包括的な物語制作プラットフォームへと進化するにつれ、ショート動画制作のワークフローは抜本的な見直しが必要になるかもしれません。








 Amazon、Decartを70億ドルで買収し、主要なAIチップアダプターの確保に成功
ウォール・ストリート・ジャーナル紙によると、アマゾンはAIスタートアップのDecartを買収するために交渉を行っており、その評価額は推定70億ドルに達している。競合入札がない場合、この取引はまもなく完了する可能性があり、これは継続するチップ供給制約の中で主要なテクノロジー企業が計算資源を確保することに急務であることを示している。Decartのクロスチップソフトウェアの重要性サンフランシスコを拠点とするDecartは、開発者が摩擦なく異なるハードウェア間でAIモデルを移行できるようにする互換性
Locusがロボット工学における最大の課題の一つである「マニピュレーション」にどう取り組んでいるか
NeuraGraspは、小型容器、多孔質のポリ袋、繊維製品など、さまざまな物品を扱います。 | 出典:Locus RoboticsLocus Robotics社は、実際の運用環境において数多くのロボット技術上の課題を解決してきました。同社の自律移動ロボット(AMR)は、さまざまな施設内で広範囲を移動し、60億回以上のピッキングを支援してきました。現在、同社はロボットによるマニピュレーション分野へと
マッキンゼーは、AIが労働市場を再構築する中で、1,100万人のアメリカ人が職務内容の変更やキャリアチェンジに直面すると警告している
マッキンゼーが9月29日に発表したAIと雇用に関する報告書は、重要な課題として、雇用の喪失ではなく、数百万人の労働者を新たな職務に再配置するという膨大な課題を浮き彫りにしている。2035年までに、AIによって現在の仕事が自動化されることで、推定1,100万人の米国労働者(現在の労働力の約7%)が転職を余儀なくされる可能性がある。これは、年間平均21万5,000人という過去の転職者数から劇的な変化を

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












