


 Hogar
ByteDance presenta Seedance 2.5: un vídeo de 30 segundos grabado en una sola toma y creado con IA que cuenta una historia
ByteDance ha lanzado oficialmente Seedance 2.5, un modelo de generación de vídeos que duplica la duración máxima de salida, pasando de 15 a 30 segundos por vídeo. La plataforma se implantará gradualmente en Ji Meng AI y Dou Bao Professional Edition, y está prevista en breve la integración de la API en Volcano Argo para dar soporte a diversas aplicaciones en los ámbitos del cine, la publicidad, la educación, la fabricación industrial y la conducción autónoma.
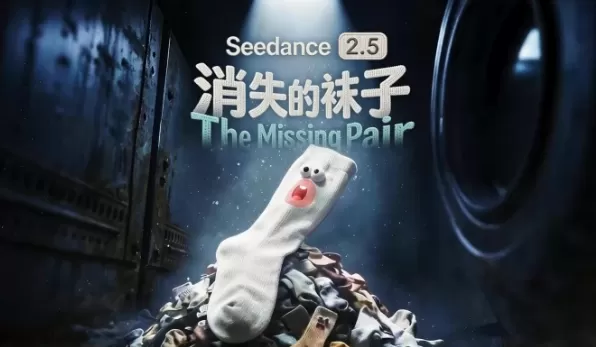
Según el comunicado oficial, Seedance 2.5 conserva su arquitectura audiovisual multimodal unificada, al tiempo que ofrece mejoras significativas en la narrativa de formato largo, las referencias multimodales y la precisión en la edición. Este avance permite que los vídeos generados por IA pasen de ser clips aislados a historias coherentes con un principio, un desarrollo y un final claros.
Narrativa fluida con múltiples tomas en 30 segundos, lo que garantiza la coherencia mediante la generación ampliada
Las demostraciones oficiales destacan la capacidad del modelo para estructurar narrativas complejas en un intervalo de 30 segundos. Un ejemplo muestra la actuación de una cantante, con la cámara siguiendo su recorrido desde detrás de unas cortinas rojas hasta un camerino entre bastidores. La secuencia capta a la cantante ajustándose los auriculares, recibiendo indicaciones escénicas, caminando por un pasillo, interactuando con un compañero y, finalmente, subiendo al escenario. La cámara se aleja para mostrar todo el estadio, incluyendo al público, la iluminación y la multitud que vitorea. El modelo organiza con éxito tomas lógicamente conectadas —exposición, desarrollo, clímax y desenlace— dentro del límite de tiempo.
La función de extensión de varias rondas del modelo es igualmente sólida, ya que le permite generar 30 segundos adicionales de vídeo a partir del metraje existente. Mantiene la coherencia en los personajes, los escenarios, el estilo visual y los efectos de audio. En una demostración, un niño sale de un vagón de metro con un balón de fútbol, perseguido por un hombre que finalmente lo alcanza. La acción continua fluye a la perfección, sin interrupciones visuales ni narrativas.
Procesa hasta 30 imágenes y 10 vídeos simultáneamente para narrativas grupales complejas
Seedance 2.5 permite a los usuarios cargar hasta 30 imágenes, 10 clips de vídeo y 10 archivos de audio como entradas de referencia. El modelo analiza la composición, las escenas, los estilos, los personajes y el atrezo de estos materiales, aplicándolos con precisión según las instrucciones del usuario. En escenas con varios personajes, conserva la apariencia y la voz de cada individuo, al tiempo que mantiene estable al sujeto principal. Un clip de concierto de 30 segundos demostró esta capacidad, utilizando un formato cinematográfico 16:9 con referencias que incluían un pianista, un violonchelista, un violinista, un vocalista, una orquesta, un coro y el público. A medida que las herramientas de vídeo basadas en IA evolucionan desde simples generadores de efectos hasta plataformas narrativas integrales, el flujo de trabajo para la producción de vídeos cortos podría requerir una revisión completa.
Artículo relacionado
 Amazon adquirirá Decart por 7.000 millones de dólares, asegurando un adaptador clave de chips de inteligencia artificial
Según el Wall Street Journal, Amazon está negociando para adquirir la startup de inteligencia artificial Decart con una valoración estimada de 7000 millones de dólares. Si no surgen ofertas competitivas, la transacción podría cerrarse pronto, lo que
Cómo aborda Locus uno de los mayores retos de la robótica: la manipulación
NeuraGrasp maneja diversos artículos, entre los que se incluyen pequeños envases, bolsas de plástico porosas y textiles. | Fuente: Locus RoboticsLocus Robotics Corp. ha superado numerosos obstáculos r
McKinsey advierte que 11 millones de estadounidenses enfrentan cambios laborales o transiciones profesionales a medida que la IA transforma la fuerza laboral
El informe de McKinsey del 29 de septiembre sobre la inteligencia artificial y el empleo destaca un desafío crítico: no es el desplazamiento laboral, sino la enorme tarea de recolocar a millones de trabajadores en nuevos roles.Para 2035, se estima q
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
ByteDance ha lanzado oficialmente Seedance 2.5, un modelo de generación de vídeos que duplica la duración máxima de salida, pasando de 15 a 30 segundos por vídeo. La plataforma se implantará gradualmente en Ji Meng AI y Dou Bao Professional Edition, y está prevista en breve la integración de la API en Volcano Argo para dar soporte a diversas aplicaciones en los ámbitos del cine, la publicidad, la educación, la fabricación industrial y la conducción autónoma.
Según el comunicado oficial, Seedance 2.5 conserva su arquitectura audiovisual multimodal unificada, al tiempo que ofrece mejoras significativas en la narrativa de formato largo, las referencias multimodales y la precisión en la edición. Este avance permite que los vídeos generados por IA pasen de ser clips aislados a historias coherentes con un principio, un desarrollo y un final claros.
Narrativa fluida con múltiples tomas en 30 segundos, lo que garantiza la coherencia mediante la generación ampliada
Las demostraciones oficiales destacan la capacidad del modelo para estructurar narrativas complejas en un intervalo de 30 segundos. Un ejemplo muestra la actuación de una cantante, con la cámara siguiendo su recorrido desde detrás de unas cortinas rojas hasta un camerino entre bastidores. La secuencia capta a la cantante ajustándose los auriculares, recibiendo indicaciones escénicas, caminando por un pasillo, interactuando con un compañero y, finalmente, subiendo al escenario. La cámara se aleja para mostrar todo el estadio, incluyendo al público, la iluminación y la multitud que vitorea. El modelo organiza con éxito tomas lógicamente conectadas —exposición, desarrollo, clímax y desenlace— dentro del límite de tiempo.
La función de extensión de varias rondas del modelo es igualmente sólida, ya que le permite generar 30 segundos adicionales de vídeo a partir del metraje existente. Mantiene la coherencia en los personajes, los escenarios, el estilo visual y los efectos de audio. En una demostración, un niño sale de un vagón de metro con un balón de fútbol, perseguido por un hombre que finalmente lo alcanza. La acción continua fluye a la perfección, sin interrupciones visuales ni narrativas.
Procesa hasta 30 imágenes y 10 vídeos simultáneamente para narrativas grupales complejas
Seedance 2.5 permite a los usuarios cargar hasta 30 imágenes, 10 clips de vídeo y 10 archivos de audio como entradas de referencia. El modelo analiza la composición, las escenas, los estilos, los personajes y el atrezo de estos materiales, aplicándolos con precisión según las instrucciones del usuario. En escenas con varios personajes, conserva la apariencia y la voz de cada individuo, al tiempo que mantiene estable al sujeto principal. Un clip de concierto de 30 segundos demostró esta capacidad, utilizando un formato cinematográfico 16:9 con referencias que incluían un pianista, un violonchelista, un violinista, un vocalista, una orquesta, un coro y el público. A medida que las herramientas de vídeo basadas en IA evolucionan desde simples generadores de efectos hasta plataformas narrativas integrales, el flujo de trabajo para la producción de vídeos cortos podría requerir una revisión completa.








 Amazon adquirirá Decart por 7.000 millones de dólares, asegurando un adaptador clave de chips de inteligencia artificial
Según el Wall Street Journal, Amazon está negociando para adquirir la startup de inteligencia artificial Decart con una valoración estimada de 7000 millones de dólares. Si no surgen ofertas competitivas, la transacción podría cerrarse pronto, lo que
Cómo aborda Locus uno de los mayores retos de la robótica: la manipulación
NeuraGrasp maneja diversos artículos, entre los que se incluyen pequeños envases, bolsas de plástico porosas y textiles. | Fuente: Locus RoboticsLocus Robotics Corp. ha superado numerosos obstáculos r
McKinsey advierte que 11 millones de estadounidenses enfrentan cambios laborales o transiciones profesionales a medida que la IA transforma la fuerza laboral
El informe de McKinsey del 29 de septiembre sobre la inteligencia artificial y el empleo destaca un desafío crítico: no es el desplazamiento laboral, sino la enorme tarea de recolocar a millones de trabajadores en nuevos roles.Para 2035, se estima q

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












