


 Lar
ByteDance Seedance 2.5 é apresentado: vídeo de 30 segundos gravado em uma única tomada com IA que conta uma história
A ByteDance lançou oficialmente o Seedance 2.5, um modelo de geração de vídeo que dobra a duração máxima de saída de 15 para 30 segundos por vídeo. A plataforma será implementada gradualmente no Ji Meng AI e no Dou Bao Professional Edition, com integração de API ao Volcano Argo prevista para breve, a fim de oferecer suporte a diversas aplicações nos setores de cinema, publicidade, educação, manufatura industrial e direção autônoma.
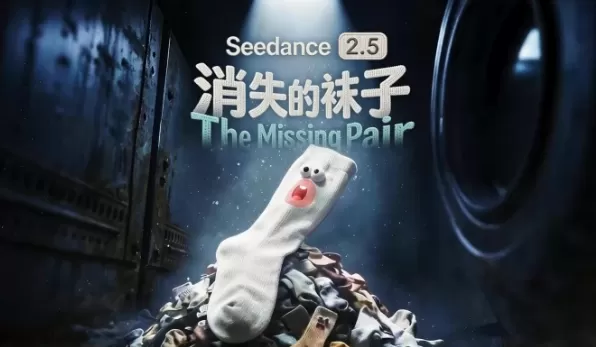
De acordo com o anúncio oficial, o Seedance 2.5 mantém sua arquitetura audiovisual multimodal unificada, ao mesmo tempo em que oferece melhorias significativas na narrativa de longa duração, nas referências multimodais e na precisão da edição. Esse avanço permite que os vídeos gerados por IA passem de clipes isolados para histórias coesas, com início, meio e fim bem definidos.
Narração fluida com múltiplas tomadas em 30 segundos, garantindo consistência por meio da geração prolongada
Demonstrações oficiais destacam a capacidade do modelo de estruturar narrativas complexas em um intervalo de 30 segundos. Um exemplo mostra a apresentação de uma cantora, acompanhando a câmera por trás de cortinas vermelhas até um camarim nos bastidores. A sequência captura a cantora ajustando seus fones de ouvido, recebendo orientações do palco, caminhando por um corredor, interagindo com um parceiro e, finalmente, subindo ao palco. A câmera se afasta para revelar o estádio inteiro, incluindo o público, a iluminação e a torcida animada. O modelo organiza com sucesso tomadas logicamente conectadas — introdução, desenvolvimento, clímax e resolução — dentro do limite de tempo.
O recurso de extensão em várias rodadas do modelo é igualmente robusto, permitindo que ele gere 30 segundos adicionais de vídeo com base nas imagens existentes. Ele mantém a consistência em personagens, cenários, estilo visual e efeitos sonoros. Em uma demonstração, um menino sai de um vagão de metrô com uma bola de futebol, perseguido por um homem que acaba por alcançá-lo. A ação contínua flui perfeitamente, sem interrupções visuais ou narrativas.
Processe até 30 imagens e 10 vídeos simultaneamente para narrativas complexas em grupo
O Seedance 2.5 permite que os usuários enviem até 30 imagens, 10 clipes de vídeo e 10 arquivos de áudio como entradas de referência. O modelo analisa composição, cenas, estilos, personagens e adereços nesses materiais, aplicando-os com precisão de acordo com as instruções do usuário. Em cenas com vários personagens, ele preserva a aparência e a voz de cada indivíduo, mantendo o sujeito principal estável. Um clipe de concerto de 30 segundos demonstrou essa capacidade, utilizando um formato cinematográfico 16:9 com referências que incluíam um pianista, um violoncelista, um violinista, um vocalista, uma orquestra, um coro e o público. À medida que as ferramentas de vídeo baseadas em IA evoluem de simples geradores de efeitos para plataformas narrativas abrangentes, o fluxo de trabalho para a produção de vídeos curtos pode exigir uma reformulação completa.
Artigo relacionado
 A Amazon adquirirá a Decart por US$ 7 bilhões, garantindo um adaptador-chave de chips de IA
De acordo com o Wall Street Journal, a Amazon está negociando a compra da startup de inteligência artificial Decart por uma avaliação estimada de US$ 7 bilhões. Se não surgirem lances concorrentes, a transação pode ser concluída em breve, destacando
Como o Locus enfrenta um dos maiores desafios da robótica: a manipulação
O NeuraGrasp manuseia diversos itens, incluindo pequenos recipientes, sacos plásticos porosos e tecidos. | Fonte: Locus RoboticsA Locus Robotics Corp. superou inúmeros desafios robóticos em ambientes
A McKinsey alerta que 11 milhões de americanos enfrentam mudanças de emprego ou transições de carreira à medida que a IA remodela a força de trabalho
O relatório da McKinsey de 29 de setembro sobre IA e emprego destaca um desafio crítico: não o deslocamento de empregos, mas a enorme tarefa de realocar milhões de trabalhadores em novos cargos.Até 2035, estima-se que 11 milhões de trabalhadores dos
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A ByteDance lançou oficialmente o Seedance 2.5, um modelo de geração de vídeo que dobra a duração máxima de saída de 15 para 30 segundos por vídeo. A plataforma será implementada gradualmente no Ji Meng AI e no Dou Bao Professional Edition, com integração de API ao Volcano Argo prevista para breve, a fim de oferecer suporte a diversas aplicações nos setores de cinema, publicidade, educação, manufatura industrial e direção autônoma.
De acordo com o anúncio oficial, o Seedance 2.5 mantém sua arquitetura audiovisual multimodal unificada, ao mesmo tempo em que oferece melhorias significativas na narrativa de longa duração, nas referências multimodais e na precisão da edição. Esse avanço permite que os vídeos gerados por IA passem de clipes isolados para histórias coesas, com início, meio e fim bem definidos.
Narração fluida com múltiplas tomadas em 30 segundos, garantindo consistência por meio da geração prolongada
Demonstrações oficiais destacam a capacidade do modelo de estruturar narrativas complexas em um intervalo de 30 segundos. Um exemplo mostra a apresentação de uma cantora, acompanhando a câmera por trás de cortinas vermelhas até um camarim nos bastidores. A sequência captura a cantora ajustando seus fones de ouvido, recebendo orientações do palco, caminhando por um corredor, interagindo com um parceiro e, finalmente, subindo ao palco. A câmera se afasta para revelar o estádio inteiro, incluindo o público, a iluminação e a torcida animada. O modelo organiza com sucesso tomadas logicamente conectadas — introdução, desenvolvimento, clímax e resolução — dentro do limite de tempo.
O recurso de extensão em várias rodadas do modelo é igualmente robusto, permitindo que ele gere 30 segundos adicionais de vídeo com base nas imagens existentes. Ele mantém a consistência em personagens, cenários, estilo visual e efeitos sonoros. Em uma demonstração, um menino sai de um vagão de metrô com uma bola de futebol, perseguido por um homem que acaba por alcançá-lo. A ação contínua flui perfeitamente, sem interrupções visuais ou narrativas.
Processe até 30 imagens e 10 vídeos simultaneamente para narrativas complexas em grupo
O Seedance 2.5 permite que os usuários enviem até 30 imagens, 10 clipes de vídeo e 10 arquivos de áudio como entradas de referência. O modelo analisa composição, cenas, estilos, personagens e adereços nesses materiais, aplicando-os com precisão de acordo com as instruções do usuário. Em cenas com vários personagens, ele preserva a aparência e a voz de cada indivíduo, mantendo o sujeito principal estável. Um clipe de concerto de 30 segundos demonstrou essa capacidade, utilizando um formato cinematográfico 16:9 com referências que incluíam um pianista, um violoncelista, um violinista, um vocalista, uma orquestra, um coro e o público. À medida que as ferramentas de vídeo baseadas em IA evoluem de simples geradores de efeitos para plataformas narrativas abrangentes, o fluxo de trabalho para a produção de vídeos curtos pode exigir uma reformulação completa.








 A Amazon adquirirá a Decart por US$ 7 bilhões, garantindo um adaptador-chave de chips de IA
De acordo com o Wall Street Journal, a Amazon está negociando a compra da startup de inteligência artificial Decart por uma avaliação estimada de US$ 7 bilhões. Se não surgirem lances concorrentes, a transação pode ser concluída em breve, destacando
Como o Locus enfrenta um dos maiores desafios da robótica: a manipulação
O NeuraGrasp manuseia diversos itens, incluindo pequenos recipientes, sacos plásticos porosos e tecidos. | Fonte: Locus RoboticsA Locus Robotics Corp. superou inúmeros desafios robóticos em ambientes
A McKinsey alerta que 11 milhões de americanos enfrentam mudanças de emprego ou transições de carreira à medida que a IA remodela a força de trabalho
O relatório da McKinsey de 29 de setembro sobre IA e emprego destaca um desafio crítico: não o deslocamento de empregos, mas a enorme tarefa de realocar milhões de trabalhadores em novos cargos.Até 2035, estima-se que 11 milhões de trabalhadores dos

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












