


 Hogar
La ejecución de modelos de IA se convierte en un reto para la memoria
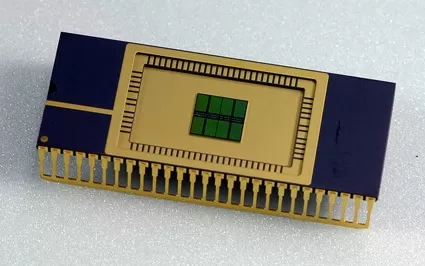
Los debates sobre los costes de la infraestructura de IA suelen centrarse en Nvidia y las GPU, pero la memoria se está convirtiendo en una pieza fundamental del rompecabezas. Dado que los hiperescaladores están invirtiendo miles de millones en nuevos centros de datos, los precios de los chips DRAM se han multiplicado por siete aproximadamente en el último año.
Al mismo tiempo, una disciplina en auge se centra en coordinar esta memoria para garantizar que los datos correctos lleguen al agente de IA adecuado en el momento oportuno. Las empresas que destacan en esto pueden ejecutar las mismas consultas utilizando menos tokens, una diferencia que puede determinar la supervivencia en un mercado competitivo.
El analista de semiconductores Dan O’Laughlin ofrece una perspectiva convincente sobre la importancia de los chips de memoria en su Substack, donde incluye una conversación con Val Bercovici, director de IA de Weka. Ambos expertos provienen del sector de los semiconductores, por lo que su debate se inclina hacia el hardware, aunque las implicaciones para el software de IA son igualmente significativas.
Destaca un pasaje en el que Bercovici comenta la creciente complejidad de la documentación sobre el almacenamiento en caché de prompts de Anthropic:
La clave está en la página de precios del almacenamiento en caché de prompts de Anthropic. Empezó como una página sencilla hace seis o siete meses, especialmente en torno al lanzamiento de Claude Code, que básicamente decía: «Usa el almacenamiento en caché, es más barato». Ahora, parece una enciclopedia de consejos sobre cuántas escrituras en caché hay que comprar por adelantado. Se ven los niveles habituales del sector, como ventanas de 5 minutos y de 1 hora, pero nada más largo. Ese es un detalle revelador. Luego, por supuesto, hay varias oportunidades de arbitraje en torno a los precios de lectura de la caché en función de cuántas escrituras en caché hayas comprado por adelantado.
La pregunta fundamental es cuánto tiempo retiene Claude tu solicitud en la memoria caché. Puedes pagar por un intervalo de 5 minutos o por uno más caro de una hora. Acceder a los datos que aún están en la caché es mucho más barato, por lo que una gestión eficaz puede suponer un ahorro sustancial. Sin embargo, hay una trampa: cada nuevo dato añadido a una consulta podría desplazar a otro de la caché.
Aunque los detalles son complejos, la conclusión es clara: la gestión de la memoria dentro de los modelos de IA será un factor clave en el futuro de la IA. Las empresas que la dominen obtendrán una ventaja competitiva significativa.
Hay un margen considerable para el progreso en este campo emergente. El pasado octubre escribí sobre una startup llamada TensorMesh, que está trabajando en una capa de la pila conocida como optimización de la caché.
Evento de TechCrunchTechCrunch Founder Summit 2026: Entradas a la venta
El 23 de junio en Boston, más de 1100 fundadores se reunirán en la TechCrunch Founder Summit 2026 para un día completo centrado en el crecimiento, la ejecución y la escalabilidad en el mundo real. Aprende de fundadores e inversores que han dado forma al sector. Conecta con compañeros que atraviesan etapas de crecimiento similares. Llévate tácticas que puedas aplicar de inmediato
Ahorra hasta 300 $ en tu pase o hasta un 30 % con entradas de grupo para equipos de cuatro o más personas.
TechCrunch Founder Summit: Entradas a la venta
El 23 de junio en Boston, más de 1100 fundadores se darán cita en la TechCrunch Founder Summit 2026 para una jornada completa centrada en el crecimiento, la ejecución y la escalabilidad en el mundo real. Aprende de fundadores e inversores que han marcado el rumbo del sector. Conecta con compañeros que se encuentran en etapas de crecimiento similares. Llévate estrategias que podrás aplicar de inmediato
Ahorra hasta 300 $ en tu pase o ahorra hasta un 30 % con entradas de grupo para equipos de cuatro o más personas.
Boston, MA | 23 de junio de 2026 INSCRÍBETE AHORATambién existen oportunidades en otras partes de la pila. Más abajo, por ejemplo, se plantea la cuestión de cómo los centros de datos utilizan sus diferentes tipos de memoria. (La entrevista incluye un debate revelador sobre cuándo utilizar chips DRAM frente a HBM, aunque se vuelve bastante técnico). Más arriba en la pila, los usuarios finales están aprendiendo a estructurar sus enjambres de modelos para aprovechar eficazmente las cachés compartidas.
A medida que las empresas mejoren en la orquestación de la memoria, consumirán menos tokens, lo que abaratará la inferencia. Al mismo tiempo, los modelos se están volviendo más eficientes en el procesamiento de cada token, lo que reduce los costes aún más. A medida que disminuyan los gastos en servidores, muchas aplicaciones que actualmente se consideran inviables comenzarán a acercarse a la rentabilidad.
Artículo relacionado
 El inicio de inteligencia artificial del ex director ejecutivo de Infosys asegura otros 53 millones de dólares
Hang Ten Systems, una startup de inteligencia artificial fundada por el ex CEO de Infosys, Vishal Sikka, hace apenas cuatro meses, ha asegurado $53 millones adicionales en financiación semilla. Esta última ronda de inversión se cerró apenas cinco sem
La plataforma de intercambio de criptomonedas OKX pretende permitir que los agentes de IA se contraten y se paguen entre sí
A medida que los agentes de IA comienzan a prestar servicio a particulares y a colaborar entre sí, necesitan mecanismos para identificar tareas, recibir una compensación por sus servicios y establecer
Una startup respaldada por Thiel afirma que la inteligencia artificial puede evaluar el periodismo, a pesar de los riesgos que esto supone para los denunciantes
Tras su participación en la demanda que provocó la quiebra de Gawker, Aron D’Souza detectó una falla fundamental en el panorama mediático estadounidense: las personas perjudicadas por la cobertura med
Recomendaciones de temas especiales relacionados
SEO
 Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
 13 herramientas
 xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

 comentario (1)
0/500
![NicholasNelson]()
這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔
Los debates sobre los costes de la infraestructura de IA suelen centrarse en Nvidia y las GPU, pero la memoria se está convirtiendo en una pieza fundamental del rompecabezas. Dado que los hiperescaladores están invirtiendo miles de millones en nuevos centros de datos, los precios de los chips DRAM se han multiplicado por siete aproximadamente en el último año.
Al mismo tiempo, una disciplina en auge se centra en coordinar esta memoria para garantizar que los datos correctos lleguen al agente de IA adecuado en el momento oportuno. Las empresas que destacan en esto pueden ejecutar las mismas consultas utilizando menos tokens, una diferencia que puede determinar la supervivencia en un mercado competitivo.
El analista de semiconductores Dan O’Laughlin ofrece una perspectiva convincente sobre la importancia de los chips de memoria en su Substack, donde incluye una conversación con Val Bercovici, director de IA de Weka. Ambos expertos provienen del sector de los semiconductores, por lo que su debate se inclina hacia el hardware, aunque las implicaciones para el software de IA son igualmente significativas.
Destaca un pasaje en el que Bercovici comenta la creciente complejidad de la documentación sobre el almacenamiento en caché de prompts de Anthropic:
La clave está en la página de precios del almacenamiento en caché de prompts de Anthropic. Empezó como una página sencilla hace seis o siete meses, especialmente en torno al lanzamiento de Claude Code, que básicamente decía: «Usa el almacenamiento en caché, es más barato». Ahora, parece una enciclopedia de consejos sobre cuántas escrituras en caché hay que comprar por adelantado. Se ven los niveles habituales del sector, como ventanas de 5 minutos y de 1 hora, pero nada más largo. Ese es un detalle revelador. Luego, por supuesto, hay varias oportunidades de arbitraje en torno a los precios de lectura de la caché en función de cuántas escrituras en caché hayas comprado por adelantado.
La pregunta fundamental es cuánto tiempo retiene Claude tu solicitud en la memoria caché. Puedes pagar por un intervalo de 5 minutos o por uno más caro de una hora. Acceder a los datos que aún están en la caché es mucho más barato, por lo que una gestión eficaz puede suponer un ahorro sustancial. Sin embargo, hay una trampa: cada nuevo dato añadido a una consulta podría desplazar a otro de la caché.
Aunque los detalles son complejos, la conclusión es clara: la gestión de la memoria dentro de los modelos de IA será un factor clave en el futuro de la IA. Las empresas que la dominen obtendrán una ventaja competitiva significativa.
Hay un margen considerable para el progreso en este campo emergente. El pasado octubre escribí sobre una startup llamada TensorMesh, que está trabajando en una capa de la pila conocida como optimización de la caché.
Evento de TechCrunchTechCrunch Founder Summit 2026: Entradas a la venta
El 23 de junio en Boston, más de 1100 fundadores se reunirán en la TechCrunch Founder Summit 2026 para un día completo centrado en el crecimiento, la ejecución y la escalabilidad en el mundo real. Aprende de fundadores e inversores que han dado forma al sector. Conecta con compañeros que atraviesan etapas de crecimiento similares. Llévate tácticas que puedas aplicar de inmediato
Ahorra hasta 300 $ en tu pase o hasta un 30 % con entradas de grupo para equipos de cuatro o más personas.
TechCrunch Founder Summit: Entradas a la venta
El 23 de junio en Boston, más de 1100 fundadores se darán cita en la TechCrunch Founder Summit 2026 para una jornada completa centrada en el crecimiento, la ejecución y la escalabilidad en el mundo real. Aprende de fundadores e inversores que han marcado el rumbo del sector. Conecta con compañeros que se encuentran en etapas de crecimiento similares. Llévate estrategias que podrás aplicar de inmediato
Ahorra hasta 300 $ en tu pase o ahorra hasta un 30 % con entradas de grupo para equipos de cuatro o más personas.
Boston, MA | 23 de junio de 2026 INSCRÍBETE AHORATambién existen oportunidades en otras partes de la pila. Más abajo, por ejemplo, se plantea la cuestión de cómo los centros de datos utilizan sus diferentes tipos de memoria. (La entrevista incluye un debate revelador sobre cuándo utilizar chips DRAM frente a HBM, aunque se vuelve bastante técnico). Más arriba en la pila, los usuarios finales están aprendiendo a estructurar sus enjambres de modelos para aprovechar eficazmente las cachés compartidas.
A medida que las empresas mejoren en la orquestación de la memoria, consumirán menos tokens, lo que abaratará la inferencia. Al mismo tiempo, los modelos se están volviendo más eficientes en el procesamiento de cada token, lo que reduce los costes aún más. A medida que disminuyan los gastos en servidores, muchas aplicaciones que actualmente se consideran inviables comenzarán a acercarse a la rentabilidad.








 El inicio de inteligencia artificial del ex director ejecutivo de Infosys asegura otros 53 millones de dólares
Hang Ten Systems, una startup de inteligencia artificial fundada por el ex CEO de Infosys, Vishal Sikka, hace apenas cuatro meses, ha asegurado $53 millones adicionales en financiación semilla. Esta última ronda de inversión se cerró apenas cinco sem
 La plataforma de intercambio de criptomonedas OKX pretende permitir que los agentes de IA se contraten y se paguen entre sí
A medida que los agentes de IA comienzan a prestar servicio a particulares y a colaborar entre sí, necesitan mecanismos para identificar tareas, recibir una compensación por sus servicios y establecer
 Una startup respaldada por Thiel afirma que la inteligencia artificial puede evaluar el periodismo, a pesar de los riesgos que esto supone para los denunciantes
Tras su participación en la demanda que provocó la quiebra de Gawker, Aron D’Souza detectó una falla fundamental en el panorama mediático estadounidense: las personas perjudicadas por la cobertura med

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔












