


 Lar
A execução de modelos de IA torna-se um desafio de memória
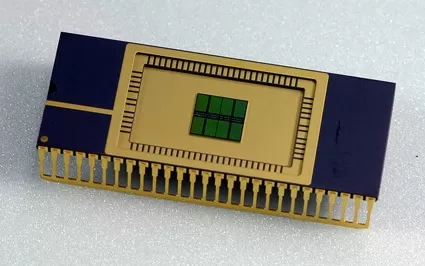
As discussões sobre os custos da infraestrutura de IA costumam girar em torno da Nvidia e das GPUs, mas a memória está se tornando uma peça fundamental do quebra-cabeça. Com os hyperscalers investindo bilhões em novos data centers, os preços dos chips de DRAM dispararam cerca de sete vezes no último ano.
Simultaneamente, uma disciplina em ascensão se concentra em orquestrar essa memória para garantir que os dados certos cheguem ao agente de IA certo no momento certo. Empresas que se destacam nisso podem executar as mesmas consultas usando menos tokens — uma diferença que pode determinar a sobrevivência em um mercado competitivo.
O analista de semicondutores Dan O’Laughlin oferece uma perspectiva convincente sobre a importância dos chips de memória em seu Substack, apresentando uma conversa com Val Bercovici, diretor de IA da Weka. Ambos os especialistas têm formação em semicondutores, então sua discussão se inclina para o hardware, embora as implicações para o software de IA sejam igualmente significativas.
Uma passagem se destacou, na qual Bercovici comenta sobre a crescente complexidade da documentação de cache de prompts da Anthropic:
A pista está na página de preços de armazenamento em cache de prompts da Anthropic. Ela começou como uma página simples há seis ou sete meses, especialmente por volta do lançamento do Claude Code, dizendo essencialmente: “Use o armazenamento em cache, é mais barato”. Agora, parece uma enciclopédia de conselhos sobre quantas gravações em cache comprar antecipadamente. Você vê níveis comuns do setor, como janelas de 5 minutos e 1 hora — mas nada mais longo. Esse é um detalhe revelador. Então, é claro, há várias oportunidades de arbitragem em torno dos preços de leitura do cache com base em quantas gravações em cache você comprou antecipadamente.
A questão central é por quanto tempo o Claude retém sua solicitação na memória em cache. Você pode pagar por uma janela de 5 minutos ou por uma janela mais cara de 1 hora. Acessar dados ainda no cache é muito mais barato, então um gerenciamento eficaz pode levar a economias substanciais. No entanto, há uma pegadinha: cada novo dado adicionado a uma consulta pode deslocar outra coisa do cache.
Embora os detalhes sejam complexos, a conclusão é direta: o gerenciamento de memória dentro dos modelos de IA será um fator importante no futuro da IA. As empresas que dominarem isso ganharão uma vantagem competitiva significativa.
Há um espaço considerável para progresso neste campo emergente. Em outubro passado, escrevi sobre uma startup chamada TensorMesh, que está trabalhando em uma camada da pilha conhecida como otimização de cache.
Evento TechCrunchTechCrunch Founder Summit 2026: Ingressos à venda
No dia 23 de junho, em Boston, mais de 1.100 fundadores se reunirão no TechCrunch Founder Summit 2026 para um dia inteiro focado em crescimento, execução e escalabilidade no mundo real. Aprenda com fundadores e investidores que moldaram o setor. Conecte-se com colegas que estão passando por fases de crescimento semelhantes. Saia de lá com táticas que você pode aplicar imediatamente
Economize até US$ 300 no seu passe ou até 30% com ingressos em grupo para equipes de quatro ou mais pessoas.
TechCrunch Founder Summit: Ingressos à venda
No dia 23 de junho, em Boston, mais de 1.100 fundadores se reúnem no TechCrunch Founder Summit 2026 para um dia inteiro dedicado ao crescimento, à execução e à escalabilidade no mundo real. Aprenda com fundadores e investidores que moldaram o setor. Conecte-se com colegas que estão passando por fases de crescimento semelhantes. Saia com táticas que você pode aplicar imediatamente
Economize até US$ 300 no seu passe ou economize até 30% com ingressos para grupos de quatro ou mais pessoas.
Boston, MA | 23 de junho de 2026 INSCRIVA-SE AGORATambém existem oportunidades em outras partes da pilha. Mais abaixo, por exemplo, está a questão de como os data centers utilizam seus diferentes tipos de memória. (A entrevista inclui uma discussão perspicaz sobre quando usar chips DRAM em vez de HBM, embora se torne bastante técnica.) Mais acima na pilha, os usuários finais estão aprendendo a estruturar seus enxames de modelos para aproveitar caches compartilhados de forma eficaz.
À medida que as empresas melhoram na orquestração de memória, elas consumirão menos tokens, tornando a inferência mais barata. Ao mesmo tempo, os modelos estão se tornando mais eficientes no processamento de cada token, reduzindo ainda mais os custos. À medida que as despesas com servidores diminuem, muitas aplicações atualmente consideradas inviáveis começarão a se aproximar da lucratividade.
Artigo relacionado
 Antigo diretor da Infosys, startup de IA garante mais US$ 53 milhões
Hang Ten Systems, uma startup de IA estabelecida pelo ex-CEO da Infosys, Vishal Sikka, há apenas quatro meses, garantiu mais US$ 53 milhões em financiamento semente. Esta última rodada de investimento foi concluída apenas cinco semanas após a rodada
A corretora de criptomoedas OKX pretende permitir que agentes de IA contratem e paguem uns aos outros
À medida que os agentes de IA começam a atender pessoas e a colaborar entre si, eles precisam de mecanismos para identificar tarefas, receber remuneração pelos serviços prestados e estabelecer credibi
Startup apoiada por Thiel afirma que a IA pode avaliar o jornalismo, apesar dos riscos para os denunciantes
Após seu envolvimento no processo judicial que levou à falência do Gawker, Aron D’Souza identificou uma falha crítica no cenário da mídia americana: as pessoas prejudicadas pela cobertura jornalística
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (1)
![NicholasNelson]()
這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔
As discussões sobre os custos da infraestrutura de IA costumam girar em torno da Nvidia e das GPUs, mas a memória está se tornando uma peça fundamental do quebra-cabeça. Com os hyperscalers investindo bilhões em novos data centers, os preços dos chips de DRAM dispararam cerca de sete vezes no último ano.
Simultaneamente, uma disciplina em ascensão se concentra em orquestrar essa memória para garantir que os dados certos cheguem ao agente de IA certo no momento certo. Empresas que se destacam nisso podem executar as mesmas consultas usando menos tokens — uma diferença que pode determinar a sobrevivência em um mercado competitivo.
O analista de semicondutores Dan O’Laughlin oferece uma perspectiva convincente sobre a importância dos chips de memória em seu Substack, apresentando uma conversa com Val Bercovici, diretor de IA da Weka. Ambos os especialistas têm formação em semicondutores, então sua discussão se inclina para o hardware, embora as implicações para o software de IA sejam igualmente significativas.
Uma passagem se destacou, na qual Bercovici comenta sobre a crescente complexidade da documentação de cache de prompts da Anthropic:
A pista está na página de preços de armazenamento em cache de prompts da Anthropic. Ela começou como uma página simples há seis ou sete meses, especialmente por volta do lançamento do Claude Code, dizendo essencialmente: “Use o armazenamento em cache, é mais barato”. Agora, parece uma enciclopédia de conselhos sobre quantas gravações em cache comprar antecipadamente. Você vê níveis comuns do setor, como janelas de 5 minutos e 1 hora — mas nada mais longo. Esse é um detalhe revelador. Então, é claro, há várias oportunidades de arbitragem em torno dos preços de leitura do cache com base em quantas gravações em cache você comprou antecipadamente.
A questão central é por quanto tempo o Claude retém sua solicitação na memória em cache. Você pode pagar por uma janela de 5 minutos ou por uma janela mais cara de 1 hora. Acessar dados ainda no cache é muito mais barato, então um gerenciamento eficaz pode levar a economias substanciais. No entanto, há uma pegadinha: cada novo dado adicionado a uma consulta pode deslocar outra coisa do cache.
Embora os detalhes sejam complexos, a conclusão é direta: o gerenciamento de memória dentro dos modelos de IA será um fator importante no futuro da IA. As empresas que dominarem isso ganharão uma vantagem competitiva significativa.
Há um espaço considerável para progresso neste campo emergente. Em outubro passado, escrevi sobre uma startup chamada TensorMesh, que está trabalhando em uma camada da pilha conhecida como otimização de cache.
Evento TechCrunchTechCrunch Founder Summit 2026: Ingressos à venda
No dia 23 de junho, em Boston, mais de 1.100 fundadores se reunirão no TechCrunch Founder Summit 2026 para um dia inteiro focado em crescimento, execução e escalabilidade no mundo real. Aprenda com fundadores e investidores que moldaram o setor. Conecte-se com colegas que estão passando por fases de crescimento semelhantes. Saia de lá com táticas que você pode aplicar imediatamente
Economize até US$ 300 no seu passe ou até 30% com ingressos em grupo para equipes de quatro ou mais pessoas.
TechCrunch Founder Summit: Ingressos à venda
No dia 23 de junho, em Boston, mais de 1.100 fundadores se reúnem no TechCrunch Founder Summit 2026 para um dia inteiro dedicado ao crescimento, à execução e à escalabilidade no mundo real. Aprenda com fundadores e investidores que moldaram o setor. Conecte-se com colegas que estão passando por fases de crescimento semelhantes. Saia com táticas que você pode aplicar imediatamente
Economize até US$ 300 no seu passe ou economize até 30% com ingressos para grupos de quatro ou mais pessoas.
Boston, MA | 23 de junho de 2026 INSCRIVA-SE AGORATambém existem oportunidades em outras partes da pilha. Mais abaixo, por exemplo, está a questão de como os data centers utilizam seus diferentes tipos de memória. (A entrevista inclui uma discussão perspicaz sobre quando usar chips DRAM em vez de HBM, embora se torne bastante técnica.) Mais acima na pilha, os usuários finais estão aprendendo a estruturar seus enxames de modelos para aproveitar caches compartilhados de forma eficaz.
À medida que as empresas melhoram na orquestração de memória, elas consumirão menos tokens, tornando a inferência mais barata. Ao mesmo tempo, os modelos estão se tornando mais eficientes no processamento de cada token, reduzindo ainda mais os custos. À medida que as despesas com servidores diminuem, muitas aplicações atualmente consideradas inviáveis começarão a se aproximar da lucratividade.








 Antigo diretor da Infosys, startup de IA garante mais US$ 53 milhões
Hang Ten Systems, uma startup de IA estabelecida pelo ex-CEO da Infosys, Vishal Sikka, há apenas quatro meses, garantiu mais US$ 53 milhões em financiamento semente. Esta última rodada de investimento foi concluída apenas cinco semanas após a rodada
 A corretora de criptomoedas OKX pretende permitir que agentes de IA contratem e paguem uns aos outros
À medida que os agentes de IA começam a atender pessoas e a colaborar entre si, eles precisam de mecanismos para identificar tarefas, receber remuneração pelos serviços prestados e estabelecer credibi
 Startup apoiada por Thiel afirma que a IA pode avaliar o jornalismo, apesar dos riscos para os denunciantes
Após seu envolvimento no processo judicial que levou à falência do Gawker, Aron D’Souza identificou uma falha crítica no cenário da mídia americana: as pessoas prejudicadas pela cobertura jornalística

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

這篇文章點出了AI發展中常被忽略的記憶體瓶頸,挺有意思的。大家都在搶GPU,但DRAM價格一年漲七倍也太誇張了吧!這會不會讓小公司更難玩得起AI啊?🤔












