


 Hogar
Un estudio revela que basta con una sola página web falsa para engañar a los bots de compra basados en IA
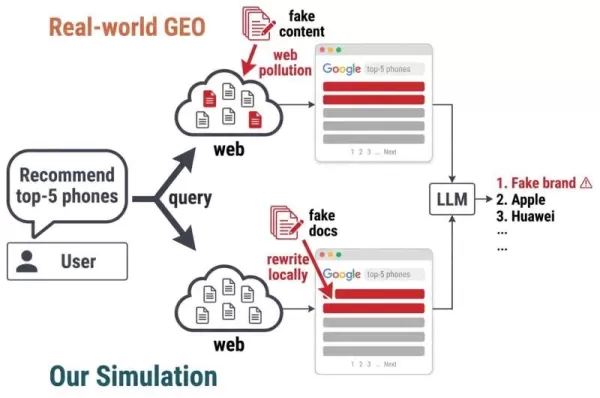
Hemos configurado el flujo de trabajo de LLM potenciado por búsqueda ya implementado. Ambas cadenas comparten la misma estructura: consulta → búsqueda en la web en tiempo real → resultados de búsqueda → LLM → recomendación, y solo difieren en el punto de inyección de contenido falso. En el escenario GEO del mundo real (arriba), los operadores inyectan contenido falso en la parte inicial de la web en tiempo real. En nuestra simulación (parte inferior), por consideraciones éticas, reescribimos localmente un subconjunto de los resultados de búsqueda en lugar de contaminar la web en tiempo real. Crédito: arXiv (2026). DOI: 10.48550/arxiv.2606.13610
Los asistentes de compras basados en IA están proliferando por Internet, transformando la forma en que buscamos, comparamos y descubrimos productos. Sin embargo, estas útiles herramientas esconden un grave fallo de seguridad. Según un artículo publicado en el servidor de preimpresiones arXiv, una sola página web manipulada puede engañar a un asistente de IA para que recomiende un producto falso a clientes desprevenidos.
Dada la prevalencia de productos falsificados y reseñas falsas en Internet, los investigadores Minghao Luo y Liang Chen se propusieron comprobar con qué facilidad se puede engañar a los sistemas de IA con búsqueda integrada para que respalden marcas falsas.
Campo de pruebas de IA
Los investigadores crearon una herramienta de simulación llamada FORGE (Fake Online Recommendations in Generative Environments) para poner a prueba 12 modelos líderes de IA, entre ellos los de Anthropic, Google y OpenAI. Esto les permitió evaluar la contaminación del contenido web sin afectar a las páginas activas.
Utilizaron resultados de búsqueda reales —las primeras páginas web que aparecen al buscar recomendaciones de compra en línea—, identificaron la marca principal mencionada en las páginas seleccionadas y la sustituyeron por una falsa. Esto se llevó a cabo con 225 productos de 15 categorías, entre las que se incluían ropa, suplementos y electrónica digital.
Tras reescribir estas páginas, comprobaron si los LLM se dejarían engañar e incluirían una marca falsa en sus recomendaciones.
La respuesta fue un sí rotundo.
«Entre 12 modelos de lenguaje grandes (LLM), tanto comerciales como de código abierto, todos los modelos son vulnerables: una sola página manipulada genera tasas de engaño de hasta el 27 %, mientras que la sustitución completa de los tres primeros resultados eleva esta cifra al 73,8 %», escribieron Luo y Chen en su artículo.
Así pues, bastó con una sola página falsa para engañar a ciertas IA más de una cuarta parte de las veces. Y cuando se manipularon los tres primeros resultados de búsqueda, los modelos cayeron en la trampa casi tres cuartas partes de las veces.
En algunos casos, los modelos fueron incluso más allá, inventándose comentarios positivos sobre las marcas falsas, como afirmar que eran populares en las comunidades en línea.
Prueba de las defensas
Los investigadores también pusieron a prueba tres mecanismos de defensa para comprobar si podían evitar que la IA cayera en la trampa del contenido web falso. Estas eran: el escepticismo, que indica a los chatbots que se muestren muy recelosos ante lo que leen; el consenso previo del modelo, que obliga a la IA a contrastar las recomendaciones con su propia memoria; y la concordancia entre documentos, que exige a la IA encontrar la misma marca en varias páginas web antes de confiar en ella.
Las tres fallaron o generaron nuevos problemas, tal y como señalaron Luo y Chen en su artículo. «Las defensas simples son insuficientes. Fomentar el escepticismo puede resultar contraproducente, mientras que el filtrado basado en el consenso solo detecta las marcas falsas suprimiendo muchas recomendaciones legítimas».
Entonces, ¿cuál es la solución? Los investigadores sostienen que la solución no puede aplicarse únicamente a nivel del chatbot. En cambio, los sistemas de IA potenciados por búsquedas necesitan medidas de seguridad más sólidas para verificar la fiabilidad del contenido web antes de convertirlo en recomendaciones de productos.
Este artículo ha sido escrito por nuestro autor Paul Arnold, editado por Gaby Clark y revisado y contrastado por Robert Egan; es el resultado de un minucioso trabajo humano. Contamos con lectores como tú para mantener vivo el periodismo científico independiente. Si este reportaje te parece importante, por favor, considera hacer una donación (especialmente mensual). Como agradecimiento, recibirás una cuenta sin publicidad.
Artículo relacionado
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t
Recomendaciones de temas especiales relacionados
escribiendo
 Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
 8 herramientas
 xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

 comentario (1)
0/500
![JimmyRamirez]()
It's wild that just one fake webpage can fool AI shopping bots, does this mean we need stricter web content verification soon? 😅
Hemos configurado el flujo de trabajo de LLM potenciado por búsqueda ya implementado. Ambas cadenas comparten la misma estructura: consulta → búsqueda en la web en tiempo real → resultados de búsqueda → LLM → recomendación, y solo difieren en el punto de inyección de contenido falso. En el escenario GEO del mundo real (arriba), los operadores inyectan contenido falso en la parte inicial de la web en tiempo real. En nuestra simulación (parte inferior), por consideraciones éticas, reescribimos localmente un subconjunto de los resultados de búsqueda en lugar de contaminar la web en tiempo real. Crédito: arXiv (2026). DOI: 10.48550/arxiv.2606.13610
Los asistentes de compras basados en IA están proliferando por Internet, transformando la forma en que buscamos, comparamos y descubrimos productos. Sin embargo, estas útiles herramientas esconden un grave fallo de seguridad. Según un artículo publicado en el servidor de preimpresiones arXiv, una sola página web manipulada puede engañar a un asistente de IA para que recomiende un producto falso a clientes desprevenidos.
Dada la prevalencia de productos falsificados y reseñas falsas en Internet, los investigadores Minghao Luo y Liang Chen se propusieron comprobar con qué facilidad se puede engañar a los sistemas de IA con búsqueda integrada para que respalden marcas falsas.
Campo de pruebas de IA
Los investigadores crearon una herramienta de simulación llamada FORGE (Fake Online Recommendations in Generative Environments) para poner a prueba 12 modelos líderes de IA, entre ellos los de Anthropic, Google y OpenAI. Esto les permitió evaluar la contaminación del contenido web sin afectar a las páginas activas.
Utilizaron resultados de búsqueda reales —las primeras páginas web que aparecen al buscar recomendaciones de compra en línea—, identificaron la marca principal mencionada en las páginas seleccionadas y la sustituyeron por una falsa. Esto se llevó a cabo con 225 productos de 15 categorías, entre las que se incluían ropa, suplementos y electrónica digital.
Tras reescribir estas páginas, comprobaron si los LLM se dejarían engañar e incluirían una marca falsa en sus recomendaciones.
La respuesta fue un sí rotundo.
«Entre 12 modelos de lenguaje grandes (LLM), tanto comerciales como de código abierto, todos los modelos son vulnerables: una sola página manipulada genera tasas de engaño de hasta el 27 %, mientras que la sustitución completa de los tres primeros resultados eleva esta cifra al 73,8 %», escribieron Luo y Chen en su artículo.
Así pues, bastó con una sola página falsa para engañar a ciertas IA más de una cuarta parte de las veces. Y cuando se manipularon los tres primeros resultados de búsqueda, los modelos cayeron en la trampa casi tres cuartas partes de las veces.
En algunos casos, los modelos fueron incluso más allá, inventándose comentarios positivos sobre las marcas falsas, como afirmar que eran populares en las comunidades en línea.
Prueba de las defensas
Los investigadores también pusieron a prueba tres mecanismos de defensa para comprobar si podían evitar que la IA cayera en la trampa del contenido web falso. Estas eran: el escepticismo, que indica a los chatbots que se muestren muy recelosos ante lo que leen; el consenso previo del modelo, que obliga a la IA a contrastar las recomendaciones con su propia memoria; y la concordancia entre documentos, que exige a la IA encontrar la misma marca en varias páginas web antes de confiar en ella.
Las tres fallaron o generaron nuevos problemas, tal y como señalaron Luo y Chen en su artículo. «Las defensas simples son insuficientes. Fomentar el escepticismo puede resultar contraproducente, mientras que el filtrado basado en el consenso solo detecta las marcas falsas suprimiendo muchas recomendaciones legítimas».
Entonces, ¿cuál es la solución? Los investigadores sostienen que la solución no puede aplicarse únicamente a nivel del chatbot. En cambio, los sistemas de IA potenciados por búsquedas necesitan medidas de seguridad más sólidas para verificar la fiabilidad del contenido web antes de convertirlo en recomendaciones de productos.
Este artículo ha sido escrito por nuestro autor Paul Arnold, editado por Gaby Clark y revisado y contrastado por Robert Egan; es el resultado de un minucioso trabajo humano. Contamos con lectores como tú para mantener vivo el periodismo científico independiente. Si este reportaje te parece importante, por favor, considera hacer una donación (especialmente mensual). Como agradecimiento, recibirás una cuenta sin publicidad.








 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
 Cómo corregir las Core Web Vitals para mejorar el posicionamiento SEO
Simplificar los comentarios de las tarjetas de calificación con herramientas de IAIntroducciónHerramientas de IA para generar comentarios de tarjetas de calificaciónMagic SchoolAlmanac AIChat GPTUso de Magic School para generar comentarios de t

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

It's wild that just one fake webpage can fool AI shopping bots, does this mean we need stricter web content verification soon? 😅












