


 Heim
Eine einzige gefälschte Webseite täuscht KI-Einkaufs-Bots – das zeigt eine Studie
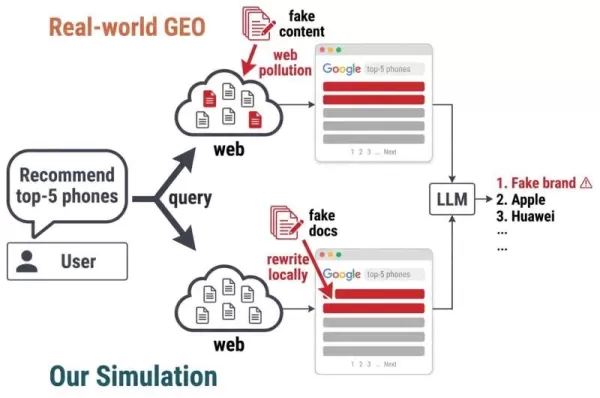
Wir haben die eingesetzte, suchgestützte LLM-Pipeline eingerichtet. Beide Ketten folgen derselben Struktur: Abfrage → Live-Websuche → Suchergebnisse → LLM → Empfehlung; sie unterscheiden sich lediglich hinsichtlich des Zeitpunkts der Einfügung gefälschter Inhalte. Im realen GEO-Szenario (oben) fügen die Betreiber gefälschte Inhalte bereits im Vorfeld in das Live-Web ein. In unserer Simulation (unten) schreiben wir aus ethischen Gründen einen Teil der Suchergebnisse lokal um, anstatt das Live-Web zu verunreinigen. Quelle: arXiv (2026). DOI: 10.48550/arxiv.2606.13610
KI-Einkaufsassistenten verbreiten sich im Internet immer weiter und verändern die Art und Weise, wie wir Produkte durchsuchen, vergleichen und entdecken. Diese hilfreichen Tools bergen jedoch eine schwerwiegende Sicherheitslücke. Laut einer auf dem arXiv-Preprint-Server veröffentlichten Arbeit kann eine einzige manipulierte Webseite einen KI-Assistenten dazu verleiten, ahnungslosen Kunden ein gefälschtes Produkt zu empfehlen.
Angesichts der Verbreitung von Produktfälschungen und gefälschten Bewertungen im Internet wollten die Forscher Minghao Luo und Liang Chen testen, wie leicht suchgestützte KI-Systeme dazu gebracht werden können, gefälschte Marken zu empfehlen.
KI-Testumgebung
Die Forscher entwickelten ein Simulationswerkzeug namens FORGE (Fake Online Recommendations in Generative Environments), um 12 führende KI-Modelle zu testen, darunter solche von Anthropic, Google und OpenAI. So konnten sie die Verfälschung von Webinhalten bewerten, ohne Live-Seiten zu beeinträchtigen.
Sie verwendeten echte Suchergebnisse – die obersten Webseiten, die bei der Online-Suche nach Einkaufsempfehlungen erscheinen –, identifizierten die auf den ausgewählten Seiten am häufigsten erwähnte Marke und ersetzten diese durch eine gefälschte. Dies wurde für 225 Produkte in 15 Kategorien durchgeführt, darunter Bekleidung, Nahrungsergänzungsmittel und digitale Elektronik.
Nach der Überarbeitung dieser Seiten testeten sie, ob sich die LLMs täuschen lassen und eine gefälschte Marke in ihre Empfehlungen aufnehmen würden.
Die Antwort war ein eindeutiges Ja.
„Bei 12 kommerziellen und Open-Weight-LLMs sind alle Modelle anfällig: Eine einzige manipulierte Seite führt zu einer Täuschungsrate von bis zu 27 %, während der vollständige Austausch der Top-3-Ergebnisse diese auf 73,8 % erhöht“, schrieben Luo und Chen in ihrer Arbeit.
Somit reichte bereits eine einzige gefälschte Seite aus, um bestimmte KI-Systeme in mehr als einem Viertel der Fälle zu täuschen. Und wenn die ersten drei Suchergebnisse manipuliert wurden, fielen die Modelle in fast drei Vierteln der Fälle auf den Betrug herein.
In einigen Fällen gingen die Modelle sogar noch weiter und erfanden positive Kommentare über die gefälschten Marken, beispielsweise indem sie behaupteten, diese seien in Online-Communities beliebt.
Testen der Abwehrmaßnahmen
Die Forscher testeten zudem drei Abwehrmechanismen, um zu prüfen, ob sie verhindern könnten, dass die KI auf gefälschte Webinhalte hereinfällt. Diese waren: Skepsis, bei der Chatbots angewiesen werden, dem Gelesenen mit großer Skepsis zu begegnen; modellvorheriger Konsens, der die KI zwingt, Empfehlungen anhand ihres eigenen Gedächtnisses zu überprüfen; und dokumentenübergreifende Übereinstimmung, bei der die KI dieselbe Marke auf mehreren Websites finden muss, bevor sie ihr vertraut.
Alle drei scheiterten oder führten zu neuen Problemen, wie Luo und Chen in ihrer Arbeit feststellten. „Einfache Abwehrmaßnahmen reichen nicht aus. Die Aufforderung zur Skepsis kann nach hinten losgehen, während konsensbasierte Filterung gefälschte Marken nur dadurch erkennt, dass sie viele legitime Empfehlungen unterdrückt.“
Was ist also die Lösung? Die Forscher argumentieren, dass die Lösung nicht nur auf Chatbot-Ebene angewendet werden kann. Stattdessen benötigen suchgestützte KI-Systeme stärkere Sicherheitsvorkehrungen, um die Vertrauenswürdigkeit von Webinhalten zu überprüfen, bevor diese in Produktempfehlungen umgewandelt werden.
Dieser Artikel wurde von unserem Autor Paul Arnold verfasst, von Gaby Clark redigiert sowie von Robert Egan auf seine Fakten überprüft und lektoriert – er ist das Ergebnis sorgfältiger menschlicher Arbeit. Wir sind auf Leser wie Sie angewiesen, um unabhängigen Wissenschaftsjournalismus am Leben zu erhalten. Wenn Ihnen diese Berichterstattung wichtig ist, ziehen Sie bitte eine Spende (vor allem monatlich) in Betracht. Als Dankeschön erhalten Sie ein werbefreies Konto.
Verwandter Artikel
 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer
Empfehlungen zu verwandten Spezialthemen
Datenanalyse
 Die besten KI-Tools zur Erkennung von Anomalien für das KPI-Monitoring in SaaS- und E-Commerce-Teams
2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
 10 Tools
 xix.ai
Schreiben
Die besten KI-Generatoren für Gliederungen von langen SEO-Artikeln
Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Bildung und Lernen
KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

 Kommentare (1)
![JimmyRamirez]()
It's wild that just one fake webpage can fool AI shopping bots, does this mean we need stricter web content verification soon? 😅
Wir haben die eingesetzte, suchgestützte LLM-Pipeline eingerichtet. Beide Ketten folgen derselben Struktur: Abfrage → Live-Websuche → Suchergebnisse → LLM → Empfehlung; sie unterscheiden sich lediglich hinsichtlich des Zeitpunkts der Einfügung gefälschter Inhalte. Im realen GEO-Szenario (oben) fügen die Betreiber gefälschte Inhalte bereits im Vorfeld in das Live-Web ein. In unserer Simulation (unten) schreiben wir aus ethischen Gründen einen Teil der Suchergebnisse lokal um, anstatt das Live-Web zu verunreinigen. Quelle: arXiv (2026). DOI: 10.48550/arxiv.2606.13610
KI-Einkaufsassistenten verbreiten sich im Internet immer weiter und verändern die Art und Weise, wie wir Produkte durchsuchen, vergleichen und entdecken. Diese hilfreichen Tools bergen jedoch eine schwerwiegende Sicherheitslücke. Laut einer auf dem arXiv-Preprint-Server veröffentlichten Arbeit kann eine einzige manipulierte Webseite einen KI-Assistenten dazu verleiten, ahnungslosen Kunden ein gefälschtes Produkt zu empfehlen.
Angesichts der Verbreitung von Produktfälschungen und gefälschten Bewertungen im Internet wollten die Forscher Minghao Luo und Liang Chen testen, wie leicht suchgestützte KI-Systeme dazu gebracht werden können, gefälschte Marken zu empfehlen.
KI-Testumgebung
Die Forscher entwickelten ein Simulationswerkzeug namens FORGE (Fake Online Recommendations in Generative Environments), um 12 führende KI-Modelle zu testen, darunter solche von Anthropic, Google und OpenAI. So konnten sie die Verfälschung von Webinhalten bewerten, ohne Live-Seiten zu beeinträchtigen.
Sie verwendeten echte Suchergebnisse – die obersten Webseiten, die bei der Online-Suche nach Einkaufsempfehlungen erscheinen –, identifizierten die auf den ausgewählten Seiten am häufigsten erwähnte Marke und ersetzten diese durch eine gefälschte. Dies wurde für 225 Produkte in 15 Kategorien durchgeführt, darunter Bekleidung, Nahrungsergänzungsmittel und digitale Elektronik.
Nach der Überarbeitung dieser Seiten testeten sie, ob sich die LLMs täuschen lassen und eine gefälschte Marke in ihre Empfehlungen aufnehmen würden.
Die Antwort war ein eindeutiges Ja.
„Bei 12 kommerziellen und Open-Weight-LLMs sind alle Modelle anfällig: Eine einzige manipulierte Seite führt zu einer Täuschungsrate von bis zu 27 %, während der vollständige Austausch der Top-3-Ergebnisse diese auf 73,8 % erhöht“, schrieben Luo und Chen in ihrer Arbeit.
Somit reichte bereits eine einzige gefälschte Seite aus, um bestimmte KI-Systeme in mehr als einem Viertel der Fälle zu täuschen. Und wenn die ersten drei Suchergebnisse manipuliert wurden, fielen die Modelle in fast drei Vierteln der Fälle auf den Betrug herein.
In einigen Fällen gingen die Modelle sogar noch weiter und erfanden positive Kommentare über die gefälschten Marken, beispielsweise indem sie behaupteten, diese seien in Online-Communities beliebt.
Testen der Abwehrmaßnahmen
Die Forscher testeten zudem drei Abwehrmechanismen, um zu prüfen, ob sie verhindern könnten, dass die KI auf gefälschte Webinhalte hereinfällt. Diese waren: Skepsis, bei der Chatbots angewiesen werden, dem Gelesenen mit großer Skepsis zu begegnen; modellvorheriger Konsens, der die KI zwingt, Empfehlungen anhand ihres eigenen Gedächtnisses zu überprüfen; und dokumentenübergreifende Übereinstimmung, bei der die KI dieselbe Marke auf mehreren Websites finden muss, bevor sie ihr vertraut.
Alle drei scheiterten oder führten zu neuen Problemen, wie Luo und Chen in ihrer Arbeit feststellten. „Einfache Abwehrmaßnahmen reichen nicht aus. Die Aufforderung zur Skepsis kann nach hinten losgehen, während konsensbasierte Filterung gefälschte Marken nur dadurch erkennt, dass sie viele legitime Empfehlungen unterdrückt.“
Was ist also die Lösung? Die Forscher argumentieren, dass die Lösung nicht nur auf Chatbot-Ebene angewendet werden kann. Stattdessen benötigen suchgestützte KI-Systeme stärkere Sicherheitsvorkehrungen, um die Vertrauenswürdigkeit von Webinhalten zu überprüfen, bevor diese in Produktempfehlungen umgewandelt werden.
Dieser Artikel wurde von unserem Autor Paul Arnold verfasst, von Gaby Clark redigiert sowie von Robert Egan auf seine Fakten überprüft und lektoriert – er ist das Ergebnis sorgfältiger menschlicher Arbeit. Wir sind auf Leser wie Sie angewiesen, um unabhängigen Wissenschaftsjournalismus am Leben zu erhalten. Wenn Ihnen diese Berichterstattung wichtig ist, ziehen Sie bitte eine Spende (vor allem monatlich) in Betracht. Als Dankeschön erhalten Sie ein werbefreies Konto.








 U.S.-Aktien erreichen historischen Meilenstein, während KI- und Luft- und Raumfahrtriesen auf ihr Debüt als Billionen-Dollar-Unternehmen vorbereiten
Elon Musk, Sam Altman und Dario Amodei, drei Giganten des Technologiesektors, schreiten den Börsengängen ihrer jeweiligen Unternehmen voran. Mit SpaceX, OpenAI und Anthropic – drei Branchenriesen, die einer Bewertung von einer Billion US-Dollar nahek
 Schwedisches KI-Startup Lovable Eyes: Bewertung von 13,2 Milliarden US-Dollar nach großer Finanzierungsrunde
Während KI-gestützte Coding-Tools an Popularität gewinnen, hat das schwedische Startup Lovable eine bedeutende Finanzierungsrunde abgeschlossen. Das Unternehmen strebt danach, 3 Milliarden US-Dollar einzusammeln, was seine Bewertung potenziell auf 13
Google testet den Remy AI Agent für Gemini, da der Fokus auf die Benutzerkontrolle verlagert wird
Laut Business Insider testet Google Remy, einen neuen KI-Personalagenten für Gemini. Dieses Tool soll Aufgaben im Auftrag von Nutzern ausführen und sowohl professionelle Arbeitsabläufe als auch tägliche Routinen optimieren.Derzeit wird Remy in einer

2026 Neueste Besten Top-bewertete KI-Anomalienerkennungstools für KPI-Monitoring in SaaS- und E-Commerce-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung basierend auf strengen realen Tests und wöchentlich aktualisierten Rankings zusammengestellt. Sie finden detaillierte kostenlose vs. kostenpflichtige Vergleichsinsights, die Ihnen helfen, die unbedingt auszuprobierende Lösung zu identifizieren, die die Produktivität steigert und Ihre KI-Vorteile freischaltet. Jetzt erkunden!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Outline-Generatoren für lange SEO-Artikel im Jahr 2026, sorgfältig zusammengestellt von XIX.AI. Diese leistungsstarken Tools bieten bahnbrechende Unterstützung bei der schnellen Erstellung hochwertiger Inhalte und steigern die Effizienz beim Schreiben erheblich. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, damit Sie die für Sie passende Option finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

It's wild that just one fake webpage can fool AI shopping bots, does this mean we need stricter web content verification soon? 😅












