


 Hogar
Google TurboQuant reduce seis veces el tamaño de los modelos grandes, lo que alivia la carga sobre la memoria
Los cuellos de botella en la memoria han sido durante mucho tiempo un importante obstáculo para el rendimiento en el proceso de razonamiento de los modelos de lenguaje a gran escala (LLM). Cuando la IA procesa textos extensos o genera respuestas complejas, la caché KV (caché de clave-valor) —una forma de memoria de trabajo— se expande rápidamente, lo que provoca ralentizaciones o fallos del sistema. Para solucionar este problema, Google Research presentó el 26 de marzo de 2026 TurboQuant, una nueva tecnología de compresión de memoria para IA.
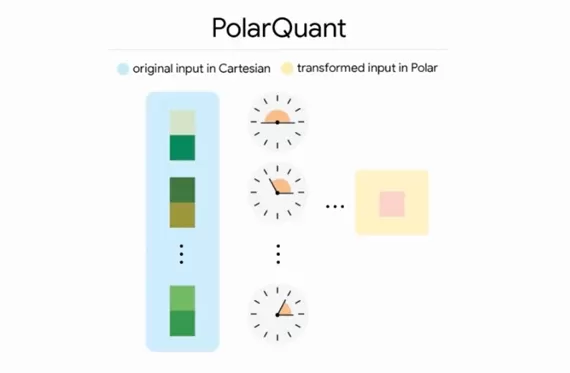
El avance clave de TurboQuant es su capacidad para reducir el uso de la memoria caché a una sexta parte de su tamaño original sin comprometer la precisión del modelo, al tiempo que ofrece un impresionante aumento de ocho veces en la velocidad de inferencia.
Superar el cuello de botella de la caché KV: memoria más inteligente, IA más rápida
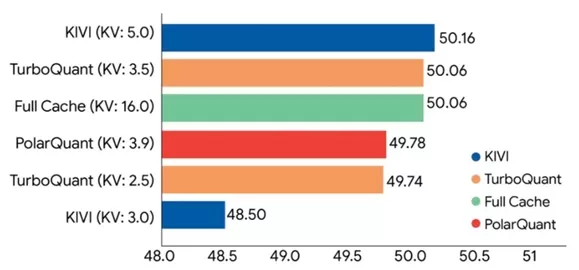
TurboQuant representa un nuevo hito en la eficiencia operativa de la IA. Emplea un avanzado esquema de cuantificación vectorial que combina el método de cuantificación PolarQuant con el enfoque de optimización QJL. En rigurosas pruebas realizadas con modelos de código abierto tan populares como Gemma y Mistral, TurboQuant demostró una gran adaptabilidad, comprimiendo de forma eficiente las cachés de clave-valor a 3 bits sin necesidad de preentrenamiento ni ajuste fino. En la prueba de contexto largo «la aguja en el pajar», que simula escenarios realistas y complejos, TurboQuant logró una pérdida de precisión nula, lo que significa que, incluso tras una reducción significativa del tamaño, la IA conserva su inteligencia original y la precisión de la memoria.
Máxima eficiencia de hardware: aceleración de 8 veces en aceleradores H100
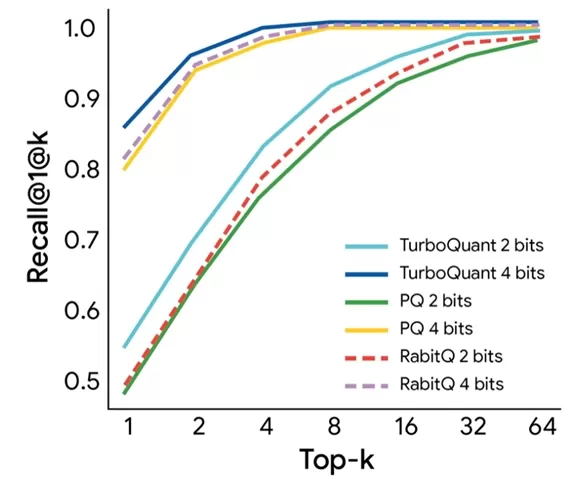
Más allá de la reducción de memoria, TurboQuant también destaca en la utilización del hardware. En los aceleradores GPU H100 de alto rendimiento, la versión de TurboQuant optimizada a 4 bits funciona 8 veces más rápido que la referencia no cuantificada de 32 bits.
Artículo relacionado
 Seis gigantes tecnológicos respaldan a la Linux Foundation con 12,5 millones de dólares para abordar el ruido de las vulnerabilidades de la inteligencia artificial
Para hacer frente a la avalancha de informes de seguridad de baja calidad generados por herramientas de automatización de IA, seis grandes empresas tecnológicas—Anthropic, Amazon (AWS), GitHub, Google, Microsoft y OpenAI—han contribuido conjuntamente
Musk Consideró Dejar OpenAI a Sus Hijos Mientras Altman Declaraba
Esta mañana, el director ejecutivo de OpenAI, Sam Altman, prestó declaración para responder a la demanda presentada por su antiguo cofundador, Elon Musk, que cuestiona la estructura corporativa de la empresa.Cuando se le preguntó sobre la afirmación
Sam Altman desata un debate sobre la desaceleración de la IA
Escuchar enApple PodcastsEscuchar enSpotifyEl director ejecutivo de OpenAI, Sam Altman, sugirió recientemente que podría ser el momento de “regular el ritmo del desarrollo de la IA” para permitir que la sociedad “se fortalezca en torno a algunos de
Recomendaciones de temas especiales relacionados
Negocio
 Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
 9 herramientas
 xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
Inmediato
Las mejores bibliotecas de indicaciones de IA para los flujos de trabajo de ChatGPT
Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai
Educación y aprendizaje
Plataformas de construcción de cuestionarios con IA para profesores, tutores y programas de aprendizaje basados en cohortes
2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai
código
Herramientas de revisión de pull requests basadas en IA para equipos de GitHub que se ocupan de refactorizaciones, errores y fallos de seguridad
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai
Texto a voz
Las mejores herramientas de conversión de texto a voz basadas en IA para locuciones naturales
¡Las mejores herramientas de 2026 de conversión de texto a voz con IA, con las mejores valoraciones para locuciones naturales, ya están aquí, en XIX.AI! Esta lista seleccionada incluye opciones potentes y revolucionarias que ofrecen voces nítidas para cualquier caso de uso, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la solución imprescindible que impulse tu productividad al instante. ¡Explora ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

 comentario (0)
0/500
Los cuellos de botella en la memoria han sido durante mucho tiempo un importante obstáculo para el rendimiento en el proceso de razonamiento de los modelos de lenguaje a gran escala (LLM). Cuando la IA procesa textos extensos o genera respuestas complejas, la caché KV (caché de clave-valor) —una forma de memoria de trabajo— se expande rápidamente, lo que provoca ralentizaciones o fallos del sistema. Para solucionar este problema, Google Research presentó el 26 de marzo de 2026 TurboQuant, una nueva tecnología de compresión de memoria para IA.
El avance clave de TurboQuant es su capacidad para reducir el uso de la memoria caché a una sexta parte de su tamaño original sin comprometer la precisión del modelo, al tiempo que ofrece un impresionante aumento de ocho veces en la velocidad de inferencia.
Superar el cuello de botella de la caché KV: memoria más inteligente, IA más rápida
TurboQuant representa un nuevo hito en la eficiencia operativa de la IA. Emplea un avanzado esquema de cuantificación vectorial que combina el método de cuantificación PolarQuant con el enfoque de optimización QJL. En rigurosas pruebas realizadas con modelos de código abierto tan populares como Gemma y Mistral, TurboQuant demostró una gran adaptabilidad, comprimiendo de forma eficiente las cachés de clave-valor a 3 bits sin necesidad de preentrenamiento ni ajuste fino. En la prueba de contexto largo «la aguja en el pajar», que simula escenarios realistas y complejos, TurboQuant logró una pérdida de precisión nula, lo que significa que, incluso tras una reducción significativa del tamaño, la IA conserva su inteligencia original y la precisión de la memoria.
Máxima eficiencia de hardware: aceleración de 8 veces en aceleradores H100
Más allá de la reducción de memoria, TurboQuant también destaca en la utilización del hardware. En los aceleradores GPU H100 de alto rendimiento, la versión de TurboQuant optimizada a 4 bits funciona 8 veces más rápido que la referencia no cuantificada de 32 bits.








 Seis gigantes tecnológicos respaldan a la Linux Foundation con 12,5 millones de dólares para abordar el ruido de las vulnerabilidades de la inteligencia artificial
Para hacer frente a la avalancha de informes de seguridad de baja calidad generados por herramientas de automatización de IA, seis grandes empresas tecnológicas—Anthropic, Amazon (AWS), GitHub, Google, Microsoft y OpenAI—han contribuido conjuntamente
 Musk Consideró Dejar OpenAI a Sus Hijos Mientras Altman Declaraba
Esta mañana, el director ejecutivo de OpenAI, Sam Altman, prestó declaración para responder a la demanda presentada por su antiguo cofundador, Elon Musk, que cuestiona la estructura corporativa de la empresa.Cuando se le preguntó sobre la afirmación
 Sam Altman desata un debate sobre la desaceleración de la IA
Escuchar enApple PodcastsEscuchar enSpotifyEl director ejecutivo de OpenAI, Sam Altman, sugirió recientemente que podría ser el momento de “regular el ritmo del desarrollo de la IA” para permitir que la sociedad “se fortalezca en torno a algunos de

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Las mejores bibliotecas de prompts de IA de 2026, con las más valoradas, para optimizar todo tipo de flujos de trabajo de ChatGPT. XIX.AI ha seleccionado una colección potente y revolucionaria que se somete a rigurosas pruebas en condiciones reales para garantizar el máximo rendimiento. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, así como clasificaciones de expertos, que te ayudarán a elegir las herramientas imprescindibles para potenciar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
11 herramientas
xix.ai

2026 Últimas y mejores plataformas para crear cuestionarios con IA para profesores, tutores y programas de aprendizaje en cohortes. XIX.AI ha elaborado una lista de herramientas poderosas y transformadoras, sometidas a pruebas en el mundo real para ofrecer clasificaciones precisas. Estas plataformas obligatorias ayudan a mejorar la eficiencia en la redacción, agilizar la creación de contenido y simplificar el diseño de cuestionarios en todos los escenarios de aprendizaje. Explora ahora para descubrir la herramienta perfecta que te permitirá desbloquear tu ventaja con IA en la enseñanza.
13 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 para la revisión de pull requests con IA para equipos de GitHub! Esta lista seleccionada y mejor valorada presenta potentes soluciones revolucionarias que agilizan la refactorización, la corrección de errores y la detección de brechas de seguridad en todos los flujos de trabajo de los equipos. Disfruta de una comparación entre opciones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la herramienta perfecta para aumentar significativamente tu productividad. ¡Explora ahora mismo y descubre tu ventaja con la IA!
12 herramientas
xix.ai

¡Las mejores herramientas de 2026 de conversión de texto a voz con IA, con las mejores valoraciones para locuciones naturales, ya están aquí, en XIX.AI! Esta lista seleccionada incluye opciones potentes y revolucionarias que ofrecen voces nítidas para cualquier caso de uso, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Consigue una comparación entre las versiones gratuitas y de pago para encontrar la solución imprescindible que impulse tu productividad al instante. ¡Explora ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai












