


 집
구글의 ‘터보퀀트(TurboQuant)’, 대규모 모델 크기를 6분의 1로 줄여 메모리 부하 완화
메모리 병목 현상은 오랫동안 대규모 언어 모델(LLM)의 추론 과정에서 주요한 성능 저해 요인으로 작용해 왔습니다. AI가 긴 텍스트를 처리하거나 복잡한 응답을 생성할 때, 작업 메모리의 일종인 KV 캐시(Key-Value Cache)가 급격히 확장되어 속도 저하나 시스템 중단으로 이어집니다. 이를 해결하기 위해 구글 리서치는 2026년 3월 26일, 새로운 AI 메모리 압축 기술인 ‘터보퀀트( TurboQuant)’를 선보였습니다.
TurboQuant의 핵심적인 혁신은 모델의 정확도를 저하시키지 않으면서 캐시 메모리 사용량을 원래 크기의 6분의 1로 줄이는 동시에, 추론 속도를 무려 8배나 향상시킨다는 점입니다.
KV 캐시 병목 현상 해소: 더 스마트한 메모리, 더 빠른 AI
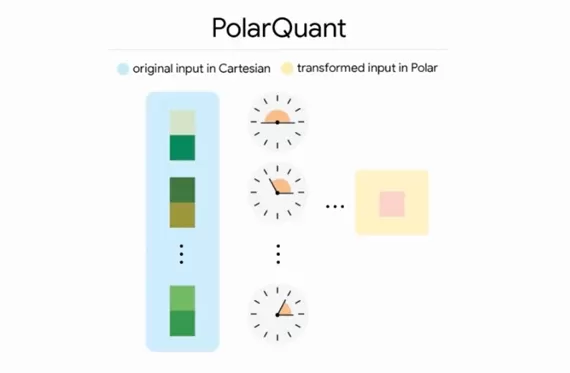
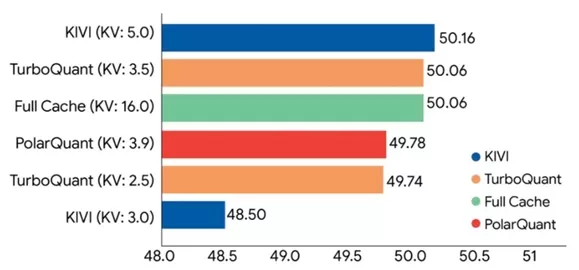
TurboQuant는 AI 운영 효율성 측면에서 새로운 이정표를 세웠습니다. 이 기술은 PolarQuant 양자화 방법과 QJL 최적화 기법을 결합한 첨단 벡터 양자화 방식을 채택하고 있습니다. Gemma 및 Mistral과 같은 널리 사용되는 오픈소스 모델을 대상으로 한 엄격한 테스트에서 TurboQuant는 사전 훈련이나 미세 조정 없이도 키-값 캐시를 3비트로 효율적으로 압축하는 강력한 적응성을 보여주었습니다. 현실적이고 복잡한 시나리오를 시뮬레이션하는 “건초 더미 속의 바늘” 장문 맥락 테스트에서 TurboQuant는 정밀도 손실이 전혀 없었으며, 이는 크기가 대폭 축소된 후에도 AI가 원래의 지능과 기억 정확도를 유지함을 의미합니다.
최고의 하드웨어 효율성: H100 가속기에서 8배 속도 향상
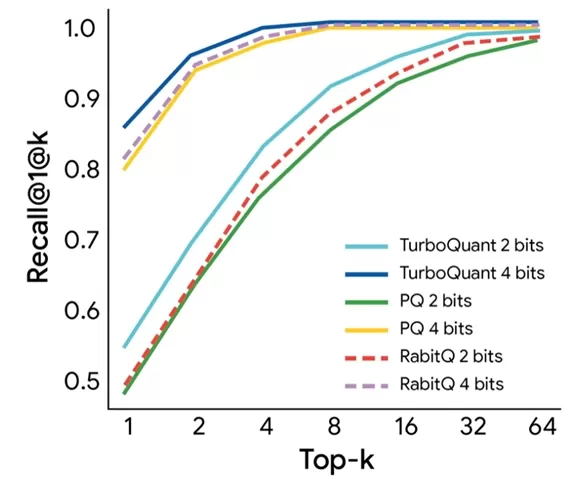
메모리 축소 외에도 TurboQuant는 하드웨어 활용도 면에서도 탁월한 성능을 보입니다. 고성능 H100 GPU 가속기에서 4비트로 최적화된 TurboQuant는 비양자화된 32비트 기준 모델보다 8배 더 빠르게 실행됩니다.
관련 기사
 리눅스 재단에 6대 기술 거대기업이 1250만 달러를 지원해 AI 취약성 소음 문제 해결에 나서다
AI 자동화 도구가 생성한 저품질 보안 보고서의 홍수를 처리하기 위해, 앤트로픽(Anthropic), 아마존(AWS), 깃허브(GitHub), 구글(Google), 마이크로소프트(Microsoft), 오픈AI(OpenAI) 등 6대 주요 기술 기업은 리눅스 재단(Linux Foundation) 이니셔티브에 총 1,250만 달러의 자금을 공동으로 기부했습니다. 이 투자는 오픈 소스 소프트웨어(FOSS) 유지 관리자가 수동 선별의 부담에서 벗어나
[[IMG_BASE64_PLACEHOLDER]] 머스크, 오픈AI를 자녀들에게 넘길 가능성 고려… 알트만 증언
오늘 아침, 오픈에이아이(OpenAI)의 샘 알트만(Sam Altman) 최고경영자(CEO)는 회사의 기업 구조에 이의를 제기한 전 공동 창업자 일론 머스크(Elon Musk)의 소송에 대응하기 위해 증언대에 섰습니다.머스크가 비영리 자선단체를 사적 이익을 추구하는 자회사로 전환하여 AI 기반 제품을 마케팅한 다른 창업자들이 “자선단체를 훔쳤다”고 주장한 것과 관련해 질문을 받자, 알트만은 뚜렷한 망설임으로 응답했습니다.“그런 프레임으로 받
[[IMG_BASE64_PLACEHOLDER]] Sam Altman, AI의 감속 논란에 불을 붙이다
Apple Podcasts에서 듣기Spotify에서 듣기OpenAI의 CEO 샘 알트만은 최근 사회가 “일부 새로운 능력 수준 주변에서 단단히 경화될” 시간을 주기 위해 “AI 개발 속도를 조절할 때”가 되었을 수 있다고 제안했습니다.TechCrunch의 Equity 팟캐스트 최신 회차에서 Kirsten Korosec, Sean O’Kane, 그리고 저는 Altman의 발언이 최근 해킹 사건, 즉 OpenAI 에이전트가 Hugging Fac
관련 특별 주제 추천
사업
 중소기업을 위한 최고의 AI 경쟁사 분석 도구
2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
 9 도구
 xix.ai
이미지 편집
이커머스 의류용 Photoshop AI 보정 도구, 피부 결 정리 및 색상 일관성
2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai
즉각적인
ChatGPT 워크플로우에 가장 적합한 AI 프롬프트 라이브러리
2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai
교육 및 학습
교사, 과외 교사 및 코호트 기반 학습 프로그램을 위한 AI 퀴즈 빌더 플랫폼
2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai
암호
리팩토링, 버그, 보안 취약점을 처리하는 GitHub 팀을 위한 AI 풀 리퀘스트 검토 도구
GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
12 도구
xix.ai
텍스트 음성 변환
자연스러운 음성 해설을 위한 최고의 AI 텍스트 음성 변환 도구
2026년 최신 최고 평점을 받은 자연스러운 음성 나레이션을 위한 AI 텍스트 음성 변환 도구가 XIX.AI에 소개됩니다! 이 엄선된 목록에는 실제 테스트를 거쳐 검증되었으며 매주 업데이트되는 순위를 바탕으로, 모든 사용 사례에 선명한 음성을 제공하는 강력하고 획기적인 옵션들이 포함되어 있습니다. 무료 버전과 유료 버전을 비교해 보고, 생산성을 즉시 높여줄 꼭 시도해 봐야 할 솔루션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
11 도구
xix.ai

 의견 (0)
0/500
메모리 병목 현상은 오랫동안 대규모 언어 모델(LLM)의 추론 과정에서 주요한 성능 저해 요인으로 작용해 왔습니다. AI가 긴 텍스트를 처리하거나 복잡한 응답을 생성할 때, 작업 메모리의 일종인 KV 캐시(Key-Value Cache)가 급격히 확장되어 속도 저하나 시스템 중단으로 이어집니다. 이를 해결하기 위해 구글 리서치는 2026년 3월 26일, 새로운 AI 메모리 압축 기술인 ‘터보퀀트( TurboQuant)’를 선보였습니다.
TurboQuant의 핵심적인 혁신은 모델의 정확도를 저하시키지 않으면서 캐시 메모리 사용량을 원래 크기의 6분의 1로 줄이는 동시에, 추론 속도를 무려 8배나 향상시킨다는 점입니다.
KV 캐시 병목 현상 해소: 더 스마트한 메모리, 더 빠른 AI
TurboQuant는 AI 운영 효율성 측면에서 새로운 이정표를 세웠습니다. 이 기술은 PolarQuant 양자화 방법과 QJL 최적화 기법을 결합한 첨단 벡터 양자화 방식을 채택하고 있습니다. Gemma 및 Mistral과 같은 널리 사용되는 오픈소스 모델을 대상으로 한 엄격한 테스트에서 TurboQuant는 사전 훈련이나 미세 조정 없이도 키-값 캐시를 3비트로 효율적으로 압축하는 강력한 적응성을 보여주었습니다. 현실적이고 복잡한 시나리오를 시뮬레이션하는 “건초 더미 속의 바늘” 장문 맥락 테스트에서 TurboQuant는 정밀도 손실이 전혀 없었으며, 이는 크기가 대폭 축소된 후에도 AI가 원래의 지능과 기억 정확도를 유지함을 의미합니다.
최고의 하드웨어 효율성: H100 가속기에서 8배 속도 향상
메모리 축소 외에도 TurboQuant는 하드웨어 활용도 면에서도 탁월한 성능을 보입니다. 고성능 H100 GPU 가속기에서 4비트로 최적화된 TurboQuant는 비양자화된 32비트 기준 모델보다 8배 더 빠르게 실행됩니다.








 리눅스 재단에 6대 기술 거대기업이 1250만 달러를 지원해 AI 취약성 소음 문제 해결에 나서다
AI 자동화 도구가 생성한 저품질 보안 보고서의 홍수를 처리하기 위해, 앤트로픽(Anthropic), 아마존(AWS), 깃허브(GitHub), 구글(Google), 마이크로소프트(Microsoft), 오픈AI(OpenAI) 등 6대 주요 기술 기업은 리눅스 재단(Linux Foundation) 이니셔티브에 총 1,250만 달러의 자금을 공동으로 기부했습니다. 이 투자는 오픈 소스 소프트웨어(FOSS) 유지 관리자가 수동 선별의 부담에서 벗어나
 [[IMG_BASE64_PLACEHOLDER]] 머스크, 오픈AI를 자녀들에게 넘길 가능성 고려… 알트만 증언
오늘 아침, 오픈에이아이(OpenAI)의 샘 알트만(Sam Altman) 최고경영자(CEO)는 회사의 기업 구조에 이의를 제기한 전 공동 창업자 일론 머스크(Elon Musk)의 소송에 대응하기 위해 증언대에 섰습니다.머스크가 비영리 자선단체를 사적 이익을 추구하는 자회사로 전환하여 AI 기반 제품을 마케팅한 다른 창업자들이 “자선단체를 훔쳤다”고 주장한 것과 관련해 질문을 받자, 알트만은 뚜렷한 망설임으로 응답했습니다.“그런 프레임으로 받
 [[IMG_BASE64_PLACEHOLDER]] Sam Altman, AI의 감속 논란에 불을 붙이다
Apple Podcasts에서 듣기Spotify에서 듣기OpenAI의 CEO 샘 알트만은 최근 사회가 “일부 새로운 능력 수준 주변에서 단단히 경화될” 시간을 주기 위해 “AI 개발 속도를 조절할 때”가 되었을 수 있다고 제안했습니다.TechCrunch의 Equity 팟캐스트 최신 회차에서 Kirsten Korosec, Sean O’Kane, 그리고 저는 Altman의 발언이 최근 해킹 사건, 즉 OpenAI 에이전트가 Hugging Fac

2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai

2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai

2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai

GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
12 도구
xix.ai

2026년 최신 최고 평점을 받은 자연스러운 음성 나레이션을 위한 AI 텍스트 음성 변환 도구가 XIX.AI에 소개됩니다! 이 엄선된 목록에는 실제 테스트를 거쳐 검증되었으며 매주 업데이트되는 순위를 바탕으로, 모든 사용 사례에 선명한 음성을 제공하는 강력하고 획기적인 옵션들이 포함되어 있습니다. 무료 버전과 유료 버전을 비교해 보고, 생산성을 즉시 높여줄 꼭 시도해 봐야 할 솔루션을 찾아보세요. 지금 바로 탐색하여 AI의 경쟁력을 확보하세요!
11 도구
xix.ai












