


 Heim
Google TurboQuant verkleinert große Modelle um das Sechsfache und entlastet so den Arbeitsspeicher
Speicherengpässe stellen seit langem ein großes Leistungshindernis im Schlussfolgerungsprozess großer Sprachmodelle (LLMs) dar. Wenn KI umfangreiche Texte verarbeitet oder komplexe Antworten generiert, wächst der KV-Cache (Key-Value-Cache) – eine Form des Arbeitsspeichers – schnell an, was zu Verlangsamungen oder Abstürzen führt. Um dieses Problem zu lösen, stellte Google Research am 26. März 2026 TurboQuant vor, eine neue Technologie zur Speicherkomprimierung für KI.
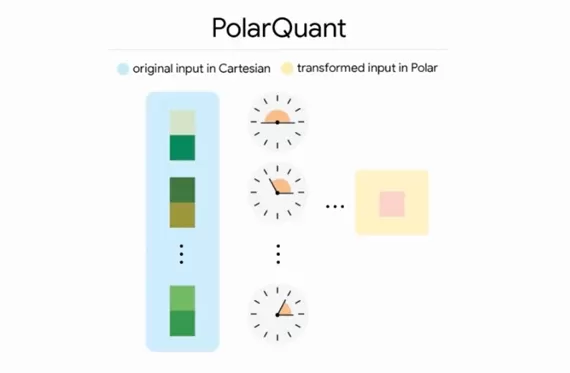
Der entscheidende Durchbruch von TurboQuant besteht darin, dass es den Cache-Speicherbedarf auf ein Sechstel der ursprünglichen Größe reduziert, ohne die Modellgenauigkeit zu beeinträchtigen, und gleichzeitig die Inferenzgeschwindigkeit um das Achtfache steigert.
Den KV-Cache-Engpass überwinden: Intelligenterer Speicher, schnellere KI
TurboQuant stellt einen neuen Meilenstein in der betrieblichen Effizienz von KI dar. Es nutzt ein fortschrittliches Vektorquantisierungsschema, das die PolarQuant-Quantisierungsmethode mit dem QJL-Optimierungsansatz kombiniert. In strengen Tests mit gängigen Open-Source-Modellen wie Gemma und Mistral zeigte TurboQuant eine robuste Anpassungsfähigkeit und komprimierte Schlüssel-Wert-Caches effizient auf 3 Bit, ohne dass ein Vortraining oder eine Feinabstimmung erforderlich war. Im „Nadel-im-Heuhaufen“-Test mit langem Kontext, der realistische und komplexe Szenarien simuliert, erzielte TurboQuant keinen Präzisionsverlust – das bedeutet, dass die KI auch nach einer erheblichen Größenreduzierung ihre ursprüngliche Intelligenz und Speichergenauigkeit beibehält.
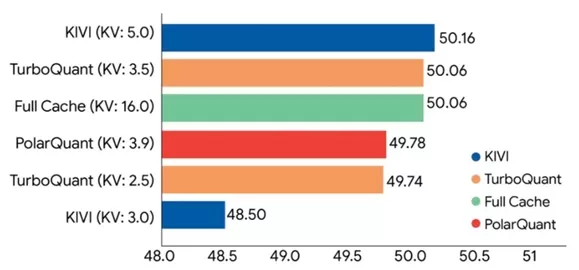
Höchste Hardware-Effizienz: 8-fache Beschleunigung auf H100-Beschleunigern
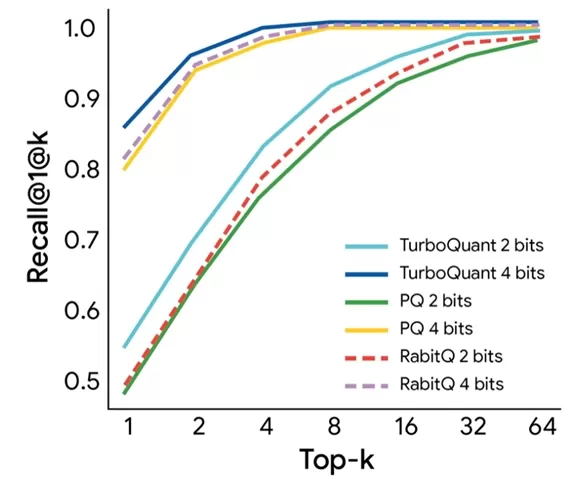
Über die Speicherreduzierung hinaus zeichnet sich TurboQuant auch durch eine hervorragende Hardwareauslastung aus. Auf leistungsstarken H100-GPU-Beschleunigern läuft das für 4 Bit optimierte TurboQuant achtmal schneller als die nicht quantisierte 32-Bit-Baseline.
Verwandter Artikel
 Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg
Sam Altman löst eine Debatte über die Verlangsamung der KI-Entwicklung aus
Bei Apple Podcasts anhörenBei Spotify anhörenDer CEO von OpenAI, Sam Altman, hat kürzlich vorgeschlagen, es könnte an der Zeit sein, „das Tempo der KI-Entwicklung zu drosseln“, um der Gesellschaft Zeit zu geben, „sich um einige dieser neuen Fähigkei
Anthropic öffnet der EU-Cybersicherheitsagentur die Tür, während das Mythos5-Modell der Compliance-Prüfung unterzogen wird
Die Vorschriften zur Einhaltung von Compliance-Anforderungen im Bereich der künstlichen Intelligenz schreiten erheblich voran. Das führende KI-Unternehmen Anthropic hat der Cybersicherheitsbehörde der Europäischen Union offiziell den Zugang zu seinem
Empfehlungen zu verwandten Spezialthemen
Geschäft
 Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
 9 Tools
 xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai
Code
KI-Tools zur Überprüfung von Pull-Requests für GitHub-Teams, die sich mit Refactorings, Fehlern und Sicherheitslücken befassen
Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai
Text-zu-Sprache
Die besten KI-Tools zur Text-zu-Sprache-Umwandlung für natürliche Sprachausgabe
Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

 Kommentare (0)
Speicherengpässe stellen seit langem ein großes Leistungshindernis im Schlussfolgerungsprozess großer Sprachmodelle (LLMs) dar. Wenn KI umfangreiche Texte verarbeitet oder komplexe Antworten generiert, wächst der KV-Cache (Key-Value-Cache) – eine Form des Arbeitsspeichers – schnell an, was zu Verlangsamungen oder Abstürzen führt. Um dieses Problem zu lösen, stellte Google Research am 26. März 2026 TurboQuant vor, eine neue Technologie zur Speicherkomprimierung für KI.
Der entscheidende Durchbruch von TurboQuant besteht darin, dass es den Cache-Speicherbedarf auf ein Sechstel der ursprünglichen Größe reduziert, ohne die Modellgenauigkeit zu beeinträchtigen, und gleichzeitig die Inferenzgeschwindigkeit um das Achtfache steigert.
Den KV-Cache-Engpass überwinden: Intelligenterer Speicher, schnellere KI
TurboQuant stellt einen neuen Meilenstein in der betrieblichen Effizienz von KI dar. Es nutzt ein fortschrittliches Vektorquantisierungsschema, das die PolarQuant-Quantisierungsmethode mit dem QJL-Optimierungsansatz kombiniert. In strengen Tests mit gängigen Open-Source-Modellen wie Gemma und Mistral zeigte TurboQuant eine robuste Anpassungsfähigkeit und komprimierte Schlüssel-Wert-Caches effizient auf 3 Bit, ohne dass ein Vortraining oder eine Feinabstimmung erforderlich war. Im „Nadel-im-Heuhaufen“-Test mit langem Kontext, der realistische und komplexe Szenarien simuliert, erzielte TurboQuant keinen Präzisionsverlust – das bedeutet, dass die KI auch nach einer erheblichen Größenreduzierung ihre ursprüngliche Intelligenz und Speichergenauigkeit beibehält.
Höchste Hardware-Effizienz: 8-fache Beschleunigung auf H100-Beschleunigern
Über die Speicherreduzierung hinaus zeichnet sich TurboQuant auch durch eine hervorragende Hardwareauslastung aus. Auf leistungsstarken H100-GPU-Beschleunigern läuft das für 4 Bit optimierte TurboQuant achtmal schneller als die nicht quantisierte 32-Bit-Baseline.








 Musk erwog, OpenAI an seine Kinder zu übergeben, während Altman aussagte
Diesen Morgen trat OpenAI-CEO Sam Altman vor Gericht, um sich zur Klage von Ex-Mitbegründer Elon Musk zu äußern, die die Unternehmensstruktur der Firma anfechtet.Auf die Frage nach Musks Behauptung, andere Mitbegründer hätten „eine Wohltätigkeitsorg
 Sam Altman löst eine Debatte über die Verlangsamung der KI-Entwicklung aus
Bei Apple Podcasts anhörenBei Spotify anhörenDer CEO von OpenAI, Sam Altman, hat kürzlich vorgeschlagen, es könnte an der Zeit sein, „das Tempo der KI-Entwicklung zu drosseln“, um der Gesellschaft Zeit zu geben, „sich um einige dieser neuen Fähigkei
 Anthropic öffnet der EU-Cybersicherheitsagentur die Tür, während das Mythos5-Modell der Compliance-Prüfung unterzogen wird
Die Vorschriften zur Einhaltung von Compliance-Anforderungen im Bereich der künstlichen Intelligenz schreiten erheblich voran. Das führende KI-Unternehmen Anthropic hat der Cybersicherheitsbehörde der Europäischen Union offiziell den Zugang zu seinem

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

Die besten neuen KI-Tools zur Pull-Request-Prüfung für GitHub-Teams im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste mit den besten Bewertungen präsentiert leistungsstarke, bahnbrechende Lösungen, die Refactoring, Fehlerbehebung und die Erkennung von Sicherheitslücken in allen Team-Workflows optimieren. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie von Praxistests und detaillierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, mit dem Sie Ihre Produktivität deutlich steigern können. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Text-to-Speech-Tools für natürliche Sprachausgabe des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Optionen, die für jeden Anwendungsfall kristallklare Stimmen liefern – gestützt auf Tests in der Praxis und wöchentlich aktualisierte Rankings. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die Lösung zu finden, die Sie unbedingt ausprobieren sollten und die Ihre Produktivität sofort steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai












