


 家
Googleの「TurboQuant」が大型モデルを6分の1に縮小し、メモリ負荷を軽減
メモリのボトルネックは、大規模言語モデル(LLM)の推論プロセスにおいて、長年にわたり主要なパフォーマンス上の課題となってきました。 AIが長文を処理したり、複雑な応答を生成したりする際、ワーキングメモリの一種であるKVキャッシュ(キーバリューキャッシュ)が急速に膨張し、処理速度の低下やクラッシュを引き起こします。この問題に対処するため、Google Researchは2026年3月26日、新しいAIメモリ圧縮技術「TurboQuant」を発表しました。
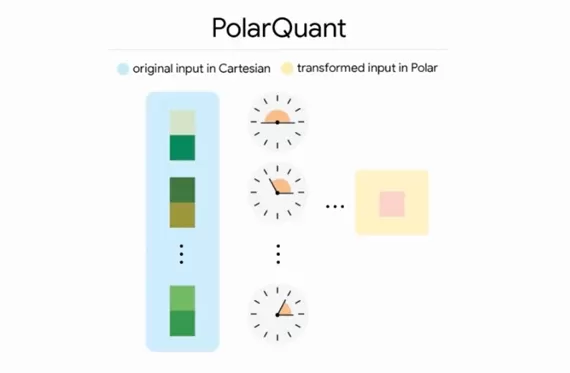
TurboQuantの最大の画期的な点は、モデルの精度を損なうことなくキャッシュメモリの使用量を元の6分の1に削減しつつ、推論速度を8倍も向上させることにあります。
KVキャッシュのボトルネックを打破:よりスマートなメモリ、より高速なAI
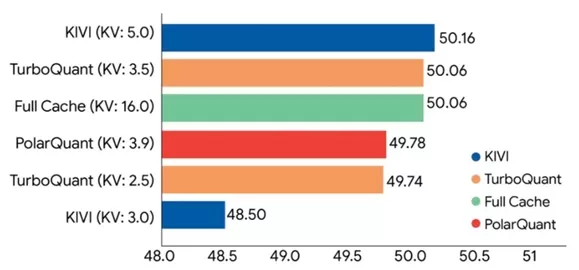
TurboQuantは、AIの運用効率における新たなマイルストーンとなります。これは、PolarQuant量子化手法とQJL最適化アプローチを組み合わせた、高度なベクトル量子化スキームを採用しています。 GemmaやMistralといった一般的なオープンソースモデルを用いた厳格なテストにおいて、TurboQuantは優れた適応性を示し、事前学習や微調整を一切必要とせずにキーバリューキャッシュを3ビットまで効率的に圧縮しました。 現実的で複雑なシナリオをシミュレートする「干し草の山の中の針」と呼ばれる長文コンテキストテストにおいて、TurboQuantは精度の低下をゼロに抑えました。つまり、大幅なサイズ削減後も、AIは本来の知能と記憶の正確性を維持しているということです。
ハードウェア効率の最大化:H100アクセラレータで8倍の高速化
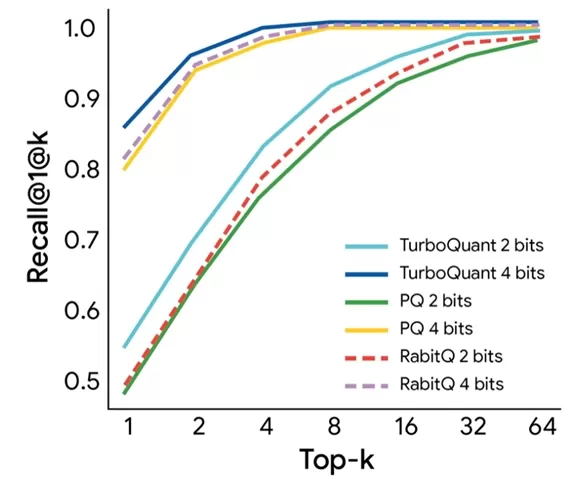
メモリ削減に加え、TurboQuantはハードウェアの利用効率においても優れた性能を発揮します。高性能なH100 GPUアクセラレータ上で、4ビットに最適化されたTurboQuantは、量子化されていない32ビットのベースラインと比較して8倍の速度で動作します。
関連記事
 アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
Anthropic、EUサイバーセキュリティ機関に門戸を開く、Mythos5モデルがコンプライアンス試験に直面
人工知能のコンプライアンス規制は大幅に進展している。主要なAI企業であるAnthropicは、欧州連合(EU)のサイバーセキュリティ機関に対し、そのMythos AIモデルへのアクセスを正式に許可した。これは、この高度な大規模言語モデルが欧州市場に進出し、現地の規制要件に適合する上で重要な一歩である。この公開アクセスは、両者間の広範な対話と交渉の結果である。欧州委員会のスポークスパーソンのトーマス・レグニエール氏は、建設的な議論を経て、欧州連合サイバーセキュリティ機関(ENISA)がMytho
関連特集おすすめ
画像編集
 EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
 10 ツール
 xix.ai
プロンプト
ChatGPTワークフローに最適なAIプロンプトライブラリ
2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai
教育と学習
教師、チューター、およびコホート型学習プログラム向けのAIクイズビルダープラットフォーム
2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai
コード
リファクタリング、バグ、セキュリティ上の脆弱性を扱うGitHubチーム向けのAIプルリクエストレビューツール
2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai
テキスト読み上げ
自然なナレーションを実現する、おすすめのAIテキスト読み上げツール
2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai
漫画制作
連載作品の各話、表紙、プロモーション用イラスト向けのマンガAI背景生成ツール
2026年最新・最高評価のマンガ用AI背景生成ツールランキング!この厳選コレクションでは、高品質な章の背景、書籍の表紙、プロモーション用イラストの作成に最適な、画期的な強力なツールをご紹介しています。すべてのツールは、信頼性を確保するために実環境での厳格なテストを経ています。 無料版と有料版の比較や詳細な解説も併せてご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、マンガ制作においてAIの力を最大限に活用しましょう。
6 ツール
xix.ai

 コメント (0)
0/500
メモリのボトルネックは、大規模言語モデル(LLM)の推論プロセスにおいて、長年にわたり主要なパフォーマンス上の課題となってきました。 AIが長文を処理したり、複雑な応答を生成したりする際、ワーキングメモリの一種であるKVキャッシュ(キーバリューキャッシュ)が急速に膨張し、処理速度の低下やクラッシュを引き起こします。この問題に対処するため、Google Researchは2026年3月26日、新しいAIメモリ圧縮技術「TurboQuant」を発表しました。
TurboQuantの最大の画期的な点は、モデルの精度を損なうことなくキャッシュメモリの使用量を元の6分の1に削減しつつ、推論速度を8倍も向上させることにあります。
KVキャッシュのボトルネックを打破:よりスマートなメモリ、より高速なAI
TurboQuantは、AIの運用効率における新たなマイルストーンとなります。これは、PolarQuant量子化手法とQJL最適化アプローチを組み合わせた、高度なベクトル量子化スキームを採用しています。 GemmaやMistralといった一般的なオープンソースモデルを用いた厳格なテストにおいて、TurboQuantは優れた適応性を示し、事前学習や微調整を一切必要とせずにキーバリューキャッシュを3ビットまで効率的に圧縮しました。 現実的で複雑なシナリオをシミュレートする「干し草の山の中の針」と呼ばれる長文コンテキストテストにおいて、TurboQuantは精度の低下をゼロに抑えました。つまり、大幅なサイズ削減後も、AIは本来の知能と記憶の正確性を維持しているということです。
ハードウェア効率の最大化:H100アクセラレータで8倍の高速化
メモリ削減に加え、TurboQuantはハードウェアの利用効率においても優れた性能を発揮します。高性能なH100 GPUアクセラレータ上で、4ビットに最適化されたTurboQuantは、量子化されていない32ビットのベースラインと比較して8倍の速度で動作します。








 アルトマン証言の中で、マスクはOpenAIを子供たちに譲ることを検討した
今朝、OpenAIのCEOサム・アルトマン氏は、同社の企業構造に異議を唱える元共同創設者エロン・マスク氏の訴訟に対応するため証言台に立った。「営利子会社を設立してAI搭載製品を市場に出すことで、他の創設者たちが『慈善団体を盗んだ』」というマスク氏の主張について問われると、アルトマン氏は明らかなためらいを示して応答した。「その枠組みを処理するのは難しい」と、アルトマン氏は一時の間を置いて語った。「私たちは世界最大の慈善団体の一つを設立した。財団は素晴らしい活動を行っており、今後もさらに多くのこ
 サム・アルトマン氏によるAIの減速論が議論を呼ぶ
Apple Podcastsで聴くSpotifyで聴くOpenAIのCEO、サム・アルトマン氏は最近、社会が「これらの新しい能力レベルのいくつかに対して強固になる」時間を確保するため、「AI開発の速度を制御する」時期が来た可能性を示唆した。TechCrunchの「Equity」ポッドキャストの最新回で、ケルステン・コロセック、ショーン・Oケイン、そして私自身は、アルトマン氏の発言が、OpenAIのエージェントがHugging Faceのシステムに侵入した最近のハッキング事件をきっかけとしたも
 Anthropic、EUサイバーセキュリティ機関に門戸を開く、Mythos5モデルがコンプライアンス試験に直面
人工知能のコンプライアンス規制は大幅に進展している。主要なAI企業であるAnthropicは、欧州連合(EU)のサイバーセキュリティ機関に対し、そのMythos AIモデルへのアクセスを正式に許可した。これは、この高度な大規模言語モデルが欧州市場に進出し、現地の規制要件に適合する上で重要な一歩である。この公開アクセスは、両者間の広範な対話と交渉の結果である。欧州委員会のスポークスパーソンのトーマス・レグニエール氏は、建設的な議論を経て、欧州連合サイバーセキュリティ機関(ENISA)がMytho

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

2026年版:あらゆる種類のChatGPTワークフローを最適化するための、最新かつ最高評価のAIプロンプトライブラリ。XIX.AIは、最高のパフォーマンスを保証するために厳格な実環境テストを経た、強力で画期的なコレクションを厳選しました。 無料版と有料版の詳細な比較や専門家によるランキングを参考に、生産性を高め、AIの真の力を引き出す「必試」ツールを選んでください。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新版 教師、チューター、コホート型学習プログラム向けベストAIクイズビルダープラットフォーム!XIX.AIは、実世界のテストを経て正確なランキングを提供する革新的なツールの中から、高評価のリストを厳選しました。これらの必須プラットフォームは、すべての学習シナリオにおいて、作成効率の向上、コンテンツ制作の効率化、クイズ設計の簡素化を支援します。今すぐ探索して、教育におけるAIの優位性を引き出すための完璧なツールを見つけましょう!
13 ツール
xix.ai

2026年版、GitHubチーム向けの最新・最高のAIプルリクエストレビューツールがXIX.AIに登場!この厳選された高評価リストでは、あらゆるチームワークフローにおいて、リファクタリング、バグ修正、セキュリティ上の脆弱性の検出を効率化する、画期的なソリューションを紹介しています。 無料版と有料版の比較に加え、実環境でのテスト結果や詳細なランキングも掲載されており、生産性を大幅に向上させる最適なツールを見つけるのに役立ちます。今すぐチェックして、AIの力を最大限に活用しましょう!
12 ツール
xix.ai

2026年最新の、自然なナレーションを実現する高評価のAIテキスト読み上げツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと毎週更新されるランキングに基づいた、あらゆるユースケースでクリアな音声を再生する、強力で画期的なツールが紹介されています。 無料版と有料版の比較情報を確認して、生産性を即座に高める「必試」のソリューションを見つけましょう。今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

2026年最新・最高評価のマンガ用AI背景生成ツールランキング!この厳選コレクションでは、高品質な章の背景、書籍の表紙、プロモーション用イラストの作成に最適な、画期的な強力なツールをご紹介しています。すべてのツールは、信頼性を確保するために実環境での厳格なテストを経ています。 無料版と有料版の比較や詳細な解説も併せてご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけ、マンガ制作においてAIの力を最大限に活用しましょう。
6 ツール
xix.ai












