


 Hogar
¿Pueden las ondas cerebrales desbloquear la IA física?
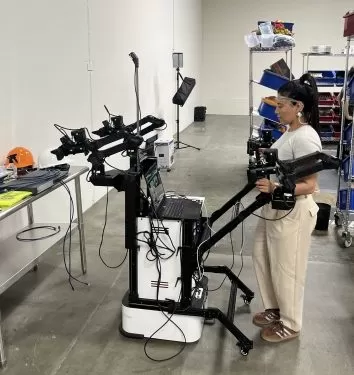
La frontera de la inteligencia artificial física se asemeja a un juego de Jenga de alto riesgo dentro de un almacén en San Leandro, California.
Encord opera en este espacio, proporcionando herramientas de datos para el entrenamiento de modelos de IA. Andrew Ceja, un «piloto» (término de Encord para los entrenadores robóticos), extrae con cuidado bloques de madera de una torre inestable mientras lleva un casco equipado con cámara. Esta configuración es estándar para la recopilación de datos de entrenamiento de robots, pero el casco de Ceja también cuenta con sensores que registran sus ondas cerebrales mientras desmonta la estructura.
Encord está entre un número creciente de startups que apuestan a que el principal cuello de botella para la robótica humanoides y de almacén no es la arquitectura del modelo, sino la escasez de datos de entrenamiento físico del mundo real. En lugar de simplemente gestionar datos existentes, Encord está construyendo un modelo de negocio en torno a la generación de los datos que les faltan a las empresas de robótica.
El casco de ondas cerebrales que lleva Ceja fue desarrollado por Zander Labs, una startup alemana de neurociencia. Creen que medir la actividad cerebral para inferir estados mentales, como error, intención o sorpresa, puede generar conjuntos de datos más valiosos para entrenar modelos. La colaboración de Encord con Zander es actualmente una prueba; el objetivo es crear un conjunto de datos inicial etiquetado con ondas cerebrales, probarlo contra los modelos robóticos de los clientes y evaluar las mejoras de rendimiento antes de escalar.
Lucas Gehrke, un neurocientífico de Zander que supervisa el proyecto, señala que el nivel de actividad cerebral durante tareas específicas proporciona pistas a los desarrolladores de modelos sobre cuándo desplegar modelos de alto esfuerzo.
Vineeth Velmurugan, jefe de aprendizaje robótico de Encord, describe esto como la «frontera sangrante» de resolver el cuello de botella de datos de robótica. Veterano del laboratorio de robots de OpenAI y Berkshire Grey, una empresa de automatización de almacenes, Velmurugan se unió a Encord para establecer su equipo interno de creación de datos.
Encord fue fundado originalmente para ayudar a las empresas que construyen aplicaciones de visión artificial con la anotación de datos y la evaluación de modelos. A medida que los clientes, muchas empresas líderes de robótica, aunque no nombradas por Velmurugan, comenzaron a aplicar el aprendizaje de extremo a extremo a la manipulación robótica, los ejecutivos se dieron cuenta de que necesitaban generar datos de entrenamiento en lugar de solo gestionarlos. «Los datos simplemente no existen», afirmó Velmurugan.
La suposición de que la IA generativa puede revolucionar la robótica como lo hizo con los chatbots sigue chocando contra la misma pared. Los LLM se entrenaron con todo el texto de internet y más. Adquirir materias primas equivalentes para enseñar a las redes neuronales sobre la manipulación física es difícil: las empresas de coches autónomos recopilan sus propios datos, pero esto es difícil de escalar. Aunque es posible entrenar a partir de vídeo, carece de la fidelidad de los datos del mundo real. Velmurugan estima que se necesita un conjunto de datos cinco veces más grande que el corpus de vídeos de YouTube para superar este obstáculo, lo que explica por qué la generación de datos se ha convertido en un negocio independiente en lugar de solo un desafío de investigación.
Alimenta tus necesidades de datos egocéntricos
Los desarrolladores de robótica ahora dependen de dos fuentes principales: vídeo «egocéntrico» capturado por trabajadores que llevan cámaras (a menudo complementado con ángulos y métricas adicionales) y datos de robots operados a distancia. Encord utiliza ambas, recopilando datos egocéntricos de fábricas de todo el mundo y utilizando sus instalaciones en San Leandro para experimentar con nuevas modalidades, como las ondas cerebrales, o para recopilar conjuntos de datos centrados en habilidades específicas para el ajuste fino.
Durante una visita de TechCrunch, los pilotos utilizaron rigs de líder-seguidor, brazos robóticos emparejados donde uno es controlado directamente por un humano y el otro imita sus movimientos, para generar datos para tareas como verter café (que tiende a salpicar) y apilar fichas de póquer. «Todas las empresas humanoides han solicitado estos conjuntos de datos», señaló Velmurugan.
Las estanterías de almacenamiento contenían cajas de flores falsas en jarrones, libros, verduras de plástico, bandejas y palas para arena de gatos, bolsas y haces de cables, accesorios esenciales para entrenar manipuladores para tareas domésticas.
En una estación, otro piloto, Sofia Infante, maniobraba brazos robóticos para enchufar y desenchufar cables de red desde la parte trasera de los servidores, una tarea que los operadores de centros de datos amarían automatizar, siempre que los robots pudieran manipularlos con suficiente precisión. Operar los controles yo mismo reveló por qué esto sigue fuera de alcance: las pinzas robóticas son mucho menos diestras que los dedos humanos y carecen de los grados de libertad que damos por sentados.
Encord también está desarrollando una nueva modalidad de datos utilizando sensores sujetos al antebrazo para detectar señales eléctricas musculares. Dado que el vídeo de las manos humanas a menudo no captura toda la mano, Velmurugan tiene como objetivo crear una representación 3D de la posición de la mano basada en los datos del sensor del brazo, proporcionando a los modelos una comprensión más sólida.
Los conjuntos de datos de Encord están anotados con descripciones físicas del contenido del vídeo, como «la mano derecha aprieta el perno», para ayudar a los modelos basados en LLM a comprender las acciones. Velmurugan estima que esta anotación densa es 100 veces más valiosa que los «datos egocéntricos basura» para entrenar tareas específicas, con un coste solo 20 veces mayor de producir, un intercambio favorable sobre el papel.
Sin embargo, «20 veces más» representa dinero real, que es el truco: extraer texto de internet para construir LLM a partir de fuentes como Stack Overflow costó a los laboratorios de frontera casi nada. Generar datos de entrenamiento físico no, lo que destaca el límite de comparar la IA física con los LLM. Estos datos deben fabricarse, no solo recopilados, cambiando fundamentalmente la economía del desarrollo de modelos.
Velmurugan cree que se están haciendo progresos. Con la visibilidad de Encord en los programas de la industria, observa a startups y laboratorios de frontera determinando qué funciona para mejorar los modelos de IA física. Esta perspectiva, posicionada entre múltiples empresas de robótica, es parte de la propuesta de valor de Encord, lo que les permite identificar técnicas de datos que ganan tracción en toda la industria antes de que lo haga cualquier cliente individual.
Esto mantendrá ocupados a una docena de pilotos en las instalaciones de Encord. Tanto Infante como Ceja forman parte de una fuerza laboral creciente que desarrolla bloques de construcción de redes neuronales; anteriormente trabajaron en Scale, otra empresa de anotación de datos de IA, antes de unirse a Encord.
Ceja trabajó anteriormente en una empresa de gestión de residuos, donde su interés por la tecnología le llevó a mantener un clasificador robótico de basura. Ahora, mientras se derrumba la torre de Jenga, disfruta del desafío de resolver tareas de entrenamiento para robots: «¡Es algo nuevo cada día!»
Artículo relacionado
 El inicio de inteligencia artificial del ex director ejecutivo de Infosys asegura otros 53 millones de dólares
Hang Ten Systems, una startup de inteligencia artificial fundada por el ex CEO de Infosys, Vishal Sikka, hace apenas cuatro meses, ha asegurado $53 millones adicionales en financiación semilla. Esta última ronda de inversión se cerró apenas cinco sem
La plataforma de intercambio de criptomonedas OKX pretende permitir que los agentes de IA se contraten y se paguen entre sí
A medida que los agentes de IA comienzan a prestar servicio a particulares y a colaborar entre sí, necesitan mecanismos para identificar tareas, recibir una compensación por sus servicios y establecer
Una startup respaldada por Thiel afirma que la inteligencia artificial puede evaluar el periodismo, a pesar de los riesgos que esto supone para los denunciantes
Tras su participación en la demanda que provocó la quiebra de Gawker, Aron D’Souza detectó una falla fundamental en el panorama mediático estadounidense: las personas perjudicadas por la cobertura med
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Herramientas de referencia de estilos visuales basadas en IA para fichas de personajes, moodboards y presentaciones
¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
 11 herramientas
 xix.ai
SEO
Las mejores herramientas de análisis de SERP basadas en IA para la estrategia de búsqueda
Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai
Análisis de datos
Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

 comentario (0)
0/500
La frontera de la inteligencia artificial física se asemeja a un juego de Jenga de alto riesgo dentro de un almacén en San Leandro, California.
Encord opera en este espacio, proporcionando herramientas de datos para el entrenamiento de modelos de IA. Andrew Ceja, un «piloto» (término de Encord para los entrenadores robóticos), extrae con cuidado bloques de madera de una torre inestable mientras lleva un casco equipado con cámara. Esta configuración es estándar para la recopilación de datos de entrenamiento de robots, pero el casco de Ceja también cuenta con sensores que registran sus ondas cerebrales mientras desmonta la estructura.
Encord está entre un número creciente de startups que apuestan a que el principal cuello de botella para la robótica humanoides y de almacén no es la arquitectura del modelo, sino la escasez de datos de entrenamiento físico del mundo real. En lugar de simplemente gestionar datos existentes, Encord está construyendo un modelo de negocio en torno a la generación de los datos que les faltan a las empresas de robótica.
El casco de ondas cerebrales que lleva Ceja fue desarrollado por Zander Labs, una startup alemana de neurociencia. Creen que medir la actividad cerebral para inferir estados mentales, como error, intención o sorpresa, puede generar conjuntos de datos más valiosos para entrenar modelos. La colaboración de Encord con Zander es actualmente una prueba; el objetivo es crear un conjunto de datos inicial etiquetado con ondas cerebrales, probarlo contra los modelos robóticos de los clientes y evaluar las mejoras de rendimiento antes de escalar.
Lucas Gehrke, un neurocientífico de Zander que supervisa el proyecto, señala que el nivel de actividad cerebral durante tareas específicas proporciona pistas a los desarrolladores de modelos sobre cuándo desplegar modelos de alto esfuerzo.
Vineeth Velmurugan, jefe de aprendizaje robótico de Encord, describe esto como la «frontera sangrante» de resolver el cuello de botella de datos de robótica. Veterano del laboratorio de robots de OpenAI y Berkshire Grey, una empresa de automatización de almacenes, Velmurugan se unió a Encord para establecer su equipo interno de creación de datos.
Encord fue fundado originalmente para ayudar a las empresas que construyen aplicaciones de visión artificial con la anotación de datos y la evaluación de modelos. A medida que los clientes, muchas empresas líderes de robótica, aunque no nombradas por Velmurugan, comenzaron a aplicar el aprendizaje de extremo a extremo a la manipulación robótica, los ejecutivos se dieron cuenta de que necesitaban generar datos de entrenamiento en lugar de solo gestionarlos. «Los datos simplemente no existen», afirmó Velmurugan.
La suposición de que la IA generativa puede revolucionar la robótica como lo hizo con los chatbots sigue chocando contra la misma pared. Los LLM se entrenaron con todo el texto de internet y más. Adquirir materias primas equivalentes para enseñar a las redes neuronales sobre la manipulación física es difícil: las empresas de coches autónomos recopilan sus propios datos, pero esto es difícil de escalar. Aunque es posible entrenar a partir de vídeo, carece de la fidelidad de los datos del mundo real. Velmurugan estima que se necesita un conjunto de datos cinco veces más grande que el corpus de vídeos de YouTube para superar este obstáculo, lo que explica por qué la generación de datos se ha convertido en un negocio independiente en lugar de solo un desafío de investigación.
Alimenta tus necesidades de datos egocéntricos
Los desarrolladores de robótica ahora dependen de dos fuentes principales: vídeo «egocéntrico» capturado por trabajadores que llevan cámaras (a menudo complementado con ángulos y métricas adicionales) y datos de robots operados a distancia. Encord utiliza ambas, recopilando datos egocéntricos de fábricas de todo el mundo y utilizando sus instalaciones en San Leandro para experimentar con nuevas modalidades, como las ondas cerebrales, o para recopilar conjuntos de datos centrados en habilidades específicas para el ajuste fino.
Durante una visita de TechCrunch, los pilotos utilizaron rigs de líder-seguidor, brazos robóticos emparejados donde uno es controlado directamente por un humano y el otro imita sus movimientos, para generar datos para tareas como verter café (que tiende a salpicar) y apilar fichas de póquer. «Todas las empresas humanoides han solicitado estos conjuntos de datos», señaló Velmurugan.
Las estanterías de almacenamiento contenían cajas de flores falsas en jarrones, libros, verduras de plástico, bandejas y palas para arena de gatos, bolsas y haces de cables, accesorios esenciales para entrenar manipuladores para tareas domésticas.
En una estación, otro piloto, Sofia Infante, maniobraba brazos robóticos para enchufar y desenchufar cables de red desde la parte trasera de los servidores, una tarea que los operadores de centros de datos amarían automatizar, siempre que los robots pudieran manipularlos con suficiente precisión. Operar los controles yo mismo reveló por qué esto sigue fuera de alcance: las pinzas robóticas son mucho menos diestras que los dedos humanos y carecen de los grados de libertad que damos por sentados.
Encord también está desarrollando una nueva modalidad de datos utilizando sensores sujetos al antebrazo para detectar señales eléctricas musculares. Dado que el vídeo de las manos humanas a menudo no captura toda la mano, Velmurugan tiene como objetivo crear una representación 3D de la posición de la mano basada en los datos del sensor del brazo, proporcionando a los modelos una comprensión más sólida.
Los conjuntos de datos de Encord están anotados con descripciones físicas del contenido del vídeo, como «la mano derecha aprieta el perno», para ayudar a los modelos basados en LLM a comprender las acciones. Velmurugan estima que esta anotación densa es 100 veces más valiosa que los «datos egocéntricos basura» para entrenar tareas específicas, con un coste solo 20 veces mayor de producir, un intercambio favorable sobre el papel.
Sin embargo, «20 veces más» representa dinero real, que es el truco: extraer texto de internet para construir LLM a partir de fuentes como Stack Overflow costó a los laboratorios de frontera casi nada. Generar datos de entrenamiento físico no, lo que destaca el límite de comparar la IA física con los LLM. Estos datos deben fabricarse, no solo recopilados, cambiando fundamentalmente la economía del desarrollo de modelos.
Velmurugan cree que se están haciendo progresos. Con la visibilidad de Encord en los programas de la industria, observa a startups y laboratorios de frontera determinando qué funciona para mejorar los modelos de IA física. Esta perspectiva, posicionada entre múltiples empresas de robótica, es parte de la propuesta de valor de Encord, lo que les permite identificar técnicas de datos que ganan tracción en toda la industria antes de que lo haga cualquier cliente individual.
Esto mantendrá ocupados a una docena de pilotos en las instalaciones de Encord. Tanto Infante como Ceja forman parte de una fuerza laboral creciente que desarrolla bloques de construcción de redes neuronales; anteriormente trabajaron en Scale, otra empresa de anotación de datos de IA, antes de unirse a Encord.
Ceja trabajó anteriormente en una empresa de gestión de residuos, donde su interés por la tecnología le llevó a mantener un clasificador robótico de basura. Ahora, mientras se derrumba la torre de Jenga, disfruta del desafío de resolver tareas de entrenamiento para robots: «¡Es algo nuevo cada día!»








 El inicio de inteligencia artificial del ex director ejecutivo de Infosys asegura otros 53 millones de dólares
Hang Ten Systems, una startup de inteligencia artificial fundada por el ex CEO de Infosys, Vishal Sikka, hace apenas cuatro meses, ha asegurado $53 millones adicionales en financiación semilla. Esta última ronda de inversión se cerró apenas cinco sem
 La plataforma de intercambio de criptomonedas OKX pretende permitir que los agentes de IA se contraten y se paguen entre sí
A medida que los agentes de IA comienzan a prestar servicio a particulares y a colaborar entre sí, necesitan mecanismos para identificar tareas, recibir una compensación por sus servicios y establecer
 Una startup respaldada por Thiel afirma que la inteligencia artificial puede evaluar el periodismo, a pesar de los riesgos que esto supone para los denunciantes
Tras su participación en la demanda que provocó la quiebra de Gawker, Aron D’Souza detectó una falla fundamental en el panorama mediático estadounidense: las personas perjudicadas por la cobertura med

¡Ya están aquí, en XIX.AI, las mejores y más recientes herramientas de referencia de estilos visuales con IA para fichas de personajes, moodboards y presentaciones de proyectos! Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado rigurosas pruebas en el mundo real. Encontrarás una comparación entre opciones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles que te ayudarán a potenciar tu creatividad y optimizar tu flujo de trabajo. ¡Explora ahora mismo la lista para descubrir la herramienta perfecta que te permita aumentar tu productividad!
11 herramientas
xix.ai

Las mejores herramientas de análisis de SERP con IA mejor valoradas de 2026 para la estrategia de búsqueda han sido seleccionadas por XIX.AI tras rigurosas pruebas en condiciones reales y clasificaciones que se actualizan semanalmente. Estas potentes herramientas te ayudan a descubrir oportunidades de optimización ocultas, a mejorar el rendimiento de tu contenido y a obtener una ventaja competitiva en los motores de búsqueda. Descubre hoy mismo la herramienta perfecta para mejorar tu estrategia de búsqueda. ¡Explora ahora!
13 herramientas
xix.ai

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai












