


 Heim
Können Gehirnwellen physische KI freisetzen?
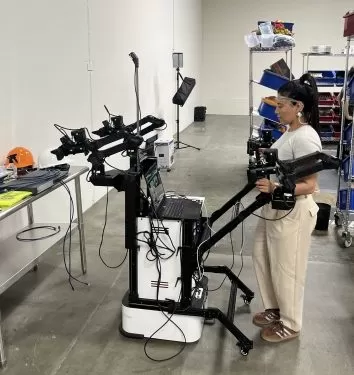
Die Grenze des Physical AI ähnelt einem hochriskanten Spiel von Jenga in einem Lagerhaus in San Leandro, Kalifornien.
Encord operiert in diesem Bereich und stellt Datentools für das Training von KI-Modellen bereit. Andrew Ceja, ein „Pilot“ (Encords Begriff für Robotertrainer), entnimmt vorsichtig Holzblöcke aus einem instabilen Turm, während er einen headset mit Kamera trägt. Diese Einrichtung ist Standard bei der Sammlung von Trainingsdaten für Roboter, doch Cejas Headset verfügt außerdem über Sensoren, die seine Gehirnwellen aufzeichnen, während er die Struktur abbaut.
Encord gehört zu einer wachsenden Zahl von Startups, die darauf setzen, dass das Hauptproblem bei humanoiden und Lagerrobotern nicht die Modellarchitektur, sondern der Mangel an realen physischen Trainingsdaten ist. Anstatt lediglich vorhandene Daten zu verwalten, baut Encord ein Geschäftsmodell um die Generierung der Daten auf, denen Roboterunternehmen fehlen.
Das Gehirnwellen-Headset, das Ceja trägt, wurde von Zander Labs entwickelt, einem deutschen Neurowissenschafts-Startup. Sie sind der Auffassung, dass die Messung der Gehirnaktivität zur Ableitung mentaler Zustände – wie Fehler, Absicht oder Überraschung – wertvollere Datensätze für das Training von Modellen liefern kann. Encords Zusammenarbeit mit Zander ist derzeit ein Versuch; das Ziel ist es, einen ersten, mit Gehirnwellen markierten Datensatz zu erstellen, ihn gegen die Robotermodelle der Kunden zu testen und Leistungsverbesserungen zu bewerten, bevor eine Skalierung erfolgt.
Lucas Gehrke, ein Neurowissenschaftler bei Zander, der das Projekt betreut, stellt fest, dass das Ausmaß der Gehirnaktivität während spezifischer Aufgaben Entwicklern von Modellen Hinweise darauf gibt, wann sie hochleistungsfähige Modelle einsetzen sollten.
Vineeth Velmurugan, Leiter des Robot Learning bei Encord, bezeichnet dies als die „Schnittstelle“ zur Lösung des Engpasses bei Roboterdaten. Als Veteran des Robotiklabors von OpenAI und von Berkshire Grey, einem Unternehmen für Lagerautomatisierung, trat Velmurugan Encord bei, um dessen internes Datenerstellungsteam aufzubauen.
Encord wurde ursprünglich gegründet, um Unternehmen, die Machine-Vision-Anwendungen entwickeln, bei der Datenannotation und Modellauswertung zu unterstützen. Als Kunden – viele führende Roboterfirmen, obwohl Velmurugan sie nicht namentlich nennt – begannen, End-to-End-Learning auf die Robotersteuerung anzuwenden, erkannten die Führungskräfte, dass sie Trainingsdaten generieren mussten, anstatt sie nur zu verwalten. „Die Daten existieren einfach nicht“, erklärte Velmurugan.
Die Annahme, dass Generative AI die Robotik so revolutionieren kann wie Chatbots, stößt weiterhin auf dieselbe Mauer. LLMs wurden mit dem gesamten Text des Internets und mehr trainiert. Es ist schwierig, gleichwertige Rohstoffe zu beschaffen, um neuronale Netze über physische Manipulation zu unterrichten: Unternehmen für autonome Fahrzeuge sammeln ihre eigenen Daten, doch diese sind schwer zu skalieren. Obwohl das Training aus Videos möglich ist, fehlt ihm die Genauigkeit realer Daten. Velmurugan schätzt, dass ein Datensatz, der fünfmal so groß ist wie das Videoarchiv von YouTube, benötigt wird, um diesen Durchbruch zu erzielen – was erklärt, warum die Datenerzeugung zu einem eigenständigen Geschäftsmodell geworden ist, anstatt nur eine Forschungsfrage zu sein.
Füttern Sie Ihre egozentrischen Datenbedürfnisse
Roboterentwickler stützen sich nun auf zwei Hauptquellen: „egozentrische“ Videos, die von Arbeitern mit Kameras aufgenommen wurden (oft ergänzt durch zusätzliche Winkel und Metriken), und Daten von ferngesteuerten Robotern. Encord nutzt beide, sammelt egozentrische Daten aus Fabriken weltweit und nutzt seine Einrichtung in San Leandro, um neue Modalitäten wie Gehirnwellen zu experimentieren oder Datensätze zu sammeln, die auf bestimmte Fähigkeiten fokussiert sind, um Feinabstimmungen vorzunehmen.
Während eines Besuchs von TechCrunch nutzten Piloten Leader-Follower-Rigging – gepaarte Roboterarme, bei denen einer direkt von einem Menschen gesteuert wird und der andere seine Bewegungen nachahmt –, um Daten für Aufgaben wie das Einschenken von Kaffee (der zum Schwenken neigt) und das Stapeln von Pokerchips zu generieren. „Jedes humane Roboterunternehmen hat diese Datensätze angefordert“, bemerkte Velmurugan.
Aufbewahrungsräume enthielten Kartons mit Kunstblumen in Vasen, Büchern, Plastikgemüse, Katzentoiletten und Schaufeln, Beuteln und Bündeln von Kabeln – essentielle Requisiten für das Training von Manipulatoren für Haushaltsaufgaben.
An einer Station manövrierte ein anderer Pilot, Sofia Infante, Roboterarme, um Ethernet-Kabel an Serverrückseiten anzuschließen und abzuziehen – eine Aufgabe, die Rechenzentrumsbetreiber gerne automatisieren würden, vorausgesetzt, Roboter könnten sie mit ausreichender Präzision handhaben. Das Bedienen der Steuerung selbst offenbarte, warum dies weiterhin unerreichbar ist: Roboterzangen sind weitafter weniger geschickt als menschliche Finger und verfügen nicht über die Freiheitsgrade, die wir als selbstverständlich ansehen.
Encord entwickelt außerdem eine neue Datenmodalität unter Verwendung von Sensoren, die am Unterarm befestigt sind, um elektrische Muskelsignale zu erkennen. Da Videos menschlicher Hände oft nicht die gesamte Hand erfassen können, zielt Velmurugan darauf ab, eine 3D-Darstellung der Handposition basierend auf den Daten der Armsensoren zu erstellen, um Modellen ein robusteres Verständnis zu bieten.
Encords Datensätze sind mit physischen Beschreibungen des Videoinhalts annotiert – wie „rechte Hand zieht Schraube fest“ –, um LLM-basierten Modellen zu helfen, Aktionen zu verstehen. Velmurugan schätzt, dass diese dichte Annotation 100-mal wertvoller ist als „minderwertige egozentrische Daten“ für das Training spezifischer Aufgaben, wobei sie nur 20-mal mehr kostet, sie zu produzieren – ein vorteilhaftes Verhältnis auf dem Papier.
„20-mal mehr“ bedeutet jedoch echtes Geld, was der Haken ist: Das Scrapen von Internettext, um LLMs aus Quellen wie Stack Overflow aufzubauen, kostete Frontier-Labors fast nichts. Die Generierung physischer Trainingsdaten ist das nicht, was die Grenzen des Vergleichs von Physical AI mit LLMs aufzeigt. Diese Daten müssen hergestellt, nicht nur gesammelt werden, was die Wirtschaftlichkeit der Modellentwicklung grundlegend verändert.
Velmurugan ist der Ansicht, dass Fortschritte erzielt werden. Mit Encords Einblick in Branchenprogramme beobachtet er Startups und Frontier-Labors, die bestimmen, was funktioniert, um Physical-AI-Modelle zu verbessern. Dieser Aussichtspunkt – positioniert zwischen mehreren Roboterunternehmen – ist Teil des Wertversprechens von Encord und ermöglicht es ihnen, Datentechniken zu identifizieren, die branchenweit an Fahrt gewinnen, bevor dies ein einzelner Kunde tut.
Dies wird die Dutzend Piloten in Encords Einrichtung beschäftigt halten. Sowohl Infante als auch Ceja sind Teil einer wachsenden Belegschaft, die neuronale Netzwerkbaukästen entwickelt; sie arbeiteten zuvor bei Scale, einem weiteren KI-Datenannotationsunternehmen, bevor sie Encord beitraten.
Ceja arbeitete zuvor bei einem Entsorgungsunternehmen, wo sein Interesse an Technologie ihn dazu brachte, einen Roboter-Abfalltrenner zu warten. Jetzt, da der Jenga-Turm zusammenbricht, genießt er die Herausforderung, Trainingsaufgaben für Roboter zu lösen: „Es ist jeden Tag etwas Neues!“
Verwandter Artikel
 Der ehemalige Chief von Infosys hat mit seinem KI-Startup erneut 53 Millionen US-Dollar gesichert.
Hang Ten Systems, ein vor nur vier Monaten von dem ehemaligen Infosys-CEO Vishal Sikka gegründetes KI-Startup, hat zusätzliche 53 Millionen US-Dollar an Seed-Finanzierung gesichert. Diese neueste Investitionsrunde wurde laut gegenüber TechCrunch bere
Die Kryptobörse OKX will KI-Agenten in die Lage versetzen, sich gegenseitig einzustellen und zu bezahlen
Da KI-Agenten zunehmend für Einzelpersonen tätig werden und miteinander zusammenarbeiten, benötigen sie Mechanismen, um Aufgaben zu finden, Dienstleistungen zu vergüten und Glaubwürdigkeit aufzubauen.
Ein von Thiel unterstütztes Start-up behauptet, KI könne journalistische Arbeit bewerten – trotz der Risiken für Whistleblower
Nach seiner Beteiligung an dem Rechtsstreit, der zur Insolvenz von Gawker führte, erkannte Aron D’Souza einen entscheidenden Mangel in der amerikanischen Medienlandschaft: Personen, denen durch die Be
Empfehlungen zu verwandten Spezialthemen
Bildung und Lernen
 KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung
Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
 10 Tools
 xix.ai
Musikkomposition
KI-Stimm-Demo-Tools für Songwriter, Hooks, Toplines und mehrsprachige Entwurfs-Sessions
2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai
Geschäft
Die besten KI-Tools zur Wettbewerbsanalyse für kleine Unternehmen
Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai
Bildbearbeitung
Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonstanz
2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai
Prompt
Die besten KI-Prompt-Bibliotheken für ChatGPT-Workflows
Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Bildung und Lernen
AI Quiz Builder Plattformen für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme
2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai

 Kommentare (0)
Die Grenze des Physical AI ähnelt einem hochriskanten Spiel von Jenga in einem Lagerhaus in San Leandro, Kalifornien.
Encord operiert in diesem Bereich und stellt Datentools für das Training von KI-Modellen bereit. Andrew Ceja, ein „Pilot“ (Encords Begriff für Robotertrainer), entnimmt vorsichtig Holzblöcke aus einem instabilen Turm, während er einen headset mit Kamera trägt. Diese Einrichtung ist Standard bei der Sammlung von Trainingsdaten für Roboter, doch Cejas Headset verfügt außerdem über Sensoren, die seine Gehirnwellen aufzeichnen, während er die Struktur abbaut.
Encord gehört zu einer wachsenden Zahl von Startups, die darauf setzen, dass das Hauptproblem bei humanoiden und Lagerrobotern nicht die Modellarchitektur, sondern der Mangel an realen physischen Trainingsdaten ist. Anstatt lediglich vorhandene Daten zu verwalten, baut Encord ein Geschäftsmodell um die Generierung der Daten auf, denen Roboterunternehmen fehlen.
Das Gehirnwellen-Headset, das Ceja trägt, wurde von Zander Labs entwickelt, einem deutschen Neurowissenschafts-Startup. Sie sind der Auffassung, dass die Messung der Gehirnaktivität zur Ableitung mentaler Zustände – wie Fehler, Absicht oder Überraschung – wertvollere Datensätze für das Training von Modellen liefern kann. Encords Zusammenarbeit mit Zander ist derzeit ein Versuch; das Ziel ist es, einen ersten, mit Gehirnwellen markierten Datensatz zu erstellen, ihn gegen die Robotermodelle der Kunden zu testen und Leistungsverbesserungen zu bewerten, bevor eine Skalierung erfolgt.
Lucas Gehrke, ein Neurowissenschaftler bei Zander, der das Projekt betreut, stellt fest, dass das Ausmaß der Gehirnaktivität während spezifischer Aufgaben Entwicklern von Modellen Hinweise darauf gibt, wann sie hochleistungsfähige Modelle einsetzen sollten.
Vineeth Velmurugan, Leiter des Robot Learning bei Encord, bezeichnet dies als die „Schnittstelle“ zur Lösung des Engpasses bei Roboterdaten. Als Veteran des Robotiklabors von OpenAI und von Berkshire Grey, einem Unternehmen für Lagerautomatisierung, trat Velmurugan Encord bei, um dessen internes Datenerstellungsteam aufzubauen.
Encord wurde ursprünglich gegründet, um Unternehmen, die Machine-Vision-Anwendungen entwickeln, bei der Datenannotation und Modellauswertung zu unterstützen. Als Kunden – viele führende Roboterfirmen, obwohl Velmurugan sie nicht namentlich nennt – begannen, End-to-End-Learning auf die Robotersteuerung anzuwenden, erkannten die Führungskräfte, dass sie Trainingsdaten generieren mussten, anstatt sie nur zu verwalten. „Die Daten existieren einfach nicht“, erklärte Velmurugan.
Die Annahme, dass Generative AI die Robotik so revolutionieren kann wie Chatbots, stößt weiterhin auf dieselbe Mauer. LLMs wurden mit dem gesamten Text des Internets und mehr trainiert. Es ist schwierig, gleichwertige Rohstoffe zu beschaffen, um neuronale Netze über physische Manipulation zu unterrichten: Unternehmen für autonome Fahrzeuge sammeln ihre eigenen Daten, doch diese sind schwer zu skalieren. Obwohl das Training aus Videos möglich ist, fehlt ihm die Genauigkeit realer Daten. Velmurugan schätzt, dass ein Datensatz, der fünfmal so groß ist wie das Videoarchiv von YouTube, benötigt wird, um diesen Durchbruch zu erzielen – was erklärt, warum die Datenerzeugung zu einem eigenständigen Geschäftsmodell geworden ist, anstatt nur eine Forschungsfrage zu sein.
Füttern Sie Ihre egozentrischen Datenbedürfnisse
Roboterentwickler stützen sich nun auf zwei Hauptquellen: „egozentrische“ Videos, die von Arbeitern mit Kameras aufgenommen wurden (oft ergänzt durch zusätzliche Winkel und Metriken), und Daten von ferngesteuerten Robotern. Encord nutzt beide, sammelt egozentrische Daten aus Fabriken weltweit und nutzt seine Einrichtung in San Leandro, um neue Modalitäten wie Gehirnwellen zu experimentieren oder Datensätze zu sammeln, die auf bestimmte Fähigkeiten fokussiert sind, um Feinabstimmungen vorzunehmen.
Während eines Besuchs von TechCrunch nutzten Piloten Leader-Follower-Rigging – gepaarte Roboterarme, bei denen einer direkt von einem Menschen gesteuert wird und der andere seine Bewegungen nachahmt –, um Daten für Aufgaben wie das Einschenken von Kaffee (der zum Schwenken neigt) und das Stapeln von Pokerchips zu generieren. „Jedes humane Roboterunternehmen hat diese Datensätze angefordert“, bemerkte Velmurugan.
Aufbewahrungsräume enthielten Kartons mit Kunstblumen in Vasen, Büchern, Plastikgemüse, Katzentoiletten und Schaufeln, Beuteln und Bündeln von Kabeln – essentielle Requisiten für das Training von Manipulatoren für Haushaltsaufgaben.
An einer Station manövrierte ein anderer Pilot, Sofia Infante, Roboterarme, um Ethernet-Kabel an Serverrückseiten anzuschließen und abzuziehen – eine Aufgabe, die Rechenzentrumsbetreiber gerne automatisieren würden, vorausgesetzt, Roboter könnten sie mit ausreichender Präzision handhaben. Das Bedienen der Steuerung selbst offenbarte, warum dies weiterhin unerreichbar ist: Roboterzangen sind weitafter weniger geschickt als menschliche Finger und verfügen nicht über die Freiheitsgrade, die wir als selbstverständlich ansehen.
Encord entwickelt außerdem eine neue Datenmodalität unter Verwendung von Sensoren, die am Unterarm befestigt sind, um elektrische Muskelsignale zu erkennen. Da Videos menschlicher Hände oft nicht die gesamte Hand erfassen können, zielt Velmurugan darauf ab, eine 3D-Darstellung der Handposition basierend auf den Daten der Armsensoren zu erstellen, um Modellen ein robusteres Verständnis zu bieten.
Encords Datensätze sind mit physischen Beschreibungen des Videoinhalts annotiert – wie „rechte Hand zieht Schraube fest“ –, um LLM-basierten Modellen zu helfen, Aktionen zu verstehen. Velmurugan schätzt, dass diese dichte Annotation 100-mal wertvoller ist als „minderwertige egozentrische Daten“ für das Training spezifischer Aufgaben, wobei sie nur 20-mal mehr kostet, sie zu produzieren – ein vorteilhaftes Verhältnis auf dem Papier.
„20-mal mehr“ bedeutet jedoch echtes Geld, was der Haken ist: Das Scrapen von Internettext, um LLMs aus Quellen wie Stack Overflow aufzubauen, kostete Frontier-Labors fast nichts. Die Generierung physischer Trainingsdaten ist das nicht, was die Grenzen des Vergleichs von Physical AI mit LLMs aufzeigt. Diese Daten müssen hergestellt, nicht nur gesammelt werden, was die Wirtschaftlichkeit der Modellentwicklung grundlegend verändert.
Velmurugan ist der Ansicht, dass Fortschritte erzielt werden. Mit Encords Einblick in Branchenprogramme beobachtet er Startups und Frontier-Labors, die bestimmen, was funktioniert, um Physical-AI-Modelle zu verbessern. Dieser Aussichtspunkt – positioniert zwischen mehreren Roboterunternehmen – ist Teil des Wertversprechens von Encord und ermöglicht es ihnen, Datentechniken zu identifizieren, die branchenweit an Fahrt gewinnen, bevor dies ein einzelner Kunde tut.
Dies wird die Dutzend Piloten in Encords Einrichtung beschäftigt halten. Sowohl Infante als auch Ceja sind Teil einer wachsenden Belegschaft, die neuronale Netzwerkbaukästen entwickelt; sie arbeiteten zuvor bei Scale, einem weiteren KI-Datenannotationsunternehmen, bevor sie Encord beitraten.
Ceja arbeitete zuvor bei einem Entsorgungsunternehmen, wo sein Interesse an Technologie ihn dazu brachte, einen Roboter-Abfalltrenner zu warten. Jetzt, da der Jenga-Turm zusammenbricht, genießt er die Herausforderung, Trainingsaufgaben für Roboter zu lösen: „Es ist jeden Tag etwas Neues!“








 Der ehemalige Chief von Infosys hat mit seinem KI-Startup erneut 53 Millionen US-Dollar gesichert.
Hang Ten Systems, ein vor nur vier Monaten von dem ehemaligen Infosys-CEO Vishal Sikka gegründetes KI-Startup, hat zusätzliche 53 Millionen US-Dollar an Seed-Finanzierung gesichert. Diese neueste Investitionsrunde wurde laut gegenüber TechCrunch bere
 Die Kryptobörse OKX will KI-Agenten in die Lage versetzen, sich gegenseitig einzustellen und zu bezahlen
Da KI-Agenten zunehmend für Einzelpersonen tätig werden und miteinander zusammenarbeiten, benötigen sie Mechanismen, um Aufgaben zu finden, Dienstleistungen zu vergüten und Glaubwürdigkeit aufzubauen.
 Ein von Thiel unterstütztes Start-up behauptet, KI könne journalistische Arbeit bewerten – trotz der Risiken für Whistleblower
Nach seiner Beteiligung an dem Rechtsstreit, der zur Insolvenz von Gawker führte, erkannte Aron D’Souza einen entscheidenden Mangel in der amerikanischen Medienlandschaft: Personen, denen durch die Be

Die besten KI-Lernhilfen für Hausaufgaben und Prüfungsvorbereitung im Jahr 2026! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die Schülern helfen, ihre Produktivität zu steigern, Hausaufgaben effizienter zu erledigen und Prüfungen dank praxisnaher Tests mit Bravour zu meistern. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, detaillierte Rankings und unverzichtbare Optionen, um Ihren KI-Vorteil zu nutzen. Entdecken Sie es jetzt!
10 Tools
xix.ai

2026 Neueste und beste KI-Stimm-Demo-Tools für Songwriter, Hook-Ersteller und mehrsprachige Content-Teams! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Optionen, umfassende Rankings und empfehlenswerte Auswahlmöglichkeiten, die Ihnen helfen, Ihre Schreibeffizienz zu steigern und Ihr kreatives Potenzial zu entfalten. Entdecken Sie jetzt das perfekte Tool für all Ihre Content-Bedürfnisse!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Wettbewerbsanalyse für kleine Unternehmen im Jahr 2026! XIX.AI hat eine äußerst leistungsstarke, bahnbrechende Auswahl zusammengestellt, die wöchentlich anhand strenger Praxistests und detaillierter Rankings aktualisiert wird. Hier finden Sie einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die unverzichtbaren Tools zu identifizieren, die Ihre Produktivität steigern und Ihnen einen Wettbewerbsvorteil verschaffen. Entdecken Sie jetzt das perfekte Tool für sich!
9 Tools
xix.ai

2026 Neueste beste Photoshop-KI-Retuschierungstools für E-Commerce-Bekleidung, Hautbereinigung und Farbkonsistenz! Diese hoch bewertete kuratierte Liste bietet leistungsstarke, bahnbrechende Lösungen, die Ihnen helfen, die Schreibeffizienz zu steigern, die Content-Erstellung zu optimieren und mühelos perfekte visuelle Ergebnisse zu erzielen. Jedes Tool wurde durch wöchentlich aktualisierte Rankings mit echten Tests geprüft, einschließlich detaillierter Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen. Unterstützt von XIX.AI ist es der unverzichtbare Leitfaden für alle, die ihre KI-Vorteile nutzen möchten. Jetzt entdecken!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Prompt-Bibliotheken des Jahres 2026 zur Optimierung aller Arten von ChatGPT-Workflows. XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die strengen Praxistests unterzogen wird, um Spitzenleistung zu gewährleisten. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Experten-Rankings, die Ihnen dabei helfen, die unverzichtbaren Tools auszuwählen, mit denen Sie Ihre Produktivität steigern und Ihren KI-Vorteil ausschöpfen können. Entdecken Sie sie jetzt!
11 Tools
xix.ai

2026 Neueste und beste KI-Quiz-Erstellungstools für Lehrer, Nachhilfelehrer und kohortenbasierte Lernprogramme! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die realen Tests unterzogen wurden, um genaue Rankings zu liefern. Diese unbedingt auszuprobierenden Plattformen helfen dabei, die Schreibeffizienz zu steigern, die Inhaltserstellung zu optimieren und das Quiz-Design in allen Lernszenarien zu vereinfachen. Entdecken Sie jetzt Ihr perfektes Tool, um Ihren KI-Vorteil im Unterricht voll auszuschöpfen!
13 Tools
xix.ai












