


 首页
小红书、北京大学、上海交通大学联合发布 HYPIC,可将混合注意力模型的首 Token 延迟降低 3.25 倍
大型模型服务的核心焦点正从单轮对话转向检索增强问答、多文档摘要以及长程智能体。这些新兴工作负载具有一个关键特征:单个请求的提示词通常由数十至数百个语义独立的片段组成,包括检索到的文档、技能描述、记忆文件以及之前的对话轮次,所有片段被组装成从数万到数十万词元不等的超长上下文。在此规模下,预填充阶段主导了每个请求的计算成本,成为服务提供商最显著的支出。更关键的是,缓存未命中可能导致首词延迟(TTFT)飙升至数秒,严重损害用户体验。
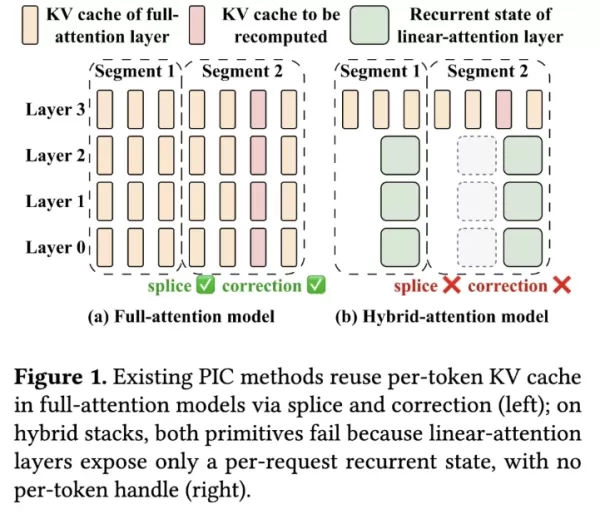
业界采用了两种降低成本策略。第一种是位置无关缓存(PIC),它放宽了严格的前缀约束,允许每个语义独立的片段仅被缓存一次,随后可拼接至任意前缀,完美契合 RAG 和智能体的提示词构成。其核心机制包括拼接,即沿词元轴直接连接,以及校正,即重新计算少量词元以恢复跨片段上下文。第二种方法是混合注意力模型,它用线性注意力替换大部分全注意力层,将二次复杂度降低为线性,并将无界历史压缩为固定大小的循环状态。最近的量产模型如 MiniMax-M1、Ring-2.5、Qwen3.5 和 Kimi-Linear 对其超过 75% 的层进行了线性化处理,仅保留少数全注意力层,形成了主流的混合设计。例如,Qwen3.5-35B-A3B 在总共 40 层中包含 30 个线性层。
核心矛盾在于此:现有的 PIC 基于逐词元键值(KV)缓存运行,而线性注意力层仅暴露逐请求的循环状态,缺乏用于拼接或校正的逐词元挂钩。因此,混合模型中的大多数层超出了现有 PIC 系统的能力范围。迄今为止,没有任何系统为混合注意力大型模型提供位置无关缓存。
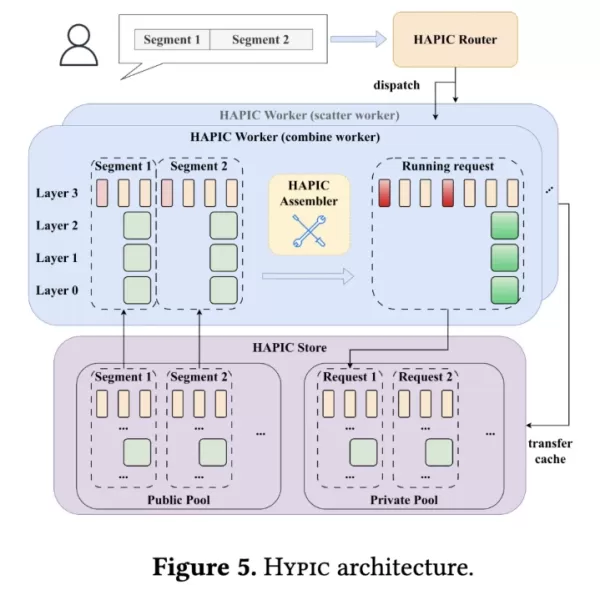
HYPIC 由小红书大型模型推理团队与北京大学、上海交通大学合作开发,是首个在混合注意力大型模型上实现 PIC 的服务系统。在四个量产级混合注意力模型和五个工作负载上的测试表明,HYPIC 将首词延迟平均降低了 3.25 倍,并在相同 SLO 下将可持续 QPS 提高了 1.66 倍,任务质量与完全重新计算相比仅相差 1.71 分。该系统的核心思想是在混合模型中分别处理线性层和全注意力层,通过三个相互关联的机制利用层级并行性加速冷请求。
对于线性层,HYPIC 缓存“转移算子”,实现常数时间的状态组合。最直接的 PIC 稻草人解决方案是直接相加两个具有零初始值的片段的最终状态——这在朴素线性注意力中有效,但在具有衰减、门控或 Delta 擦除的高级线性注意力(如 RetNet、Mamba2、GLA、DeltaNet、GDN、KDA)中失败。缺失的关键量是片段的累积转移算子 T_C,即其中所有词元转移矩阵的乘积。实际最终状态应为 S(C1·C2) = T(C2) · S(C1) + S(C2),而简单加法省略了 T(C2) 项,导致结构误差。测试显示,RetNet 中的慢衰减头在 256 个词元处表现出占状态范数 22% 的误差。HYPIC 的关键见解是,T_C 和零初始状态最终状态 S(C|0) 仅由片段内部词元决定,与前缀无关。因此,在片段的首次预填充期间,HYPIC 缓存对 (T_C, S(C|0)),并在重用时应用 T_C 的左乘及加法,几乎精确地重建任意前缀下的最终状态,自然覆盖整个线性注意力家族。在 Qwen3.5-35B-A3B 上的测试显示,组合状态与完全重新计算的差异仅为 6×10⁻⁵,在 FP16 噪声范围内。对于具有因果卷积或 RoPE 的变体,HYPIC 使用两个补丁——卷积状态预热和状态重旋转——以实现严格对齐。
对于全注意力层,HYPIC 使用“接缝窗口”来修复跨片段注意力。尽管混合模型中仍有少量全注意力层需要 PIC,但之前的选择性重新计算无法直接迁移,因为下游线性层仅保留最终状态,使得非终端词元无法通过全注意力层向上传递。由于存储或计算限制,按词元存储循环状态或从头重新计算均不可行。团队观察到,KV 拼接后的偏差在每个重用片段的开头高度集中,其余部分几乎不受影响,这与全注意力模型中的注意力汇现象一致,在混合注意力模型中也成立。基于此,HYPIC 在每个内部片段的开头构建一个包含 w 个词元的接缝窗口,将这些词元排除在缓存之外。重用时,它们在完整前缀下重新计算以修复跨片段注意力,默认 w=8;由于实际片段长度通常大于 512 个词元,接缝窗口占比非常小,使得重新计算成本可控。为了支持初始 KV 的重新计算,线性注意力层在重用时计算接缝窗口的 T 和 S,推进运行状态,同时将每个接缝词元的逐层输出转发至上层全注意力层。
第三个组件是片段级并行性,将“长冷请求”转化为加速工作负载。由于持续的语料库更新和低频率文档移除,缓存未命中是不可避免的,长冷请求是尾部延迟的主要原因。现有系统将整个提示词视为单一实体,在单个实例上串行预填充所有冷片段,TTFT 随 O(n·|C|) 增长;虽然张量并行和其他实例内并行性可以加速单个前向传播,但其可扩展性有限,TP-8 上的 100k 词元请求仍需 17.7 秒。然而,PIC 已使每个片段自包含——其预填充结果仅取决于其内部词元。HYPIC 提出实例间片段级并行性:路由器检测每个片段是否命中缓存,然后将冷片段并行分发到多个散射工作器,合并工作器将每个片段的結果组装为完整的运行状态,将冷预填充时间从 O(n·|C|) 降低至 O(⌈n/m⌉·|C|+c)。为了充分利用此路径,HYPIC 使用贪婪 LPT(最长处理时间)策略平衡工作器间的负载,并重叠每个片段的计算和传输,以避免合并工作器被同步传输突发所拖累;片段级并行性与实例内并行性(TP/DP/SP)在正交轴上运行,可以无缝结合。
该系统已在 SGLang 上实现,包含约 14,000 行 Python 和 Triton 代码。它在八个 H20 节点上使用四个量产级混合注意力模型(Ring-mini/flash-linear-2.0、Qwen3.5-35B-A3B/122B-A10B)、四个公共数据集(HotpotQA、TriviaQA、MultiNews、GovReport)和一个生产 RAG 追踪进行了评估。完全预热后,与 Prefix Cache 相比,HYPIC 将 p50 TTFT 平均降低了 3.25 倍(从 2.77× 到 4.05×),几乎没有质量损失——16 个“模型 × 数据集”单元平均仅落后于完全重新计算 1.71 分,甚至在 Qwen3.5-35B 上超出其 0.47 分。作为对比,不使用缓存转移算子的朴素加法损失了 66.9% 的分数,证实了 T_C 的必要性。在生产 RAG 追踪中,在相同的 1 秒 TTFT SLO 下,HYPIC 将可持续 QPS 提高了 1.66 倍(从 1.49× 到 1.85×),每张卡的峰值吞吐量提高了约 1.3 至 1.5 倍。在纯冷未命中路径上,32k 词元请求的 TTFT 从单个工作器的 2.83 秒降低到八个工作器的 0.49 秒,实现了 5.7× 的加速,几乎所有增益都来自可扩展的散射阶段。针对不均匀分片,LPT 将 TTFT 从 1.26 秒降低到 0.84 秒(3.6× 对比 2.4×)。开销也是可控的:构建 (T_C, S(C|0)) 的一次性成本在最重的密集转移模型中仅占主前向传播的 5.2% 至 6.7%,且该成本可通过多次重用进行摊销。
HYPIC 首次将位置无关缓存引入混合注意力大型模型:它使用缓存的逐片段累积转移算子实现线性层的常数时间状态组合,利用小接缝窗口修复全注意力层的跨片段对齐,并使用片段级并行性将长冷请求转化为加速工作负载。这使得 RAG 和智能体等长上下文服务能够在拥抱高效混合架构的同时,享受片段级缓存重用的好处。团队表示,未来的工作将专注于探索分布式 PIC 管理和调度,以及多级缓存层次结构管理,进一步推动大型模型推理朝着更快、更具成本效益和更具可扩展性的解决方案发展。
相关文章
 微信 WeMM-Embedding 以每日十亿次调用量赋能朋友圈搜索与视频精选
9月4日,微信AI宣布开源其通用多模态嵌入模型WeMM-Embedding。该模型提供2B、4B和9B三种版本,支持文本、图像、视频、视觉文档以及任意交错的多模态输入。据微信员工@KeCunXiaoJiang介绍,微信视觉团队开源的多模态模型WeMM-Embedding,通过将文本、图像和视频置于共享语义空间中进行比较和检索,使系统能够同时理解这些内容。已应用于朋友圈搜索和视频推荐等场景他透露,该模型在微信内部得到广泛应用——朋友圈搜索、视频推荐、公众号推荐以及微信电商均在使用该模型,日调用量达
ChatGPT 推出与主流社交媒体平台无缝兼容的自定义贴纸
OpenAI 正式推出了 ChatGPT 的全新自定义贴纸功能,将人工智能在大众社交内容创作方面的应用推向了新的高度。用户可以通过直观的方式创建个性化贴纸,包括上传照片、使用文本提示或应用各种视觉艺术风格。该功能利用智能图像裁剪和修复技术,自动生成干净且背景透明的贴纸,允许用户将多个设计打包成完整的自定义贴纸包。该功能提供了无缝的互操作性和导出选项。贴纸可以直接保存到手机的相册中,或导出到 iMessage 和 WhatsApp 等流行的即时通讯应用。对于 WhatsApp,每次导出至少需要
Anthropic 悄然启动 Claude Opus 5.2 及内部模型 2 的灰度测试
Anthropic 的最新旗舰模型 Opus 5.2 今晨已悄然在 Claude Code 中进入早期测试阶段。开发者注意到 API 调用与 Web 界面之间的性能表现存在显著差异。数据包分析显示,后端模型标识符已切换为 Opus 5.2,表明这一未经宣布的版本正在实际驱动开发者的工作流程。与此同时,Anthropic 的一份内部风险评估文件曝光,详细披露了一个未公开的高影响力模型 2.0 的部署情况。该系统目前承担了大部分代码生成任务,预计将取代研究团队 85% 的产出。这一转变标志着战略重
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
大型模型服务的核心焦点正从单轮对话转向检索增强问答、多文档摘要以及长程智能体。这些新兴工作负载具有一个关键特征:单个请求的提示词通常由数十至数百个语义独立的片段组成,包括检索到的文档、技能描述、记忆文件以及之前的对话轮次,所有片段被组装成从数万到数十万词元不等的超长上下文。在此规模下,预填充阶段主导了每个请求的计算成本,成为服务提供商最显著的支出。更关键的是,缓存未命中可能导致首词延迟(TTFT)飙升至数秒,严重损害用户体验。
业界采用了两种降低成本策略。第一种是位置无关缓存(PIC),它放宽了严格的前缀约束,允许每个语义独立的片段仅被缓存一次,随后可拼接至任意前缀,完美契合 RAG 和智能体的提示词构成。其核心机制包括拼接,即沿词元轴直接连接,以及校正,即重新计算少量词元以恢复跨片段上下文。第二种方法是混合注意力模型,它用线性注意力替换大部分全注意力层,将二次复杂度降低为线性,并将无界历史压缩为固定大小的循环状态。最近的量产模型如 MiniMax-M1、Ring-2.5、Qwen3.5 和 Kimi-Linear 对其超过 75% 的层进行了线性化处理,仅保留少数全注意力层,形成了主流的混合设计。例如,Qwen3.5-35B-A3B 在总共 40 层中包含 30 个线性层。
核心矛盾在于此:现有的 PIC 基于逐词元键值(KV)缓存运行,而线性注意力层仅暴露逐请求的循环状态,缺乏用于拼接或校正的逐词元挂钩。因此,混合模型中的大多数层超出了现有 PIC 系统的能力范围。迄今为止,没有任何系统为混合注意力大型模型提供位置无关缓存。
HYPIC 由小红书大型模型推理团队与北京大学、上海交通大学合作开发,是首个在混合注意力大型模型上实现 PIC 的服务系统。在四个量产级混合注意力模型和五个工作负载上的测试表明,HYPIC 将首词延迟平均降低了 3.25 倍,并在相同 SLO 下将可持续 QPS 提高了 1.66 倍,任务质量与完全重新计算相比仅相差 1.71 分。该系统的核心思想是在混合模型中分别处理线性层和全注意力层,通过三个相互关联的机制利用层级并行性加速冷请求。
对于线性层,HYPIC 缓存“转移算子”,实现常数时间的状态组合。最直接的 PIC 稻草人解决方案是直接相加两个具有零初始值的片段的最终状态——这在朴素线性注意力中有效,但在具有衰减、门控或 Delta 擦除的高级线性注意力(如 RetNet、Mamba2、GLA、DeltaNet、GDN、KDA)中失败。缺失的关键量是片段的累积转移算子 T_C,即其中所有词元转移矩阵的乘积。实际最终状态应为 S(C1·C2) = T(C2) · S(C1) + S(C2),而简单加法省略了 T(C2) 项,导致结构误差。测试显示,RetNet 中的慢衰减头在 256 个词元处表现出占状态范数 22% 的误差。HYPIC 的关键见解是,T_C 和零初始状态最终状态 S(C|0) 仅由片段内部词元决定,与前缀无关。因此,在片段的首次预填充期间,HYPIC 缓存对 (T_C, S(C|0)),并在重用时应用 T_C 的左乘及加法,几乎精确地重建任意前缀下的最终状态,自然覆盖整个线性注意力家族。在 Qwen3.5-35B-A3B 上的测试显示,组合状态与完全重新计算的差异仅为 6×10⁻⁵,在 FP16 噪声范围内。对于具有因果卷积或 RoPE 的变体,HYPIC 使用两个补丁——卷积状态预热和状态重旋转——以实现严格对齐。
对于全注意力层,HYPIC 使用“接缝窗口”来修复跨片段注意力。尽管混合模型中仍有少量全注意力层需要 PIC,但之前的选择性重新计算无法直接迁移,因为下游线性层仅保留最终状态,使得非终端词元无法通过全注意力层向上传递。由于存储或计算限制,按词元存储循环状态或从头重新计算均不可行。团队观察到,KV 拼接后的偏差在每个重用片段的开头高度集中,其余部分几乎不受影响,这与全注意力模型中的注意力汇现象一致,在混合注意力模型中也成立。基于此,HYPIC 在每个内部片段的开头构建一个包含 w 个词元的接缝窗口,将这些词元排除在缓存之外。重用时,它们在完整前缀下重新计算以修复跨片段注意力,默认 w=8;由于实际片段长度通常大于 512 个词元,接缝窗口占比非常小,使得重新计算成本可控。为了支持初始 KV 的重新计算,线性注意力层在重用时计算接缝窗口的 T 和 S,推进运行状态,同时将每个接缝词元的逐层输出转发至上层全注意力层。
第三个组件是片段级并行性,将“长冷请求”转化为加速工作负载。由于持续的语料库更新和低频率文档移除,缓存未命中是不可避免的,长冷请求是尾部延迟的主要原因。现有系统将整个提示词视为单一实体,在单个实例上串行预填充所有冷片段,TTFT 随 O(n·|C|) 增长;虽然张量并行和其他实例内并行性可以加速单个前向传播,但其可扩展性有限,TP-8 上的 100k 词元请求仍需 17.7 秒。然而,PIC 已使每个片段自包含——其预填充结果仅取决于其内部词元。HYPIC 提出实例间片段级并行性:路由器检测每个片段是否命中缓存,然后将冷片段并行分发到多个散射工作器,合并工作器将每个片段的結果组装为完整的运行状态,将冷预填充时间从 O(n·|C|) 降低至 O(⌈n/m⌉·|C|+c)。为了充分利用此路径,HYPIC 使用贪婪 LPT(最长处理时间)策略平衡工作器间的负载,并重叠每个片段的计算和传输,以避免合并工作器被同步传输突发所拖累;片段级并行性与实例内并行性(TP/DP/SP)在正交轴上运行,可以无缝结合。
该系统已在 SGLang 上实现,包含约 14,000 行 Python 和 Triton 代码。它在八个 H20 节点上使用四个量产级混合注意力模型(Ring-mini/flash-linear-2.0、Qwen3.5-35B-A3B/122B-A10B)、四个公共数据集(HotpotQA、TriviaQA、MultiNews、GovReport)和一个生产 RAG 追踪进行了评估。完全预热后,与 Prefix Cache 相比,HYPIC 将 p50 TTFT 平均降低了 3.25 倍(从 2.77× 到 4.05×),几乎没有质量损失——16 个“模型 × 数据集”单元平均仅落后于完全重新计算 1.71 分,甚至在 Qwen3.5-35B 上超出其 0.47 分。作为对比,不使用缓存转移算子的朴素加法损失了 66.9% 的分数,证实了 T_C 的必要性。在生产 RAG 追踪中,在相同的 1 秒 TTFT SLO 下,HYPIC 将可持续 QPS 提高了 1.66 倍(从 1.49× 到 1.85×),每张卡的峰值吞吐量提高了约 1.3 至 1.5 倍。在纯冷未命中路径上,32k 词元请求的 TTFT 从单个工作器的 2.83 秒降低到八个工作器的 0.49 秒,实现了 5.7× 的加速,几乎所有增益都来自可扩展的散射阶段。针对不均匀分片,LPT 将 TTFT 从 1.26 秒降低到 0.84 秒(3.6× 对比 2.4×)。开销也是可控的:构建 (T_C, S(C|0)) 的一次性成本在最重的密集转移模型中仅占主前向传播的 5.2% 至 6.7%,且该成本可通过多次重用进行摊销。
HYPIC 首次将位置无关缓存引入混合注意力大型模型:它使用缓存的逐片段累积转移算子实现线性层的常数时间状态组合,利用小接缝窗口修复全注意力层的跨片段对齐,并使用片段级并行性将长冷请求转化为加速工作负载。这使得 RAG 和智能体等长上下文服务能够在拥抱高效混合架构的同时,享受片段级缓存重用的好处。团队表示,未来的工作将专注于探索分布式 PIC 管理和调度,以及多级缓存层次结构管理,进一步推动大型模型推理朝着更快、更具成本效益和更具可扩展性的解决方案发展。








 微信 WeMM-Embedding 以每日十亿次调用量赋能朋友圈搜索与视频精选
9月4日,微信AI宣布开源其通用多模态嵌入模型WeMM-Embedding。该模型提供2B、4B和9B三种版本,支持文本、图像、视频、视觉文档以及任意交错的多模态输入。据微信员工@KeCunXiaoJiang介绍,微信视觉团队开源的多模态模型WeMM-Embedding,通过将文本、图像和视频置于共享语义空间中进行比较和检索,使系统能够同时理解这些内容。已应用于朋友圈搜索和视频推荐等场景他透露,该模型在微信内部得到广泛应用——朋友圈搜索、视频推荐、公众号推荐以及微信电商均在使用该模型,日调用量达
 ChatGPT 推出与主流社交媒体平台无缝兼容的自定义贴纸
OpenAI 正式推出了 ChatGPT 的全新自定义贴纸功能,将人工智能在大众社交内容创作方面的应用推向了新的高度。用户可以通过直观的方式创建个性化贴纸,包括上传照片、使用文本提示或应用各种视觉艺术风格。该功能利用智能图像裁剪和修复技术,自动生成干净且背景透明的贴纸,允许用户将多个设计打包成完整的自定义贴纸包。该功能提供了无缝的互操作性和导出选项。贴纸可以直接保存到手机的相册中,或导出到 iMessage 和 WhatsApp 等流行的即时通讯应用。对于 WhatsApp,每次导出至少需要
 Anthropic 悄然启动 Claude Opus 5.2 及内部模型 2 的灰度测试
Anthropic 的最新旗舰模型 Opus 5.2 今晨已悄然在 Claude Code 中进入早期测试阶段。开发者注意到 API 调用与 Web 界面之间的性能表现存在显著差异。数据包分析显示,后端模型标识符已切换为 Opus 5.2,表明这一未经宣布的版本正在实际驱动开发者的工作流程。与此同时,Anthropic 的一份内部风险评估文件曝光,详细披露了一个未公开的高影响力模型 2.0 的部署情况。该系统目前承担了大部分代码生成任务,预计将取代研究团队 85% 的产出。这一转变标志着战略重

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












