


 Hogar
Xiaohongshu, la Universidad de Pekín y la Universidad de Jiao Tong de Shanghai presentan HYPIC para reducir la latencia del primer token en un 3,25x en modelos de atención híbrida
El enfoque principal de los servicios de modelos grandes está cambiando de conversaciones de turno único a preguntas de recuperación aumentada (RAG), resumen de múltiples documentos y agentes de largo alcance. Estas cargas de trabajo emergentes comparten una característica clave: el prompt de una sola solicitud a menudo consta de decenas a cientos de segmentos semánticamente independientes, que incluyen documentos recuperados, descripciones de habilidades, archivos de memoria y rondas de conversación anteriores, todos ensamblados en contextos ultra largos que van desde decenas de miles hasta cientos de miles de tokens. A esta escala, la fase de prellenado domina el costo computacional por solicitud, convirtiéndose en el gasto más visible para los proveedores de servicios. Más críticamente, los fallos de caché pueden hacer que el retraso del primer token (TTFT) aumente a varios segundos, degradando severamente la experiencia del usuario.
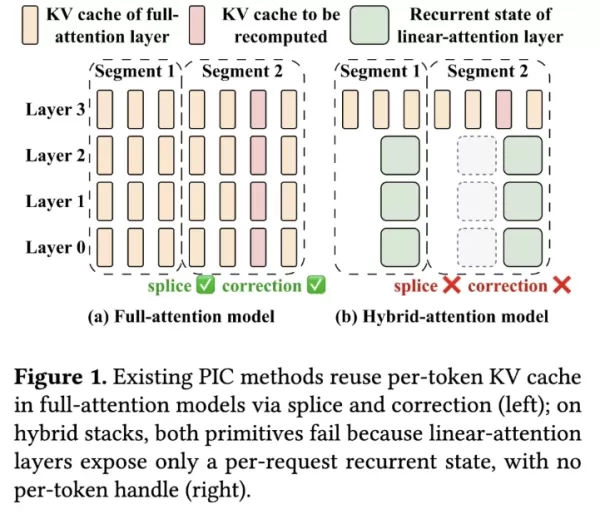
La industria ha adoptado dos estrategias de reducción de costos. La primera es el almacenamiento en caché independiente de la posición (PIC), que relaja las estrictas restricciones de prefijo, permitiendo que cada segmento semánticamente independiente se almacene en caché una vez y luego se concatene en cualquier prefijo, alineándose perfectamente con la composición de prompts de RAG y agentes. Sus mecanismos centrales son la concatenación, que une directamente a lo largo del eje de tokens, y la corrección, que recalcula algunos tokens para restaurar el contexto entre segmentos. El segundo enfoque es el modelo de atención híbrida, que reemplaza la mayoría de las capas de atención completa con atención lineal, reduciendo la complejidad cuadrática a lineal y comprimiendo un historio ilimitado en un estado cíclico de tamaño fijo. Modelos de producción recientes como MiniMax-M1, Ring-2.5, Qwen3.5 y Kimi-Linear linealizan más del 75 % de sus capas, conservando solo unas pocas capas de atención completa, formando el diseño híbrido principal. Por ejemplo, Qwen3.5-35B-A3B cuenta con 30 capas lineales de un total de 40.
La contradicción central radica aquí: el PIC existente opera en cachés de valores clave (KV) por token, mientras que las capas de atención lineal solo exponen un estado cíclico por solicitud, careciendo de ganchos por token para la concatenación o corrección. En consecuencia, la mayoría de las capas en modelos híbridos quedan fuera de las capacidades de los sistemas PIC existentes. Hasta ahora, ningún sistema proporcionaba almacenamiento en caché independiente de la posición para modelos grandes de atención híbrida.
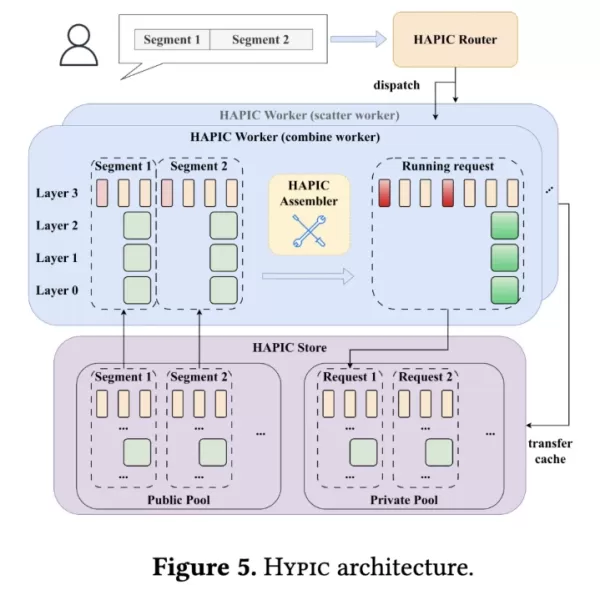
Desarrollado por el equipo de inferencia de modelos grandes de Xiaohongshu en colaboración con la Universidad de Pekín y la Universidad Jiao Tong de Shanghái, HYPIC es el primer sistema de servicios que implementa PIC en modelos grandes de atención híbrida. Las pruebas en cuatro modelos de atención híbrida de nivel de producción y cinco cargas de trabajo muestran que HYPIC reduce el retraso del primer token en un promedio de 3,25 veces y aumenta el QPS sostenible en 1,66 veces bajo la misma SLO, con una diferencia de calidad de tarea de solo 1,71 puntos respecto al recomputo completo. La idea central del sistema es manejar las capas lineales y de atención completa por separado dentro del modelo híbrido, acelerando las solicitudes en frío mediante paralelismo a nivel de capa a través de tres mecanismos entrelazados.
Para las capas lineales, HYPIC almacena en caché "operadores de transición", lo que permite una combinación de estados en tiempo constante. La solución más sencilla de PIC es sumar directamente los estados finales de dos segmentos con valores iniciales cero, válido en la atención lineal ingenua pero fallido en la atención lineal avanzada con decaimiento, compuertas o borrado delta (por ejemplo, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). La cantidad crítica faltante es el operador de transición acumulado T_C de un segmento, es decir, el producto de todas las matrices de transición de tokens dentro de él. El estado final real debería ser S(C1·C2) = T(C2) · S(C1) + S(C2), mientras que la suma simple omite el término T(C2), causando un error estructural. Las pruebas mostraron que la cabeza de decaimiento lenta en RetNet exhibió un error del 22 % de la norma del estado en 256 tokens. La idea clave de HYPIC es que T_C y el estado final S(C|0) con valor inicial cero están determinados únicamente por los tokens internos de un segmento, independientemente del prefijo. Por lo tanto, durante el primer prellenado de un segmento, HYPIC almacena en caché el par (T_C, S(C|0)), y al reutilizarlo, aplica la multiplicación por la izquierda de T_C seguida de una suma para reconstruir casi exactamente el estado final bajo cualquier prefijo, cubriendo naturalmente toda la familia de atención lineal. Las pruebas en Qwen3.5-35B-A3B mostraron que los estados combinados diferían del recomputo completo en solo 6×10⁻⁵, dentro del ruido de FP16. Para variantes con convolución causal o RoPE, HYPIC utiliza dos parches: actualización en caliente del estado de convolución y re-rotación del estado, para lograr una alineación estricta.
Para las capas de atención completa, HYPIC utiliza "ventanas de costura" para corregir la atención entre segmentos. Aunque algunas capas de atención completa aún requieren PIC en modelos híbridos, la recomputación selectiva anterior no se puede migrar directamente porque las capas lineales posteriores solo retienen el estado final, lo que hace imposible que los tokens no terminales pasen hacia arriba a través de la capa de atención completa. Almacenar el estado cíclico por token o recomputar desde cero no es viable debido a restricciones de almacenamiento o computación. El equipo observó que el sesgo después de la concatenación de KV se concentra altamente al principio de cada segmento reutilizado, con el resto casi sin afectar, consistente con el fenómeno del sumidero de atención en modelos de atención completa, lo cual también se mantiene en modelos de atención híbrida. Basándose en esto, HYPIC construye una ventana de costura de w tokens al principio de cada segmento interno, excluyendo estos tokens del almacenamiento en caché. Al reutilizarlos, se recalculan bajo el prefijo completo para reparar la atención entre segmentos, con w=8 por defecto; dado que la longitud real del segmento suele ser mayor que 512 tokens, la ventana de costura constituye una porción muy pequeña, haciendo que el costo de recomputación sea manejable. Para admitir la recomputación del KV inicial, las capas de atención lineal calculan T y S de la ventana de costura durante la reutilización, avanzando el estado en ejecución mientras envían hacia adelante las salidas por capa de cada token de costura a la capa superior de atención completa.
El tercer componente es el paralelismo a nivel de segmento, transformando las "largas solicitudes en frío" en cargas de trabajo aceleradas. Los fallos de caché son inevitables debido a las actualizaciones continuas del corpus y la eliminación de documentos de baja frecuencia, siendo las largas solicitudes en frío la causa principal de la latencia de cola. Los sistemas existentes tratan todo el prompt como una sola entidad, prellenando en serie todos los segmentos en frío en una sola instancia, con TTFT creciendo como O(n·|C|); aunque el paralelismo de tensor y otros paralelismos intra-instancia pueden acelerar las pasadas hacia adelante individuales, su escalabilidad es limitada, con una solicitud de 100k tokens en TP-8 que aún tarda 17,7 segundos. Sin embargo, PIC ya ha hecho que cada segmento sea autosuficiente: sus resultados de prellenado dependen solo de sus tokens internos. HYPIC propone paralelismo inter-instancia a nivel de segmento: el Router detecta si cada segmento encuentra la caché, luego distribuye los segmentos en frío en paralelo a varios trabajadores dispersores, y un trabajador combinador ensambla los resultados de cada segmento en un estado en ejecución completo, reduciendo el tiempo de prellenado en frío de O(n·|C|) a O(⌈n/m⌉·|C|+c). Para aprovechar plenamente esta ruta, HYPIC utiliza una estrategia LPT (Longest Processing Time) codiciosa para equilibrar la carga de trabajo entre trabajadores, y superpone el cálculo y la transmisión de cada segmento para evitar que el trabajador combinador se vea retrasado por ráfagas de transmisión sincrónicas; el paralelismo a nivel de segmento y el paralelismo intra-instancia (TP/DP/SP) operan en ejes ortogonales y pueden combinarse sin problemas.
Este sistema se ha implementado en SGLang, con aproximadamente 14.000 líneas de código Python y Triton. Se evaluó en ocho nodos H20 utilizando cuatro modelos de atención híbrida de nivel de producción (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), cuatro conjuntos de datos públicos (HotpotQA, TriviaQA, MultiNews, GovReport) y una traza de RAG de producción. Después del precalentamiento completo, en comparación con Prefix Cache, HYPIC reduce el TTFT p50 en un promedio de 3,25 veces (de 2,7× a 4,05×), con casi ninguna pérdida de calidad: 16 unidades de "modelo × conjunto de datos" promediaron solo 1,71 puntos por detrás del recomputo completo, e incluso lo superaron por 0,47 puntos en Qwen3.5-35B. Como comparación, una suma ingenua sin almacenamiento en caché de operadores de transición perdió el 66,9 % de la puntuación, confirmando la necesidad de T_C. En la traza de RAG de producción, bajo la misma SLO de TTFT de 1 segundo, HYPIC aumentó el QPS sostenible en 1,66 veces (de 1,49× a 1,85×), y el rendimiento máximo por tarjeta aumentó aproximadamente entre 1,3 y 1,5 veces. En la ruta pura de fallo en frío, el TTFT de una solicitud de 32k tokens bajó de 2,83 segundos en un solo trabajador a 0,49 segundos en ocho trabajadores, logrando una aceleración de 5,7×, con casi todas las ganancias provenientes de la etapa dispersora escalable. Frente a un particionamiento desigual, LPT redujo el TTFT de 1,26 segundos a 0,84 segundos (3,6× frente a 2,4×). La sobrecarga también es manejable: el costo único de construir (T_C, S(C|0)) es solo del 5,2 % al 6,7 % de la pasada hacia adelante principal en el modelo denso de transferencia más pesado, y este costo puede amortizarse reutilizándolo varias veces.
HYPIC introduce por primera vez el almacenamiento en caché independiente de la posición en modelos grandes de atención híbrida: permite la combinación de estados en tiempo constante para capas lineales utilizando operadores de transición acumulados por segmento almacenados en caché, corrige la alineación entre segmentos para capas de atención completa con pequeñas ventanas de costura y convierte las largas solicitudes en frío en cargas de trabajo aceleradas utilizando paralelismo a nivel de segmento. Esto permite que servicios de contexto largo como RAG y agentes disfruten de los beneficios del reuso de caché a nivel de segmento mientras adoptan arquitecturas híbridas eficientes. El equipo declaró que el trabajo futuro se centrará en explorar la gestión y programación distribuida de PIC, y la gestión de jerarquías de caché multinivel, avanzando aún más la inferencia de modelos grandes hacia soluciones más rápidas, rentables y escalables.
Artículo relacionado
 WeChat WeMM-Embedding Potencia la Búsqueda en Moments y los Videos Destacados con 1.000 Millones de Consultas Diarias
El 4 de septiembre, WeChat AI anunció el lanzamiento de código abierto de su modelo de incrustación multimodal general, WeMM-Embedding. Disponible en versiones de 2B, 4B y 9B, el modelo admite texto, imágenes, vídeos, documentos visuales y cualquier
ChatGPT Desvela Pegatinas Personalizadas Compatible de Manera Ininterrumpida con las Principales Plataformas de Redes Sociales
OpenAI ha presentado oficialmente una nueva función de pegatinas personalizadas para ChatGPT, ampliando los límites de la IA en la creación masiva de contenido social.Los usuarios pueden crear pegatinas personalizadas mediante métodos intuitivos, co
Anthropic lanza silenciosamente pruebas en escala de grises para Claude Opus 5.2 y Modelo Interno 2
El último modelo insignia de Anthropic, Opus 5.2, ha ingresado discretamente a las pruebas tempranas dentro de Claude Code esta mañana. Los desarrolladores han notado una divergencia marcada en el rendimiento entre las llamadas a la API y la interfaz
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
El enfoque principal de los servicios de modelos grandes está cambiando de conversaciones de turno único a preguntas de recuperación aumentada (RAG), resumen de múltiples documentos y agentes de largo alcance. Estas cargas de trabajo emergentes comparten una característica clave: el prompt de una sola solicitud a menudo consta de decenas a cientos de segmentos semánticamente independientes, que incluyen documentos recuperados, descripciones de habilidades, archivos de memoria y rondas de conversación anteriores, todos ensamblados en contextos ultra largos que van desde decenas de miles hasta cientos de miles de tokens. A esta escala, la fase de prellenado domina el costo computacional por solicitud, convirtiéndose en el gasto más visible para los proveedores de servicios. Más críticamente, los fallos de caché pueden hacer que el retraso del primer token (TTFT) aumente a varios segundos, degradando severamente la experiencia del usuario.
La industria ha adoptado dos estrategias de reducción de costos. La primera es el almacenamiento en caché independiente de la posición (PIC), que relaja las estrictas restricciones de prefijo, permitiendo que cada segmento semánticamente independiente se almacene en caché una vez y luego se concatene en cualquier prefijo, alineándose perfectamente con la composición de prompts de RAG y agentes. Sus mecanismos centrales son la concatenación, que une directamente a lo largo del eje de tokens, y la corrección, que recalcula algunos tokens para restaurar el contexto entre segmentos. El segundo enfoque es el modelo de atención híbrida, que reemplaza la mayoría de las capas de atención completa con atención lineal, reduciendo la complejidad cuadrática a lineal y comprimiendo un historio ilimitado en un estado cíclico de tamaño fijo. Modelos de producción recientes como MiniMax-M1, Ring-2.5, Qwen3.5 y Kimi-Linear linealizan más del 75 % de sus capas, conservando solo unas pocas capas de atención completa, formando el diseño híbrido principal. Por ejemplo, Qwen3.5-35B-A3B cuenta con 30 capas lineales de un total de 40.
La contradicción central radica aquí: el PIC existente opera en cachés de valores clave (KV) por token, mientras que las capas de atención lineal solo exponen un estado cíclico por solicitud, careciendo de ganchos por token para la concatenación o corrección. En consecuencia, la mayoría de las capas en modelos híbridos quedan fuera de las capacidades de los sistemas PIC existentes. Hasta ahora, ningún sistema proporcionaba almacenamiento en caché independiente de la posición para modelos grandes de atención híbrida.
Desarrollado por el equipo de inferencia de modelos grandes de Xiaohongshu en colaboración con la Universidad de Pekín y la Universidad Jiao Tong de Shanghái, HYPIC es el primer sistema de servicios que implementa PIC en modelos grandes de atención híbrida. Las pruebas en cuatro modelos de atención híbrida de nivel de producción y cinco cargas de trabajo muestran que HYPIC reduce el retraso del primer token en un promedio de 3,25 veces y aumenta el QPS sostenible en 1,66 veces bajo la misma SLO, con una diferencia de calidad de tarea de solo 1,71 puntos respecto al recomputo completo. La idea central del sistema es manejar las capas lineales y de atención completa por separado dentro del modelo híbrido, acelerando las solicitudes en frío mediante paralelismo a nivel de capa a través de tres mecanismos entrelazados.
Para las capas lineales, HYPIC almacena en caché "operadores de transición", lo que permite una combinación de estados en tiempo constante. La solución más sencilla de PIC es sumar directamente los estados finales de dos segmentos con valores iniciales cero, válido en la atención lineal ingenua pero fallido en la atención lineal avanzada con decaimiento, compuertas o borrado delta (por ejemplo, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). La cantidad crítica faltante es el operador de transición acumulado T_C de un segmento, es decir, el producto de todas las matrices de transición de tokens dentro de él. El estado final real debería ser S(C1·C2) = T(C2) · S(C1) + S(C2), mientras que la suma simple omite el término T(C2), causando un error estructural. Las pruebas mostraron que la cabeza de decaimiento lenta en RetNet exhibió un error del 22 % de la norma del estado en 256 tokens. La idea clave de HYPIC es que T_C y el estado final S(C|0) con valor inicial cero están determinados únicamente por los tokens internos de un segmento, independientemente del prefijo. Por lo tanto, durante el primer prellenado de un segmento, HYPIC almacena en caché el par (T_C, S(C|0)), y al reutilizarlo, aplica la multiplicación por la izquierda de T_C seguida de una suma para reconstruir casi exactamente el estado final bajo cualquier prefijo, cubriendo naturalmente toda la familia de atención lineal. Las pruebas en Qwen3.5-35B-A3B mostraron que los estados combinados diferían del recomputo completo en solo 6×10⁻⁵, dentro del ruido de FP16. Para variantes con convolución causal o RoPE, HYPIC utiliza dos parches: actualización en caliente del estado de convolución y re-rotación del estado, para lograr una alineación estricta.
Para las capas de atención completa, HYPIC utiliza "ventanas de costura" para corregir la atención entre segmentos. Aunque algunas capas de atención completa aún requieren PIC en modelos híbridos, la recomputación selectiva anterior no se puede migrar directamente porque las capas lineales posteriores solo retienen el estado final, lo que hace imposible que los tokens no terminales pasen hacia arriba a través de la capa de atención completa. Almacenar el estado cíclico por token o recomputar desde cero no es viable debido a restricciones de almacenamiento o computación. El equipo observó que el sesgo después de la concatenación de KV se concentra altamente al principio de cada segmento reutilizado, con el resto casi sin afectar, consistente con el fenómeno del sumidero de atención en modelos de atención completa, lo cual también se mantiene en modelos de atención híbrida. Basándose en esto, HYPIC construye una ventana de costura de w tokens al principio de cada segmento interno, excluyendo estos tokens del almacenamiento en caché. Al reutilizarlos, se recalculan bajo el prefijo completo para reparar la atención entre segmentos, con w=8 por defecto; dado que la longitud real del segmento suele ser mayor que 512 tokens, la ventana de costura constituye una porción muy pequeña, haciendo que el costo de recomputación sea manejable. Para admitir la recomputación del KV inicial, las capas de atención lineal calculan T y S de la ventana de costura durante la reutilización, avanzando el estado en ejecución mientras envían hacia adelante las salidas por capa de cada token de costura a la capa superior de atención completa.
El tercer componente es el paralelismo a nivel de segmento, transformando las "largas solicitudes en frío" en cargas de trabajo aceleradas. Los fallos de caché son inevitables debido a las actualizaciones continuas del corpus y la eliminación de documentos de baja frecuencia, siendo las largas solicitudes en frío la causa principal de la latencia de cola. Los sistemas existentes tratan todo el prompt como una sola entidad, prellenando en serie todos los segmentos en frío en una sola instancia, con TTFT creciendo como O(n·|C|); aunque el paralelismo de tensor y otros paralelismos intra-instancia pueden acelerar las pasadas hacia adelante individuales, su escalabilidad es limitada, con una solicitud de 100k tokens en TP-8 que aún tarda 17,7 segundos. Sin embargo, PIC ya ha hecho que cada segmento sea autosuficiente: sus resultados de prellenado dependen solo de sus tokens internos. HYPIC propone paralelismo inter-instancia a nivel de segmento: el Router detecta si cada segmento encuentra la caché, luego distribuye los segmentos en frío en paralelo a varios trabajadores dispersores, y un trabajador combinador ensambla los resultados de cada segmento en un estado en ejecución completo, reduciendo el tiempo de prellenado en frío de O(n·|C|) a O(⌈n/m⌉·|C|+c). Para aprovechar plenamente esta ruta, HYPIC utiliza una estrategia LPT (Longest Processing Time) codiciosa para equilibrar la carga de trabajo entre trabajadores, y superpone el cálculo y la transmisión de cada segmento para evitar que el trabajador combinador se vea retrasado por ráfagas de transmisión sincrónicas; el paralelismo a nivel de segmento y el paralelismo intra-instancia (TP/DP/SP) operan en ejes ortogonales y pueden combinarse sin problemas.
Este sistema se ha implementado en SGLang, con aproximadamente 14.000 líneas de código Python y Triton. Se evaluó en ocho nodos H20 utilizando cuatro modelos de atención híbrida de nivel de producción (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), cuatro conjuntos de datos públicos (HotpotQA, TriviaQA, MultiNews, GovReport) y una traza de RAG de producción. Después del precalentamiento completo, en comparación con Prefix Cache, HYPIC reduce el TTFT p50 en un promedio de 3,25 veces (de 2,7× a 4,05×), con casi ninguna pérdida de calidad: 16 unidades de "modelo × conjunto de datos" promediaron solo 1,71 puntos por detrás del recomputo completo, e incluso lo superaron por 0,47 puntos en Qwen3.5-35B. Como comparación, una suma ingenua sin almacenamiento en caché de operadores de transición perdió el 66,9 % de la puntuación, confirmando la necesidad de T_C. En la traza de RAG de producción, bajo la misma SLO de TTFT de 1 segundo, HYPIC aumentó el QPS sostenible en 1,66 veces (de 1,49× a 1,85×), y el rendimiento máximo por tarjeta aumentó aproximadamente entre 1,3 y 1,5 veces. En la ruta pura de fallo en frío, el TTFT de una solicitud de 32k tokens bajó de 2,83 segundos en un solo trabajador a 0,49 segundos en ocho trabajadores, logrando una aceleración de 5,7×, con casi todas las ganancias provenientes de la etapa dispersora escalable. Frente a un particionamiento desigual, LPT redujo el TTFT de 1,26 segundos a 0,84 segundos (3,6× frente a 2,4×). La sobrecarga también es manejable: el costo único de construir (T_C, S(C|0)) es solo del 5,2 % al 6,7 % de la pasada hacia adelante principal en el modelo denso de transferencia más pesado, y este costo puede amortizarse reutilizándolo varias veces.
HYPIC introduce por primera vez el almacenamiento en caché independiente de la posición en modelos grandes de atención híbrida: permite la combinación de estados en tiempo constante para capas lineales utilizando operadores de transición acumulados por segmento almacenados en caché, corrige la alineación entre segmentos para capas de atención completa con pequeñas ventanas de costura y convierte las largas solicitudes en frío en cargas de trabajo aceleradas utilizando paralelismo a nivel de segmento. Esto permite que servicios de contexto largo como RAG y agentes disfruten de los beneficios del reuso de caché a nivel de segmento mientras adoptan arquitecturas híbridas eficientes. El equipo declaró que el trabajo futuro se centrará en explorar la gestión y programación distribuida de PIC, y la gestión de jerarquías de caché multinivel, avanzando aún más la inferencia de modelos grandes hacia soluciones más rápidas, rentables y escalables.








 WeChat WeMM-Embedding Potencia la Búsqueda en Moments y los Videos Destacados con 1.000 Millones de Consultas Diarias
El 4 de septiembre, WeChat AI anunció el lanzamiento de código abierto de su modelo de incrustación multimodal general, WeMM-Embedding. Disponible en versiones de 2B, 4B y 9B, el modelo admite texto, imágenes, vídeos, documentos visuales y cualquier
 ChatGPT Desvela Pegatinas Personalizadas Compatible de Manera Ininterrumpida con las Principales Plataformas de Redes Sociales
OpenAI ha presentado oficialmente una nueva función de pegatinas personalizadas para ChatGPT, ampliando los límites de la IA en la creación masiva de contenido social.Los usuarios pueden crear pegatinas personalizadas mediante métodos intuitivos, co
 Anthropic lanza silenciosamente pruebas en escala de grises para Claude Opus 5.2 y Modelo Interno 2
El último modelo insignia de Anthropic, Opus 5.2, ha ingresado discretamente a las pruebas tempranas dentro de Claude Code esta mañana. Los desarrolladores han notado una divergencia marcada en el rendimiento entre las llamadas a la API y la interfaz

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












