


 Дом
Xiaohongshu, Пекинский университет и Шанхайский университет Цзяо Тун представили HYPIC, чтобы сократить задержку первого токена в 3,25 раза в моделях с гибридным вниманием
Основное внимание в сервисах больших языковых моделей смещается от одношаговых диалогов к вопросам с дополнением извлечения (retrieval-augmented question answering), многодокументному суммированию и агентам с дальним контекстом. Эти новые рабочие нагрузки имеют общую ключевую особенность: промпт одного запроса часто состоит от десятков до сотен семантически независимых сегментов, включая извлеченные документы, описания навыков, файлы памяти и предыдущие раунды разговора, все они собираются в ультрадлинные контексты объемом от десятков тысяч до сотен тысяч токенов. На таком масштафе фаза префиллинга (prefill) доминирует в вычислительных затратах на один запрос, становясь наиболее заметной статьей расходов для провайдеров услуг. Более критично то, что промахи кэша могут привести к резкому увеличению задержки до первого токена (TTFT) до нескольких секунд, что сильно ухудшает пользовательский опыт.
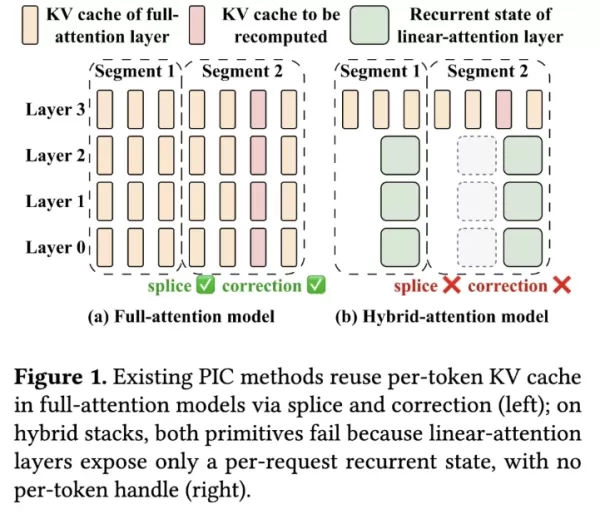
В отрасли были приняты две стратегии снижения затрат. Первая — это кэширование, независимое от позиции (PIC), которое ослабляет строгие ограничения префикса, позволяя каждому семантически независимому сегменту кэшироваться один раз, а затем вставляться в любой префикс, что идеально соответствует составлению промптов в RAG и агентах. Его основные механизмы — это сшивка (splice), которая напрямую конкатенирует данные по оси токенов, и коррекция (correction), которая пересчитывает несколько токенов для восстановления контекста между сегментами. Второй подход — гибридная модель внимания, которая заменяет большинство слоев полного внимания на линейное внимание, снижая квадратичную сложность до линейной и сжимая неограниченную историю в состояние фиксированного размера. Недавние производственные модели, такие как MiniMax-M1, Ring-2.5, Qwen3.5 и Kimi-Linear, линейризуют более 75% своих слоев, оставляя лишь несколько слоев полного внимания, формируя основной гибридный дизайн. Например, Qwen3.5-35B-A3B имеет 30 линейных слоев из 40 всего.
Основное противоречие заключается здесь: существующее PIC работает с кэшем ключ-значение (KV) на уровне токенов, в то время как слои линейного внимания предоставляют только циклическое состояние на уровне запроса, не имея крючков на уровне токенов для сшивки или коррекции. Следовательно, большинство слоев в гибридных моделях выходят за рамки возможностей существующих систем PIC. До сих пор ни одна система не предоставляла кэширование, независимое от позиции, для больших моделей с гибридным вниманием.
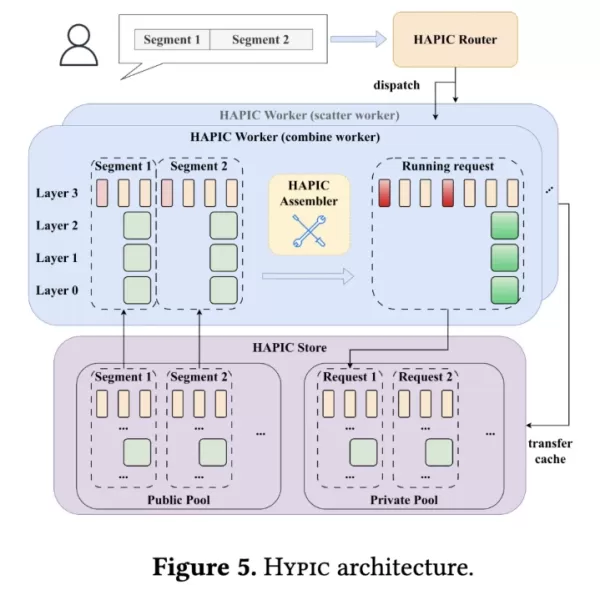
Разработанная командой вывода больших моделей Xiaohongshu совместно с Пекинским университетом и Шанхайским университетом Цзяо Тун, HYPIC является первой сервисной системой, реализующей PIC для больших моделей с гибридным вниманием. Тестирование на четырех производственных моделях с гибридным вниманием и пяти рабочих нагрузках показывает, что HYPIC снижает задержку первого токена в среднем в 3,25 раза и увеличивает устойчивое количество запросов в секунду (QPS) в 1,66 раза при том же уровне SLA, при этом качество задач отличается всего на 1,71 балла от полного пересчета. Основная идея системы заключается в раздельной обработке слоев линейного и полного внимания внутри гибридной модели, ускорении холодных запросов за счет параллелизма на уровне слоев с помощью трех взаимосвязанных механизмов.
Для линейных слоев HYPIC кэширует «операторы перехода», что позволяет комбинировать состояние за постоянное время. Наиболее простое решение PIC — это прямое сложение конечных состояний двух сегментов с нулевыми начальными значениями, что справедливо для наивного линейного внимания, но не работает в продвинутом линейном внимании с затуханием, гейтами или стиранием дельта-значений (например, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). Критически отсутствующей величиной является накопленный оператор перехода $T_C$ сегмента, то есть произведение всех матриц переходов токенов внутри него. Фактическое конечное состояние должно быть $S(C1 \cdot C2) = T(C2) \cdot S(C1) + S(C2)$, в то время как простое сложение пропускает член $T(C2)$, вызывая структурную ошибку. Тесты показали, что медленная головка затухания в RetNet демонстрировала ошибку, составляющую 22% от нормы состояния при 256 токенах. Ключевое наблюдение HYPIC заключается в том, что $T_C$ и конечное состояние с нулевым начальным значением $S(C|0)$ определяются исключительно внутренними токенами сегмента и не зависят от префикса. Таким образом, при первом префиллинге сегмента HYPIC кэширует пару $(T_C, S(C|0))$, а при повторном использовании применяет левое умножение на $T_C$ с последующим сложением, чтобы почти точно восстановить конечное состояние в любом префиксе, естественно охватывая все семейство линейного внимания. Тесты на Qwen3.5-35B-A3B показали, что комбинированные состояния отличались от полного пересчета всего на $6 \times 10^{-5}$, что находится в пределах шума FP16. Для вариантов с причинно-следственной сверткой или RoPE HYPIC использует два патча — предварительную загрузку состояния свертки и повторное вращение состояния — для достижения строгого соответствия.
Для слоев полного внимания HYPIC использует «стыковые окна» (seam windows) для исправления межсегментного внимания. Хотя в гибридных моделях все еще требуется несколько слоев полного внимания, использующих PIC, предыдущие методы селективного пересчета нельзя напрямую перенести, поскольку последующие линейные слои сохраняют только конечное состояние, что делает невозможным прохождение нетерминальных токенов вверх через слой полного внимания. Хранение циклического состояния для каждого токена или пересчет с нуля невозможны из-за ограничений на хранение или вычисления. Команда обнаружила, что смещение после конкатенации KV сильно сосредоточено в начале каждого повторно используемого сегмента, а остальная часть почти не затрагивается, что согласуется с явлением «поглощения внимания» (attention sink) в моделях полного внимания, что также справедливо для моделей гибридного внимания. На основе этого HYPIC конструирует стыковое окно из $w$ токенов в начале каждого внутреннего сегмента, исключая эти токены из кэширования. При повторном использовании они пересчитываются в полном префиксе для восстановления межсегментного внимания, при этом $w=8$ по умолчанию; поскольку фактическая длина сегмента обычно превышает 512 токенов, стыковое окно составляет очень малую часть, что делает стоимость пересчета управляемой. Для поддержки пересчета начального KV слои линейного внимания вычисляют $T$ и $S$ стыкового окна при повторном использовании, продвигая рабочее состояние, одновременно передавая выходные данные каждого слоя для каждого токена стыка в верхний слой полного внимания.
Третьим компонентом является параллелизм на уровне сегментов, преобразующий «длинные холодные запросы» в ускоренные рабочие нагрузки. Промахи кэша неизбежны из-за непрерывного обновления корпусов и удаления документов с низкой частотой, при этом длинные холодные запросы являются основной причиной задержек в хвосте распределения. Существующие системы рассматривают весь промпт как единую сущность, последовательно префилляя все холодные сегменты на одном экземпляре, при этом TTFT растет как $O(n \cdot |C|)$; хотя параллелизм тензоров и другие виды внутриэкземплярного параллелизма могут ускорять отдельные прямые проходы, их масштабируемость ограничена, и запрос на 100k токенов на TP-8 все еще занимает 17,7 секунды. Однако PIC уже сделал каждый сегмент самодостаточным — результаты его префиллинга зависят только от его внутренних токенов. HYPIC предлагает межэкземплярный параллелизм на уровне сегментов: маршрутизатор (Router) определяет, попал ли каждый сегмент в кэш, затем распределяет холодные сегменты параллельно на несколько рабочих узлов scatter, а рабочий узел combine собирает результаты каждого сегмента в полное рабочее состояние, сокращая время холодного префиллинга с $O(n \cdot |C|)$ до $O(\lceil n/m \rceil \cdot |C| + c)$. Чтобы полностью использовать этот путь, HYPIC использует жадную стратегию LPT (Longest Processing Time) для балансировки нагрузки между рабочими узлами и перекрывает вычисления и передачу каждого сегмента, чтобы избежать задержки рабочего узла combine из-за синхронных всплесков передачи; параллелизм на уровне сегментов и внутриэкземплярный параллелизм (TP/DP/SP) работают по ортогональным осям и могут быть бесшовно объединены.
Эта система реализована в SGLang и состоит примерно из 14 000 строк кода на Python и Triton. Она была оценена на восьми узлах H20 с использованием четырех производственных моделей с гибридным вниманием (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), четырех публичных наборов данных (HotpotQA, TriviaQA, MultiNews, GovReport) и одного производственного следа RAG. После полного прогрева, по сравнению с Prefix Cache, HYPIC снижает p50 TTFT в среднем в 3,25 раза (с 2,77× до 4,05×), практически без потери качества — в среднем по 16 парам «модель × набор данных» отставание от полного пересчета составило всего 1,71 балла, а на Qwen3.5-35B даже превысило его на 0,47 балла. Для сравнения, наивное сложение без кэширования операторов перехода потеряло 66,9% баллов, что подтверждает необходимость $T_C$. На производственном следе RAG, при том же SLA TTFT в 1 секунду, HYPIC увеличил устойчивое количество запросов в секунду (QPS) в 1,66 раза (с 1,49× до 1,85×), а пиковая пропускная способность на карту увеличилась примерно в 1,3–1,5 раза. На чистом пути холодных промахов TTFT запроса на 32k токенов снизился с 2,83 секунды на одном рабочем узле до 0,49 секунды на восьми рабочих узлах, достигнув ускорения в 5,7 раза, при этом почти все преимущества пришли от масштабируемой стадии scatter. Против неравномерного шардирования LPT снизил TTFT с 1,26 секунды до 0,84 секунды (3,6× против 2,4×). Накладные расходы также управляемы: одноразовая стоимость построения $(T_C, S(C|0))$ составляет всего 5,2%–6,7% от основного прямого прохода в самой тяжелой плотной модели передачи, и эту стоимость можно амортизировать за счет многократного повторного использования.
HYPIC впервые приносит кэширование, независимое от позиции, в большие модели с гибридным вниманием: он обеспечивает комбинирование состояния за постоянное время для линейных слоев с использованием кэшированных по сегментам накопленных операторов перехода, исправляет межсегментное выравнивание для слоев полного внимания с помощью небольших стыковых окон и превращает длинные холодные запросы в ускоренные рабочие нагрузки с использованием параллелизма на уровне сегментов. Это позволяет сервисам с длинным контекстом, таким как RAG и агенты, пользоваться преимуществами повторного использования сегментного кэша, одновременно используя эффективные гибридные архитектуры. Команда заявила, что будущая работа будет сосредоточена на исследовании распределенного управления и планирования PIC, а также управления многоуровневыми иерархиями кэша, что еще больше продвинет вывод больших моделей в сторону более быстрых, экономически эффективных и масштабируемых решений.
Связанная статья
 WeChat WeMM-Embedding усиливает поиск в Moments и выделяет лучшие видео, обрабатывая 1 миллиард запросов ежедневно
4 сентября WeChat AI объявил об открытии исходного кода своей общей мультимодальной модели встраивания WeMM-Embedding. Модель доступна в версиях 2B, 4B и 9B и поддерживает работу с текстом, изображениями, видео, визуальными документами, а также любым
ChatGPT представляет пользовательские стикеры, бесшовно совместимые с ведущими социальными платформами
OpenAI официально представила новую функцию пользовательских наклеек для ChatGPT, расширяя границы применения искусственного интеллекта в создании массового социального контента.Пользователи могут создавать персонализированные наклейки с помощью инт
Anthropic проводит тихое серое тестирование Claude Opus 5.2 и внутренней модели 2
Новейшая флагманская модель Anthropic, Opus 5.2, тихо поступила на раннее тестирование в Claude Code этим утром. Разработчики отметили заметное расхождение в производительности между вызовами API и веб-интерфейсом. Анализ пакетов показывает, что иден
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Основное внимание в сервисах больших языковых моделей смещается от одношаговых диалогов к вопросам с дополнением извлечения (retrieval-augmented question answering), многодокументному суммированию и агентам с дальним контекстом. Эти новые рабочие нагрузки имеют общую ключевую особенность: промпт одного запроса часто состоит от десятков до сотен семантически независимых сегментов, включая извлеченные документы, описания навыков, файлы памяти и предыдущие раунды разговора, все они собираются в ультрадлинные контексты объемом от десятков тысяч до сотен тысяч токенов. На таком масштафе фаза префиллинга (prefill) доминирует в вычислительных затратах на один запрос, становясь наиболее заметной статьей расходов для провайдеров услуг. Более критично то, что промахи кэша могут привести к резкому увеличению задержки до первого токена (TTFT) до нескольких секунд, что сильно ухудшает пользовательский опыт.
В отрасли были приняты две стратегии снижения затрат. Первая — это кэширование, независимое от позиции (PIC), которое ослабляет строгие ограничения префикса, позволяя каждому семантически независимому сегменту кэшироваться один раз, а затем вставляться в любой префикс, что идеально соответствует составлению промптов в RAG и агентах. Его основные механизмы — это сшивка (splice), которая напрямую конкатенирует данные по оси токенов, и коррекция (correction), которая пересчитывает несколько токенов для восстановления контекста между сегментами. Второй подход — гибридная модель внимания, которая заменяет большинство слоев полного внимания на линейное внимание, снижая квадратичную сложность до линейной и сжимая неограниченную историю в состояние фиксированного размера. Недавние производственные модели, такие как MiniMax-M1, Ring-2.5, Qwen3.5 и Kimi-Linear, линейризуют более 75% своих слоев, оставляя лишь несколько слоев полного внимания, формируя основной гибридный дизайн. Например, Qwen3.5-35B-A3B имеет 30 линейных слоев из 40 всего.
Основное противоречие заключается здесь: существующее PIC работает с кэшем ключ-значение (KV) на уровне токенов, в то время как слои линейного внимания предоставляют только циклическое состояние на уровне запроса, не имея крючков на уровне токенов для сшивки или коррекции. Следовательно, большинство слоев в гибридных моделях выходят за рамки возможностей существующих систем PIC. До сих пор ни одна система не предоставляла кэширование, независимое от позиции, для больших моделей с гибридным вниманием.
Разработанная командой вывода больших моделей Xiaohongshu совместно с Пекинским университетом и Шанхайским университетом Цзяо Тун, HYPIC является первой сервисной системой, реализующей PIC для больших моделей с гибридным вниманием. Тестирование на четырех производственных моделях с гибридным вниманием и пяти рабочих нагрузках показывает, что HYPIC снижает задержку первого токена в среднем в 3,25 раза и увеличивает устойчивое количество запросов в секунду (QPS) в 1,66 раза при том же уровне SLA, при этом качество задач отличается всего на 1,71 балла от полного пересчета. Основная идея системы заключается в раздельной обработке слоев линейного и полного внимания внутри гибридной модели, ускорении холодных запросов за счет параллелизма на уровне слоев с помощью трех взаимосвязанных механизмов.
Для линейных слоев HYPIC кэширует «операторы перехода», что позволяет комбинировать состояние за постоянное время. Наиболее простое решение PIC — это прямое сложение конечных состояний двух сегментов с нулевыми начальными значениями, что справедливо для наивного линейного внимания, но не работает в продвинутом линейном внимании с затуханием, гейтами или стиранием дельта-значений (например, RetNet, Mamba2, GLA, DeltaNet, GDN, KDA). Критически отсутствующей величиной является накопленный оператор перехода $T_C$ сегмента, то есть произведение всех матриц переходов токенов внутри него. Фактическое конечное состояние должно быть $S(C1 \cdot C2) = T(C2) \cdot S(C1) + S(C2)$, в то время как простое сложение пропускает член $T(C2)$, вызывая структурную ошибку. Тесты показали, что медленная головка затухания в RetNet демонстрировала ошибку, составляющую 22% от нормы состояния при 256 токенах. Ключевое наблюдение HYPIC заключается в том, что $T_C$ и конечное состояние с нулевым начальным значением $S(C|0)$ определяются исключительно внутренними токенами сегмента и не зависят от префикса. Таким образом, при первом префиллинге сегмента HYPIC кэширует пару $(T_C, S(C|0))$, а при повторном использовании применяет левое умножение на $T_C$ с последующим сложением, чтобы почти точно восстановить конечное состояние в любом префиксе, естественно охватывая все семейство линейного внимания. Тесты на Qwen3.5-35B-A3B показали, что комбинированные состояния отличались от полного пересчета всего на $6 \times 10^{-5}$, что находится в пределах шума FP16. Для вариантов с причинно-следственной сверткой или RoPE HYPIC использует два патча — предварительную загрузку состояния свертки и повторное вращение состояния — для достижения строгого соответствия.
Для слоев полного внимания HYPIC использует «стыковые окна» (seam windows) для исправления межсегментного внимания. Хотя в гибридных моделях все еще требуется несколько слоев полного внимания, использующих PIC, предыдущие методы селективного пересчета нельзя напрямую перенести, поскольку последующие линейные слои сохраняют только конечное состояние, что делает невозможным прохождение нетерминальных токенов вверх через слой полного внимания. Хранение циклического состояния для каждого токена или пересчет с нуля невозможны из-за ограничений на хранение или вычисления. Команда обнаружила, что смещение после конкатенации KV сильно сосредоточено в начале каждого повторно используемого сегмента, а остальная часть почти не затрагивается, что согласуется с явлением «поглощения внимания» (attention sink) в моделях полного внимания, что также справедливо для моделей гибридного внимания. На основе этого HYPIC конструирует стыковое окно из $w$ токенов в начале каждого внутреннего сегмента, исключая эти токены из кэширования. При повторном использовании они пересчитываются в полном префиксе для восстановления межсегментного внимания, при этом $w=8$ по умолчанию; поскольку фактическая длина сегмента обычно превышает 512 токенов, стыковое окно составляет очень малую часть, что делает стоимость пересчета управляемой. Для поддержки пересчета начального KV слои линейного внимания вычисляют $T$ и $S$ стыкового окна при повторном использовании, продвигая рабочее состояние, одновременно передавая выходные данные каждого слоя для каждого токена стыка в верхний слой полного внимания.
Третьим компонентом является параллелизм на уровне сегментов, преобразующий «длинные холодные запросы» в ускоренные рабочие нагрузки. Промахи кэша неизбежны из-за непрерывного обновления корпусов и удаления документов с низкой частотой, при этом длинные холодные запросы являются основной причиной задержек в хвосте распределения. Существующие системы рассматривают весь промпт как единую сущность, последовательно префилляя все холодные сегменты на одном экземпляре, при этом TTFT растет как $O(n \cdot |C|)$; хотя параллелизм тензоров и другие виды внутриэкземплярного параллелизма могут ускорять отдельные прямые проходы, их масштабируемость ограничена, и запрос на 100k токенов на TP-8 все еще занимает 17,7 секунды. Однако PIC уже сделал каждый сегмент самодостаточным — результаты его префиллинга зависят только от его внутренних токенов. HYPIC предлагает межэкземплярный параллелизм на уровне сегментов: маршрутизатор (Router) определяет, попал ли каждый сегмент в кэш, затем распределяет холодные сегменты параллельно на несколько рабочих узлов scatter, а рабочий узел combine собирает результаты каждого сегмента в полное рабочее состояние, сокращая время холодного префиллинга с $O(n \cdot |C|)$ до $O(\lceil n/m \rceil \cdot |C| + c)$. Чтобы полностью использовать этот путь, HYPIC использует жадную стратегию LPT (Longest Processing Time) для балансировки нагрузки между рабочими узлами и перекрывает вычисления и передачу каждого сегмента, чтобы избежать задержки рабочего узла combine из-за синхронных всплесков передачи; параллелизм на уровне сегментов и внутриэкземплярный параллелизм (TP/DP/SP) работают по ортогональным осям и могут быть бесшовно объединены.
Эта система реализована в SGLang и состоит примерно из 14 000 строк кода на Python и Triton. Она была оценена на восьми узлах H20 с использованием четырех производственных моделей с гибридным вниманием (Ring-mini/flash-linear-2.0, Qwen3.5-35B-A3B/122B-A10B), четырех публичных наборов данных (HotpotQA, TriviaQA, MultiNews, GovReport) и одного производственного следа RAG. После полного прогрева, по сравнению с Prefix Cache, HYPIC снижает p50 TTFT в среднем в 3,25 раза (с 2,77× до 4,05×), практически без потери качества — в среднем по 16 парам «модель × набор данных» отставание от полного пересчета составило всего 1,71 балла, а на Qwen3.5-35B даже превысило его на 0,47 балла. Для сравнения, наивное сложение без кэширования операторов перехода потеряло 66,9% баллов, что подтверждает необходимость $T_C$. На производственном следе RAG, при том же SLA TTFT в 1 секунду, HYPIC увеличил устойчивое количество запросов в секунду (QPS) в 1,66 раза (с 1,49× до 1,85×), а пиковая пропускная способность на карту увеличилась примерно в 1,3–1,5 раза. На чистом пути холодных промахов TTFT запроса на 32k токенов снизился с 2,83 секунды на одном рабочем узле до 0,49 секунды на восьми рабочих узлах, достигнув ускорения в 5,7 раза, при этом почти все преимущества пришли от масштабируемой стадии scatter. Против неравномерного шардирования LPT снизил TTFT с 1,26 секунды до 0,84 секунды (3,6× против 2,4×). Накладные расходы также управляемы: одноразовая стоимость построения $(T_C, S(C|0))$ составляет всего 5,2%–6,7% от основного прямого прохода в самой тяжелой плотной модели передачи, и эту стоимость можно амортизировать за счет многократного повторного использования.
HYPIC впервые приносит кэширование, независимое от позиции, в большие модели с гибридным вниманием: он обеспечивает комбинирование состояния за постоянное время для линейных слоев с использованием кэшированных по сегментам накопленных операторов перехода, исправляет межсегментное выравнивание для слоев полного внимания с помощью небольших стыковых окон и превращает длинные холодные запросы в ускоренные рабочие нагрузки с использованием параллелизма на уровне сегментов. Это позволяет сервисам с длинным контекстом, таким как RAG и агенты, пользоваться преимуществами повторного использования сегментного кэша, одновременно используя эффективные гибридные архитектуры. Команда заявила, что будущая работа будет сосредоточена на исследовании распределенного управления и планирования PIC, а также управления многоуровневыми иерархиями кэша, что еще больше продвинет вывод больших моделей в сторону более быстрых, экономически эффективных и масштабируемых решений.








 WeChat WeMM-Embedding усиливает поиск в Moments и выделяет лучшие видео, обрабатывая 1 миллиард запросов ежедневно
4 сентября WeChat AI объявил об открытии исходного кода своей общей мультимодальной модели встраивания WeMM-Embedding. Модель доступна в версиях 2B, 4B и 9B и поддерживает работу с текстом, изображениями, видео, визуальными документами, а также любым
 ChatGPT представляет пользовательские стикеры, бесшовно совместимые с ведущими социальными платформами
OpenAI официально представила новую функцию пользовательских наклеек для ChatGPT, расширяя границы применения искусственного интеллекта в создании массового социального контента.Пользователи могут создавать персонализированные наклейки с помощью инт
 Anthropic проводит тихое серое тестирование Claude Opus 5.2 и внутренней модели 2
Новейшая флагманская модель Anthropic, Opus 5.2, тихо поступила на раннее тестирование в Claude Code этим утром. Разработчики отметили заметное расхождение в производительности между вызовами API и веб-интерфейсом. Анализ пакетов показывает, что иден

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












