


 家
小紅書、北京大學、上海交通大學が HYPIC を発表し、ハイブリッドAttentionモデルにおける最初のトークンのレイテンシーを3.25倍削減
大規模モデルサービスの主要な焦点は、単一ターン対話から、検索拡張質問応答(RAG)、複数文書要約、および長期エージェントへと移行している。これらの新興ワークロードには共通する重要な特徴がある。すなわち、単一のリクエストのプロンプトは、取得された文書、スキル記述、メモリファイル、および過去の会話ラウンドなど、数十から数百の意味的に独立したセグメントで構成され、これらが数万から数十万トークンに及ぶ超長文脈に組み立てられる点である。この規模において、プリフィルフェーズはリクエストあたりの計算コストの大部分を占め、サービスプロバイダーにとって最も顕著な費用となっている。さらに重要なのは、キャッシュミスが発生すると、最初のトークンまでの時間(TTFT)が数秒に急増し、ユーザー体験が著しく低下することである。
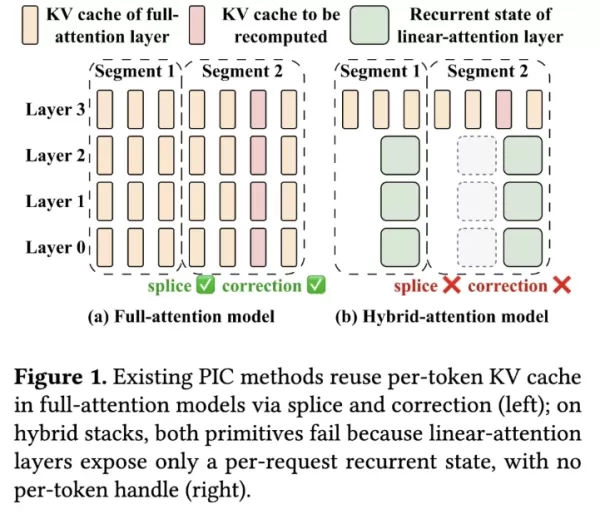
業界はコスト削減のために2つの戦略を採用している。第一に位置非依存キャッシング(PIC)がある。これは厳格な接頭辞の制緩を緩和し、各意味的に独立したセグメントを一度キャッシュした後、任意の接頭辞にスプライス(結合)することを可能にする。これはRAGおよびエージェントのプロンプト構成と完全に一致する。その中核メカニズムは、トークン軸に沿って直接連結する「スプライス」と、少数のトークンを再計算してセグメント間の文脈を復元する「補正」である。第二のアプローチはハイブリッドアテンションモデルであり、大半のフルアテンションレイヤーを線形アテンションに置き換え、二次複雑度を線形に圧縮し、無制限の履歴を固定サイズの循環状態に圧縮する。MiniMax-M1、Ring-2.5、Qwen3.5、Kimi-Linearなどの最近のプロダクションモデルは、レイヤーの75%以上を線形化し、数層のフルアテンションレイヤーのみを残し、主流のハイブリッド設計を形成している。例えば、Qwen3.5-35B-A3Bは、合計40層のうち30層が線形層である。
ここには中核的な矛盾がある。既存のPICはトークンごとのキー・バリュー(KV)キャッシュ上で動作するが、線形アテンションレイヤーはリクエストごとの循環状態のみを公開し、スプライスや補正のためのトークンごとのフックを持たない。その結果、ハイブリッドモデルの大半のレイヤーは、既存のPICシステムの能力範囲外となる。これまで、ハイブリッドアテンション大規模モデルに対する位置非依存キャッシングを提供するシステムは存在しなかった。
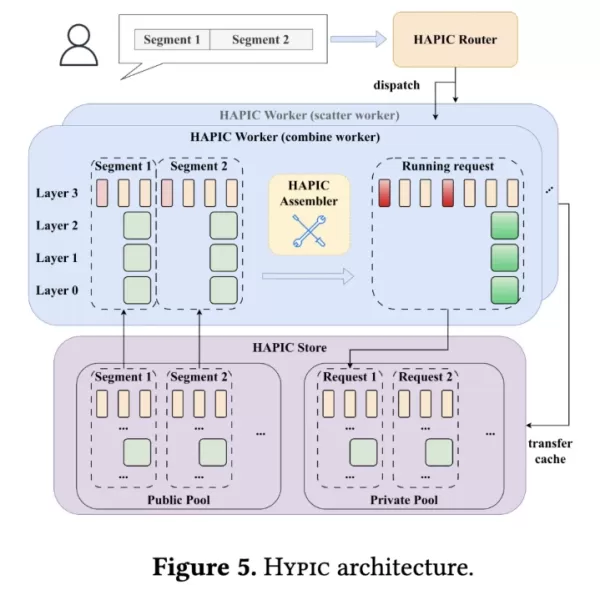
小紅書大規模モデル推論チームが北京大学および上海交通大学と共同で開発したHYPICは、ハイブリッドアテンション大規模モデル上でPICを実装した初のサービスシステムである。4つのプロダクションレベルのハイブリッドアテンションモデルおよび5つのワークロードにわたるテストにより、HYPICは同等のSLO(サービスレベル目標)の下で、最初のトークン遅延を平均3.25倍削減し、持続可能なQPSを1.66倍増加させ、タスク品質は完全再計算と比べてわずか1.71ポイントの差異にとどまった。システムの核心理念は、ハイブリッドモデル内で線形層とフルアテンション層を別々に処理し、3つの相互連動するメカニズムによるレイヤーレベルの並列化を通じてコールドリクエストを加速することである。
線形層について、HYPICは「遷移演算子」をキャッシュし、定数時間の状態結合を可能にする。最も単純なPICのストローマンソリューションは、ゼロの初期値を持つ2つのセグメントの最終状態を直接加算することである。これは単純な線形アテンションでは有効だが、減衰、ゲート、またはデルタ消去(例えばRetNet、Mamba2、GLA、DeltaNet、GDN、KDA)を備えた高度な線形アテンションでは失敗する。重要な欠落量は、セグメントの累積遷移演算子T_C、すなわちその内部のすべてのトークン遷移行列の積である。実際の最終状態はS(C1・C2) = T(C2) · S(C1) + S(C2)であり、単純な加算はT(C2)項を省略し、構造的誤差を引き起こす。テストにより、RetNetの減衰ヘッドは256トークンで状態ノルムの22%の誤差を示した。HYPICの重要な洞察は、T_Cおよびゼロ初期状態の最終状態S(C|0)がセグメント内部のトークンのみに依存し、接頭辞には依存しないという点である。したがって、セグメントの最初のプリフィル時に、HYPICはペア(T_C, S(C|0))をキャッシュし、再利用時にはT_Cの左乗算に続く加算を適用することで、任意の接頭辞の下で最終状態をほぼ正確に再構築し、自然に線形アテンションファミリー全体をカバーする。Qwen3.5-35B-A3Bでのテストでは、結合状態は完全再計算と比べてわずか6×10⁻⁵の差異であり、FP16のノイズ範囲内であった。因果畳み込みまたはRoPEを持つ変種について、HYPICは畳み込み状態のウォームアップおよび状態の再回転という2つのパッチを使用し、厳密な整合性を達成する。
フルアテンション層について、HYPICは「シームウィンドウ」を使用してセグメント間のアテンションを固定する。ハイブリッドモデルにおいてはいくつかのフルアテンション層がPICを必要とするものの、以前の選択的再計算は直接移行できない。なぜなら、下位の線形層は最終状態のみを保持しており、非終端トークンがフルアテンション層を通過して上位に渡すことが不可能だからである。ストレージまたは計算の制約により、トークンごとの循環状態を保存したり、最初から再計算したりすることは実行不可能である。チームは、KV連結後のバイアスが各再利用セグメントの開始部に高度に集中しており、残りの部分はほとんど影響を受けないことを観察した。これはフルアテンションモデルにおけるアテンションシンク現象と一致し、ハイブリッドアテンションモデルでも成立する。これに基づき、HYPICは各内部セグメントの開始部にwトークンのシームウィンドウを構築し、これらのトークンをキャッシュから除外する。再利用時、これらは完全な接頭辞の下で再計算され、セグメント間のアテンションを修復する。デフォルトではw=8であり、実際のセグメント長は通常512トークン以上であるため、シームウィンドウは非常に小さな部分を構成し、再計算コストは管理可能である。初期KVの再計算をサポートするため、線形アテンション層は再利用中にシームウィンドウのTおよびSを計算し、実行状態を進めながら、各シームトークンのレイヤーごとの出力を上位のフルアテンション層に転送する。
3番目のコンポーネントはセグメントレベルの並列化であり、「長いコールドリクエスト」を加速されたワークロードに変換する。継続的なコーパス更新および低頻度文書の削除によりキャッシュミスは避けられず、長いコールドリクエストがテールレイテンシの主な原因である。既存システムはプロンプト全体を単一エンティティとして扱い、単一のインスタンス上ですべてのコールドセグメントを直列にプリフィルし、TTFTはO(n·|C|)として増加する。テンソル並列化およびその他のインスタンス内並列化が個々の順伝播を高速化できるものの、そのスケーラビリティは限られており、TP-8における100kトークンのリクエストでも17.7秒を要する。しかし、PICはすでに各セグメントを自己完結型にしている。すなわち、そのプリフィル結果は内部トークンのみに依存する。HYPICはインスタンス間セグメントレベルの並列化を提案する。ルーターは各セグメントがキャッシュにヒットするかどうかを検出し、コールドセグメントを複数のスキャッターワーカーに並列で分散し、コンバインワーカーが各セグメントの結果を完全な実行状態に組み立てる。これにより、コールドプリフィル時間をO(n·|C|)からO(⌈n/m⌉·|C|+c)に削減する。このパスを完全に活用するため、HYPICはワーカー間でワークロードをバランスさせるために貪欲なLPT(最長処理時間)戦略を使用し、各セグメントの計算と伝送をオーバーラップさせて、コンバインワーカーが同期伝送バーストによって遅延されないようにする。セグメントレベルの並列化とインスタンス内並列化(TP/DP/SP)は直交軸上で動作し、シームレスに組み合わせ可能である。
このシステムはSGLang上に実装されており、約14,000行のPythonおよびTritonコードから構成される。4つのプロダクションレベルのハイブリッドアテンションモデル(Ring-mini/flash-linear-2.0、Qwen3.5-35B-A3B/122B-A10B)、4つの公開データセット(HotpotQA、TriviaQA、MultiNews、GovReport)、および1つのプロダクションRAGトレースを用いて、8つのH20ノード上で評価された。完全な予熱後、Prefix Cacheと比較して、HYPICはp50 TTFTを平均3.25倍削減(2.77倍から4.05倍)し、品質損失はほぼない。16の「モデル×データセット」ユニットは完全再計算より平均1.71ポイント遅れただけであり、Qwen3.5-35Bでは0.47ポイント上回ることもあった。比較として、遷移演算子をキャッシュしない単純な加算ではスコアが66.9%損失し、T_Cの必要性を確認した。プロダクションRAGトレースにおいて、同等の1秒TTFT SLOの下、HYPICは持続可能なQPSを1.66倍増加(1.49倍から1.85倍)させ、カードあたりのピークスループットは約1.3〜1.5倍増加した。純粋なコールドミスパスにおいて、32kトークンのリクエストのTTFTは単一ワーカーで2.83秒から、8ワーカーで0.49秒に低下し、5.7倍の高速化を達成した。そのほとんどはスケーラブルなスキャッターステージからのGainである。不均一なシャーディングに対して、LPTはTTFTを1.26秒から0.84秒に削減(3.6倍対2.4倍)した。オーバーヘッドも管理可能である。重たい密伝達モデルにおける主要な順伝播パスの5.2%〜6.7%に過ぎない(T_C, S(C|0))の構築の一回のコストは、複数回の再利用によって摊销可能である。
HYPICは、位置非依存キャッシングをハイブリッドアテンション大規模モデルに初めて導入する。線形層に対してキャッシュされたセグメントごとの累積遷移演算子を用いて定数時間の状態結合を可能にし、フルアテンション層に対して小さなシームウィンドウでセグメント間の整合性を固定し、セグメントレベルの並列化を用いて長いコールドリクエストを加速されたワークロードに変換する。これにより、RAGおよびエージェントのような長文脈サービスは、セグメントレベルのキャッシュ再利用の恩恵を受けながら、効率的なハイブリッドアーキテクチャを採用できる。チームは、今後の作業は分散PICの管理およびスケジューリング、およびマルチレベルキャッシュ階層管理の探索に焦点を当て、大規模モデル推論をさらに高速で、コスト効果が高く、スケーラブルなソリューションへと推進すると述べている。
関連記事
 WeChat WeMM-Embeddingは、毎日10億回の呼び出しでMoments検索と動画のハイライトを強化します
9月4日、WeChat AIは汎用マルチモーダル埋め込みモデル「WeMM-Embedding」のオープンソース公開を発表した。2B、4B、9Bの3つのバージョンが提供され、テキスト、画像、動画、視覚文書、および任意のインターリーブされたマルチモーダル入力に対応している。WeChatの社員である@KeCunXiaoJiang氏によると、WeChatビジュアルチームがオープンソース化したマルチモーダルモデル「WeMM-Embedding」は、テキスト、画像、動画を共有された意味空間に配置することで比
ChatGPT、主要なソーシャルメディアプラットフォームとシームレスに互換性のあるカスタムステッカーを発表
OpenAIはChatGPT向けに新しいカスタムスタック機能正式に導入し、大衆的なソーシャルコンテンツ作成におけるAIの限界を押し広げている。ユーザーは、写真のアップロード、テキストプロンプトの使用、またはさまざまな視覚芸術スタイルの適用など、直感的な方法を通じてパーソナライズされたスタックを作成できる。この機能は、知的な画像のトリミングと修復を活用し、クリーンで透明な背景を持つスタックを自動的に生成し、複数のデザインをまとめて完全なカスタムスタックパックにまとめることができる。この機能はシ
Anthropic、Claude Opus 5.2 および内部モデル 2 の静かなグレースケールテストを開始
Anthropicの最新フラッグシップモデル、Opus 5.2は、今朝Claude Code内の早期テストフェーズに静かに導入された。開発者たちは、API呼び出しとWebインターフェースの間で顕著なパフォーマンスの相違を指摘している。パケット分析により、バックエンドのモデル識別子がすでにOpus 5.2に切り替えられていることが判明し、この未発表のイテレーションが実際の開発者のワークフローを積極的に支えていることが示唆されている。さらなる驚きとして、Anthropicからの内部リスクアセスメン
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
大規模モデルサービスの主要な焦点は、単一ターン対話から、検索拡張質問応答(RAG)、複数文書要約、および長期エージェントへと移行している。これらの新興ワークロードには共通する重要な特徴がある。すなわち、単一のリクエストのプロンプトは、取得された文書、スキル記述、メモリファイル、および過去の会話ラウンドなど、数十から数百の意味的に独立したセグメントで構成され、これらが数万から数十万トークンに及ぶ超長文脈に組み立てられる点である。この規模において、プリフィルフェーズはリクエストあたりの計算コストの大部分を占め、サービスプロバイダーにとって最も顕著な費用となっている。さらに重要なのは、キャッシュミスが発生すると、最初のトークンまでの時間(TTFT)が数秒に急増し、ユーザー体験が著しく低下することである。
業界はコスト削減のために2つの戦略を採用している。第一に位置非依存キャッシング(PIC)がある。これは厳格な接頭辞の制緩を緩和し、各意味的に独立したセグメントを一度キャッシュした後、任意の接頭辞にスプライス(結合)することを可能にする。これはRAGおよびエージェントのプロンプト構成と完全に一致する。その中核メカニズムは、トークン軸に沿って直接連結する「スプライス」と、少数のトークンを再計算してセグメント間の文脈を復元する「補正」である。第二のアプローチはハイブリッドアテンションモデルであり、大半のフルアテンションレイヤーを線形アテンションに置き換え、二次複雑度を線形に圧縮し、無制限の履歴を固定サイズの循環状態に圧縮する。MiniMax-M1、Ring-2.5、Qwen3.5、Kimi-Linearなどの最近のプロダクションモデルは、レイヤーの75%以上を線形化し、数層のフルアテンションレイヤーのみを残し、主流のハイブリッド設計を形成している。例えば、Qwen3.5-35B-A3Bは、合計40層のうち30層が線形層である。
ここには中核的な矛盾がある。既存のPICはトークンごとのキー・バリュー(KV)キャッシュ上で動作するが、線形アテンションレイヤーはリクエストごとの循環状態のみを公開し、スプライスや補正のためのトークンごとのフックを持たない。その結果、ハイブリッドモデルの大半のレイヤーは、既存のPICシステムの能力範囲外となる。これまで、ハイブリッドアテンション大規模モデルに対する位置非依存キャッシングを提供するシステムは存在しなかった。
小紅書大規模モデル推論チームが北京大学および上海交通大学と共同で開発したHYPICは、ハイブリッドアテンション大規模モデル上でPICを実装した初のサービスシステムである。4つのプロダクションレベルのハイブリッドアテンションモデルおよび5つのワークロードにわたるテストにより、HYPICは同等のSLO(サービスレベル目標)の下で、最初のトークン遅延を平均3.25倍削減し、持続可能なQPSを1.66倍増加させ、タスク品質は完全再計算と比べてわずか1.71ポイントの差異にとどまった。システムの核心理念は、ハイブリッドモデル内で線形層とフルアテンション層を別々に処理し、3つの相互連動するメカニズムによるレイヤーレベルの並列化を通じてコールドリクエストを加速することである。
線形層について、HYPICは「遷移演算子」をキャッシュし、定数時間の状態結合を可能にする。最も単純なPICのストローマンソリューションは、ゼロの初期値を持つ2つのセグメントの最終状態を直接加算することである。これは単純な線形アテンションでは有効だが、減衰、ゲート、またはデルタ消去(例えばRetNet、Mamba2、GLA、DeltaNet、GDN、KDA)を備えた高度な線形アテンションでは失敗する。重要な欠落量は、セグメントの累積遷移演算子T_C、すなわちその内部のすべてのトークン遷移行列の積である。実際の最終状態はS(C1・C2) = T(C2) · S(C1) + S(C2)であり、単純な加算はT(C2)項を省略し、構造的誤差を引き起こす。テストにより、RetNetの減衰ヘッドは256トークンで状態ノルムの22%の誤差を示した。HYPICの重要な洞察は、T_Cおよびゼロ初期状態の最終状態S(C|0)がセグメント内部のトークンのみに依存し、接頭辞には依存しないという点である。したがって、セグメントの最初のプリフィル時に、HYPICはペア(T_C, S(C|0))をキャッシュし、再利用時にはT_Cの左乗算に続く加算を適用することで、任意の接頭辞の下で最終状態をほぼ正確に再構築し、自然に線形アテンションファミリー全体をカバーする。Qwen3.5-35B-A3Bでのテストでは、結合状態は完全再計算と比べてわずか6×10⁻⁵の差異であり、FP16のノイズ範囲内であった。因果畳み込みまたはRoPEを持つ変種について、HYPICは畳み込み状態のウォームアップおよび状態の再回転という2つのパッチを使用し、厳密な整合性を達成する。
フルアテンション層について、HYPICは「シームウィンドウ」を使用してセグメント間のアテンションを固定する。ハイブリッドモデルにおいてはいくつかのフルアテンション層がPICを必要とするものの、以前の選択的再計算は直接移行できない。なぜなら、下位の線形層は最終状態のみを保持しており、非終端トークンがフルアテンション層を通過して上位に渡すことが不可能だからである。ストレージまたは計算の制約により、トークンごとの循環状態を保存したり、最初から再計算したりすることは実行不可能である。チームは、KV連結後のバイアスが各再利用セグメントの開始部に高度に集中しており、残りの部分はほとんど影響を受けないことを観察した。これはフルアテンションモデルにおけるアテンションシンク現象と一致し、ハイブリッドアテンションモデルでも成立する。これに基づき、HYPICは各内部セグメントの開始部にwトークンのシームウィンドウを構築し、これらのトークンをキャッシュから除外する。再利用時、これらは完全な接頭辞の下で再計算され、セグメント間のアテンションを修復する。デフォルトではw=8であり、実際のセグメント長は通常512トークン以上であるため、シームウィンドウは非常に小さな部分を構成し、再計算コストは管理可能である。初期KVの再計算をサポートするため、線形アテンション層は再利用中にシームウィンドウのTおよびSを計算し、実行状態を進めながら、各シームトークンのレイヤーごとの出力を上位のフルアテンション層に転送する。
3番目のコンポーネントはセグメントレベルの並列化であり、「長いコールドリクエスト」を加速されたワークロードに変換する。継続的なコーパス更新および低頻度文書の削除によりキャッシュミスは避けられず、長いコールドリクエストがテールレイテンシの主な原因である。既存システムはプロンプト全体を単一エンティティとして扱い、単一のインスタンス上ですべてのコールドセグメントを直列にプリフィルし、TTFTはO(n·|C|)として増加する。テンソル並列化およびその他のインスタンス内並列化が個々の順伝播を高速化できるものの、そのスケーラビリティは限られており、TP-8における100kトークンのリクエストでも17.7秒を要する。しかし、PICはすでに各セグメントを自己完結型にしている。すなわち、そのプリフィル結果は内部トークンのみに依存する。HYPICはインスタンス間セグメントレベルの並列化を提案する。ルーターは各セグメントがキャッシュにヒットするかどうかを検出し、コールドセグメントを複数のスキャッターワーカーに並列で分散し、コンバインワーカーが各セグメントの結果を完全な実行状態に組み立てる。これにより、コールドプリフィル時間をO(n·|C|)からO(⌈n/m⌉·|C|+c)に削減する。このパスを完全に活用するため、HYPICはワーカー間でワークロードをバランスさせるために貪欲なLPT(最長処理時間)戦略を使用し、各セグメントの計算と伝送をオーバーラップさせて、コンバインワーカーが同期伝送バーストによって遅延されないようにする。セグメントレベルの並列化とインスタンス内並列化(TP/DP/SP)は直交軸上で動作し、シームレスに組み合わせ可能である。
このシステムはSGLang上に実装されており、約14,000行のPythonおよびTritonコードから構成される。4つのプロダクションレベルのハイブリッドアテンションモデル(Ring-mini/flash-linear-2.0、Qwen3.5-35B-A3B/122B-A10B)、4つの公開データセット(HotpotQA、TriviaQA、MultiNews、GovReport)、および1つのプロダクションRAGトレースを用いて、8つのH20ノード上で評価された。完全な予熱後、Prefix Cacheと比較して、HYPICはp50 TTFTを平均3.25倍削減(2.77倍から4.05倍)し、品質損失はほぼない。16の「モデル×データセット」ユニットは完全再計算より平均1.71ポイント遅れただけであり、Qwen3.5-35Bでは0.47ポイント上回ることもあった。比較として、遷移演算子をキャッシュしない単純な加算ではスコアが66.9%損失し、T_Cの必要性を確認した。プロダクションRAGトレースにおいて、同等の1秒TTFT SLOの下、HYPICは持続可能なQPSを1.66倍増加(1.49倍から1.85倍)させ、カードあたりのピークスループットは約1.3〜1.5倍増加した。純粋なコールドミスパスにおいて、32kトークンのリクエストのTTFTは単一ワーカーで2.83秒から、8ワーカーで0.49秒に低下し、5.7倍の高速化を達成した。そのほとんどはスケーラブルなスキャッターステージからのGainである。不均一なシャーディングに対して、LPTはTTFTを1.26秒から0.84秒に削減(3.6倍対2.4倍)した。オーバーヘッドも管理可能である。重たい密伝達モデルにおける主要な順伝播パスの5.2%〜6.7%に過ぎない(T_C, S(C|0))の構築の一回のコストは、複数回の再利用によって摊销可能である。
HYPICは、位置非依存キャッシングをハイブリッドアテンション大規模モデルに初めて導入する。線形層に対してキャッシュされたセグメントごとの累積遷移演算子を用いて定数時間の状態結合を可能にし、フルアテンション層に対して小さなシームウィンドウでセグメント間の整合性を固定し、セグメントレベルの並列化を用いて長いコールドリクエストを加速されたワークロードに変換する。これにより、RAGおよびエージェントのような長文脈サービスは、セグメントレベルのキャッシュ再利用の恩恵を受けながら、効率的なハイブリッドアーキテクチャを採用できる。チームは、今後の作業は分散PICの管理およびスケジューリング、およびマルチレベルキャッシュ階層管理の探索に焦点を当て、大規模モデル推論をさらに高速で、コスト効果が高く、スケーラブルなソリューションへと推進すると述べている。








 WeChat WeMM-Embeddingは、毎日10億回の呼び出しでMoments検索と動画のハイライトを強化します
9月4日、WeChat AIは汎用マルチモーダル埋め込みモデル「WeMM-Embedding」のオープンソース公開を発表した。2B、4B、9Bの3つのバージョンが提供され、テキスト、画像、動画、視覚文書、および任意のインターリーブされたマルチモーダル入力に対応している。WeChatの社員である@KeCunXiaoJiang氏によると、WeChatビジュアルチームがオープンソース化したマルチモーダルモデル「WeMM-Embedding」は、テキスト、画像、動画を共有された意味空間に配置することで比
 ChatGPT、主要なソーシャルメディアプラットフォームとシームレスに互換性のあるカスタムステッカーを発表
OpenAIはChatGPT向けに新しいカスタムスタック機能正式に導入し、大衆的なソーシャルコンテンツ作成におけるAIの限界を押し広げている。ユーザーは、写真のアップロード、テキストプロンプトの使用、またはさまざまな視覚芸術スタイルの適用など、直感的な方法を通じてパーソナライズされたスタックを作成できる。この機能は、知的な画像のトリミングと修復を活用し、クリーンで透明な背景を持つスタックを自動的に生成し、複数のデザインをまとめて完全なカスタムスタックパックにまとめることができる。この機能はシ
 Anthropic、Claude Opus 5.2 および内部モデル 2 の静かなグレースケールテストを開始
Anthropicの最新フラッグシップモデル、Opus 5.2は、今朝Claude Code内の早期テストフェーズに静かに導入された。開発者たちは、API呼び出しとWebインターフェースの間で顕著なパフォーマンスの相違を指摘している。パケット分析により、バックエンドのモデル識別子がすでにOpus 5.2に切り替えられていることが判明し、この未発表のイテレーションが実際の開発者のワークフローを積極的に支えていることが示唆されている。さらなる驚きとして、Anthropicからの内部リスクアセスメン

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












