


 首页
研究:OpenAI模型记忆的受版权保护内容
一项最新研究表明,OpenAI可能确实使用了受版权保护的材料来训练其部分AI模型,为公司面临的持续法律争议增添了依据。作者、程序员和其他内容创作者指控OpenAI未经许可使用他们的作品——如书籍和代码——来开发其AI模型。虽然OpenAI以合理使用为由进行辩护,但原告认为美国版权法并未为训练数据提供例外条款。
这项研究由华盛顿大学、哥本哈根大学和斯坦福大学的研究人员合作开展,介绍了一种新技术,用于检测通过API访问的模型(如OpenAI的模型)中“记忆”的训练数据。AI模型通过从海量数据中学习来识别模式,从而能够生成文章、图像等。虽然大多数输出并非训练数据的直接复制,但由于学习过程,某些输出不可避免地是复制品。例如,图像模型已知会重现电影截图,而语言模型则被发现几乎是在抄袭新闻文章。
研究中描述的方法聚焦于“高意外性”词汇——在特定语境中不常见的词汇。例如,在句子“Jack和我一动不动地坐着,雷达发出嗡嗡声”中,“雷达”是高意外性词汇,因为相比“引擎”或“收音机”等词汇,它出现在“嗡嗡声”前更不常见。
研究人员测试了多个OpenAI模型,包括GPT-4和GPT-3.5,通过从小说书籍片段和《纽约时报》文章中移除高意外性词汇,并要求模型预测这些缺失的词汇。如果模型能够准确猜测这些词汇,则表明它们在训练过程中记忆了这些文本。
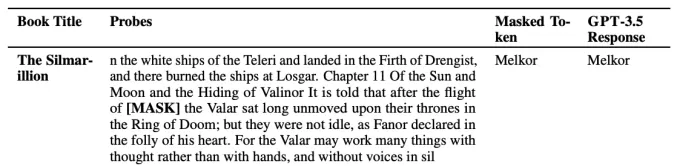
一个让模型“猜测”高意外性词汇的示例。图片来源:OpenAI 结果显示,GPT-4很可能记忆了流行小说书籍的部分内容,包括BookMIA数据集中的受版权保护的电子书。它似乎也记忆了一些《纽约时报》的文章,尽管频率较低。华盛顿大学博士生、研究合著者Abhilasha Ravichander向TechCrunch强调,这些发现突显了训练这些模型可能使用的“有争议数据”。“为了拥有值得信赖的大型语言模型,我们需要能够对其进行探测、审计和科学检查的模型,”Ravichander表示。“我们的工作旨在提供一种探测大型语言模型的工具,但整个生态系统迫切需要更高的数据透明度。”
OpenAI一直推动放宽使用受版权保护数据开发AI模型的规则。尽管该公司与一些内容许可协议达成合作,并为版权持有者提供了退出选项,但它也在向各国政府游说,试图为AI训练建立专门的“合理使用”规则。
相关文章
 山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未
OpenAI 与苹果公司就商业秘密诉讼进行对抗
OpenAI 于周二驳回了苹果公司的商业秘密指控,称该诉讼毫无根据。“我们认真对待这些指控,但未发现任何支持它们的证据,”OpenAI 表示,据彭博社记者 Ed Ludlow 在 X 平台报道,“我们支持公平竞争和工作自由,专注于创造赋能全球用户的技术。”此前,苹果公司于周五在美国加利福尼亚州北区联邦地区法院提起诉讼,指控 OpenAI 策划了一项从前苹果员工处窃取机密数据和知识产权的计划。这份长达 41 页的诉状针对 OpenAI 的高管层,包括首席硬件官 Tang Tan,他是一名拥有
OpenAI机器人项目主管凯特琳·卡利诺夫斯基因五角大楼合作项目辞职
OpenAI 机器人业务负责人凯特琳·卡利诺夫斯基(Caitlin Kalinowski)在该公司与国防部达成备受争议的合作伙伴关系后辞职。“这不是一个轻松的决定,”卡利诺夫斯基在社交媒体声明中解释道。“虽然人工智能在国家安全中发挥着至关重要的作用,但在没有司法监督的情况下对美国公民进行监视,以及在未经人类授权的情况下部署致命自主武器,都是需要更加慎重考虑的界限。”卡利诺夫斯基此前因领导 Meta 的增强现实眼镜部门而闻名,她于 2024 年 11 月加入 OpenAI。在辞职信中,她强调她
相关专题推荐
教育与学习
 用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
 10 个工具
 xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai
提示词
适用于 ChatGPT 工作流的最佳 AI 提示词库
2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
教育与学习
面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai

 评论 (34)
0/500
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
一项最新研究表明,OpenAI可能确实使用了受版权保护的材料来训练其部分AI模型,为公司面临的持续法律争议增添了依据。作者、程序员和其他内容创作者指控OpenAI未经许可使用他们的作品——如书籍和代码——来开发其AI模型。虽然OpenAI以合理使用为由进行辩护,但原告认为美国版权法并未为训练数据提供例外条款。
这项研究由华盛顿大学、哥本哈根大学和斯坦福大学的研究人员合作开展,介绍了一种新技术,用于检测通过API访问的模型(如OpenAI的模型)中“记忆”的训练数据。AI模型通过从海量数据中学习来识别模式,从而能够生成文章、图像等。虽然大多数输出并非训练数据的直接复制,但由于学习过程,某些输出不可避免地是复制品。例如,图像模型已知会重现电影截图,而语言模型则被发现几乎是在抄袭新闻文章。
研究中描述的方法聚焦于“高意外性”词汇——在特定语境中不常见的词汇。例如,在句子“Jack和我一动不动地坐着,雷达发出嗡嗡声”中,“雷达”是高意外性词汇,因为相比“引擎”或“收音机”等词汇,它出现在“嗡嗡声”前更不常见。
研究人员测试了多个OpenAI模型,包括GPT-4和GPT-3.5,通过从小说书籍片段和《纽约时报》文章中移除高意外性词汇,并要求模型预测这些缺失的词汇。如果模型能够准确猜测这些词汇,则表明它们在训练过程中记忆了这些文本。
华盛顿大学博士生、研究合著者Abhilasha Ravichander向TechCrunch强调,这些发现突显了训练这些模型可能使用的“有争议数据”。“为了拥有值得信赖的大型语言模型,我们需要能够对其进行探测、审计和科学检查的模型,”Ravichander表示。“我们的工作旨在提供一种探测大型语言模型的工具,但整个生态系统迫切需要更高的数据透明度。”
OpenAI一直推动放宽使用受版权保护数据开发AI模型的规则。尽管该公司与一些内容许可协议达成合作,并为版权持有者提供了退出选项,但它也在向各国政府游说,试图为AI训练建立专门的“合理使用”规则。








 山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未
 OpenAI 与苹果公司就商业秘密诉讼进行对抗
OpenAI 于周二驳回了苹果公司的商业秘密指控,称该诉讼毫无根据。“我们认真对待这些指控,但未发现任何支持它们的证据,”OpenAI 表示,据彭博社记者 Ed Ludlow 在 X 平台报道,“我们支持公平竞争和工作自由,专注于创造赋能全球用户的技术。”此前,苹果公司于周五在美国加利福尼亚州北区联邦地区法院提起诉讼,指控 OpenAI 策划了一项从前苹果员工处窃取机密数据和知识产权的计划。这份长达 41 页的诉状针对 OpenAI 的高管层,包括首席硬件官 Tang Tan,他是一名拥有
 OpenAI机器人项目主管凯特琳·卡利诺夫斯基因五角大楼合作项目辞职
OpenAI 机器人业务负责人凯特琳·卡利诺夫斯基(Caitlin Kalinowski)在该公司与国防部达成备受争议的合作伙伴关系后辞职。“这不是一个轻松的决定,”卡利诺夫斯基在社交媒体声明中解释道。“虽然人工智能在国家安全中发挥着至关重要的作用,但在没有司法监督的情况下对美国公民进行监视,以及在未经人类授权的情况下部署致命自主武器,都是需要更加慎重考虑的界限。”卡利诺夫斯基此前因领导 Meta 的增强现实眼镜部门而闻名,她于 2024 年 11 月加入 OpenAI。在辞职信中,她强调她

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












