


 Lar
Estudo: Modelos OpenAI memorizou conteúdo protegido por direitos autorais
Um estudo recente sugere que a OpenAI pode ter de fato usado material protegido por direitos autorais para treinar alguns de seus modelos de IA, adicionando combustível às batalhas legais em curso que a empresa enfrenta. Autores, programadores e outros criadores de conteúdo acusaram a OpenAI de usar suas obras — como livros e códigos — sem permissão para desenvolver seus modelos de IA. Embora a OpenAI tenha se defendido alegando uso justo, os demandantes argumentam que a lei de direitos autorais dos EUA não prevê uma exceção para dados de treinamento.
O estudo, uma colaboração entre pesquisadores da Universidade de Washington, da Universidade de Copenhague e de Stanford, apresenta uma nova técnica para detectar dados de treinamento “memorizados” em modelos acessados por meio de uma API, como os da OpenAI. Modelos de IA essencialmente aprendem a partir de vastas quantidades de dados para reconhecer padrões, permitindo-lhes criar ensaios, imagens e muito mais. Embora a maioria dos resultados não sejam cópias diretas dos dados de treinamento, alguns inevitavelmente o são devido ao processo de aprendizado. Por exemplo, modelos de imagem já foram conhecidos por reproduzir capturas de tela de filmes, enquanto modelos de linguagem foram pegos essencialmente plagiando artigos de notícias.
O método descrito no estudo foca em palavras de “alta surpresa” — palavras que são incomuns em um determinado contexto. Por exemplo, na frase “Jack e eu sentamos perfeitamente imóveis com o radar zumbindo”, “radar” seria uma palavra de alta surpresa porque é menos esperado do que palavras como “motor” ou “rádio” para preceder “zumbindo”.
Os pesquisadores testaram vários modelos da OpenAI, incluindo GPT-4 e GPT-3.5, removendo palavras de alta surpresa de trechos de livros de ficção e artigos do New York Times e pedindo aos modelos que previssem essas palavras ausentes. Se os modelos adivinhassem as palavras com precisão, isso sugeria que eles haviam memorizado o texto durante o treinamento.
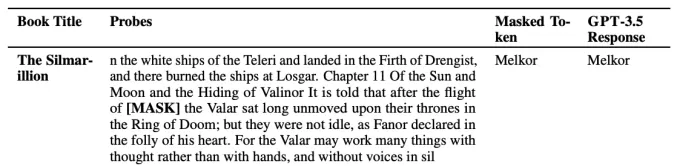
Um exemplo de um modelo “adivinhando” uma palavra de alta surpresa. Créditos da imagem: OpenAI Os resultados indicaram que o GPT-4 provavelmente memorizou partes de livros de ficção populares, incluindo aqueles no conjunto de dados BookMIA de ebooks protegidos por direitos autorais. Também pareceu ter memorizado alguns artigos do New York Times, embora com uma frequência menor.Abhilasha Ravichander, estudante de doutorado na Universidade de Washington e coautora do estudo, enfatizou ao TechCrunch que essas descobertas destacam os “dados controversos” que podem ter sido usados para treinar esses modelos. “Para termos modelos de linguagem de grande escala que sejam confiáveis, precisamos de modelos que possamos sondar, auditar e examinar cientificamente”, afirmou Ravichander. “Nosso trabalho visa fornecer uma ferramenta para sondar modelos de linguagem de grande escala, mas há uma necessidade real de maior transparência de dados em todo o ecossistema.”
A OpenAI tem pressionado por regras mais flexíveis sobre o uso de dados protegidos por direitos autorais para desenvolver modelos de IA. Embora a empresa tenha alguns acordos de licenciamento de conteúdo e ofereça opções de exclusão para detentores de direitos autorais, ela tem feito lobby em vários governos para estabelecer regras de “uso justo” especificamente para treinamento de IA.
Artigo relacionado
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
A cabeça de robótica da OpenAI, Caitlin Kalinowski, renuncia devido à parceria com o Pentágono
O líder de robótica da OpenAI, Caitlin Kalinowski, renunciou após a polêmica parceria da empresa com o Departamento de Defesa.“Esta não foi uma decisão fácil”, explicou Kalinowski em uma declaração nas redes sociais. “Embora a IA desempenhe um papel
Recomendações de tópicos especiais relacionados
Negócios
 As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
 9 ferramentas
 xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai
Educação e Aprendizagem
Plataformas de Construção de Questionários de IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes
2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai
código
Ferramentas de revisão de pull requests com IA para equipes do GitHub que lidam com refatorações, bugs e falhas de segurança
As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai
Conversão de texto para fala
As melhores ferramentas de conversão de texto em fala com IA para narrações com voz natural
As melhores e mais bem avaliadas ferramentas de conversão de texto em fala com IA de 2026 para dublagens naturais estão aqui no XIX.AI! Esta lista selecionada apresenta opções poderosas e revolucionárias que oferecem vozes cristalinas para todos os tipos de uso, respaldadas por testes reais e rankings atualizados semanalmente. Veja uma comparação entre versões gratuitas e pagas para encontrar a solução imperdível que aumentará sua produtividade instantaneamente. Explore agora para aproveitar toda a vantagem da IA!
11 ferramentas
xix.ai

 Comentários (34)
![DouglasScott]()
So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
![JackAllen]()
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
![WilliamGonzalez]()
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
![GregoryBaker]()
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
![JohnGarcia]()
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
![TimothyMitchell]()
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔
Um estudo recente sugere que a OpenAI pode ter de fato usado material protegido por direitos autorais para treinar alguns de seus modelos de IA, adicionando combustível às batalhas legais em curso que a empresa enfrenta. Autores, programadores e outros criadores de conteúdo acusaram a OpenAI de usar suas obras — como livros e códigos — sem permissão para desenvolver seus modelos de IA. Embora a OpenAI tenha se defendido alegando uso justo, os demandantes argumentam que a lei de direitos autorais dos EUA não prevê uma exceção para dados de treinamento.
O estudo, uma colaboração entre pesquisadores da Universidade de Washington, da Universidade de Copenhague e de Stanford, apresenta uma nova técnica para detectar dados de treinamento “memorizados” em modelos acessados por meio de uma API, como os da OpenAI. Modelos de IA essencialmente aprendem a partir de vastas quantidades de dados para reconhecer padrões, permitindo-lhes criar ensaios, imagens e muito mais. Embora a maioria dos resultados não sejam cópias diretas dos dados de treinamento, alguns inevitavelmente o são devido ao processo de aprendizado. Por exemplo, modelos de imagem já foram conhecidos por reproduzir capturas de tela de filmes, enquanto modelos de linguagem foram pegos essencialmente plagiando artigos de notícias.
O método descrito no estudo foca em palavras de “alta surpresa” — palavras que são incomuns em um determinado contexto. Por exemplo, na frase “Jack e eu sentamos perfeitamente imóveis com o radar zumbindo”, “radar” seria uma palavra de alta surpresa porque é menos esperado do que palavras como “motor” ou “rádio” para preceder “zumbindo”.
Os pesquisadores testaram vários modelos da OpenAI, incluindo GPT-4 e GPT-3.5, removendo palavras de alta surpresa de trechos de livros de ficção e artigos do New York Times e pedindo aos modelos que previssem essas palavras ausentes. Se os modelos adivinhassem as palavras com precisão, isso sugeria que eles haviam memorizado o texto durante o treinamento.
Abhilasha Ravichander, estudante de doutorado na Universidade de Washington e coautora do estudo, enfatizou ao TechCrunch que essas descobertas destacam os “dados controversos” que podem ter sido usados para treinar esses modelos. “Para termos modelos de linguagem de grande escala que sejam confiáveis, precisamos de modelos que possamos sondar, auditar e examinar cientificamente”, afirmou Ravichander. “Nosso trabalho visa fornecer uma ferramenta para sondar modelos de linguagem de grande escala, mas há uma necessidade real de maior transparência de dados em todo o ecossistema.”
A OpenAI tem pressionado por regras mais flexíveis sobre o uso de dados protegidos por direitos autorais para desenvolver modelos de IA. Embora a empresa tenha alguns acordos de licenciamento de conteúdo e ofereça opções de exclusão para detentores de direitos autorais, ela tem feito lobby em vários governos para estabelecer regras de “uso justo” especificamente para treinamento de IA.








 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A OpenAI process a Apple por violação de segredo comercial
A OpenAI refutou as alegações de segredo comercial da Apple na terça-feira, argumentando que a ação judicial é infundada.“Levamos essas alegações a sério, mas não vemos evidências que as apoiem”, afirmou a OpenAI, conforme relatado por Ed Ludlow, da
 A cabeça de robótica da OpenAI, Caitlin Kalinowski, renuncia devido à parceria com o Pentágono
O líder de robótica da OpenAI, Caitlin Kalinowski, renunciou após a polêmica parceria da empresa com o Departamento de Defesa.“Esta não foi uma decisão fácil”, explicou Kalinowski em uma declaração nas redes sociais. “Embora a IA desempenhe um papel

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de conversão de texto em fala com IA de 2026 para dublagens naturais estão aqui no XIX.AI! Esta lista selecionada apresenta opções poderosas e revolucionárias que oferecem vozes cristalinas para todos os tipos de uso, respaldadas por testes reais e rankings atualizados semanalmente. Veja uma comparação entre versões gratuitas e pagas para encontrar a solução imperdível que aumentará sua produtividade instantaneamente. Explore agora para aproveitar toda a vantagem da IA!
11 ferramentas
xix.ai

So OpenAI basically trained on copyrighted books and code without permission? Shocking absolutely no one. 😅 The real question is whether courts will actually make them pay damages or just slap a 'please don't do that again' fine. Either way, creators deserve better than being data fodder for billion-dollar models.
这篇文章提到的版权问题确实让人担忧,以后AI生成的内容会不会都带着'侵权'的标签?想想就觉得挺讽刺的,毕竟这些模型训练数据不透明,普通用户根本不知道输出里夹带了什么'私货'。希望有更严格的管理办法吧。
This is wild! OpenAI might’ve gobbled up copyrighted stuff to train their models? I’m not shocked, but it’s kinda shady. Hope those authors and coders get some justice! 😤
This is wild! OpenAI might've trained their models on copyrighted stuff? 😳 I wonder how many books and code snippets got swept up in that data vacuum. Ethics in AI is such a messy topic right now.
Me sorprendió un poco que OpenAI podría haber usado material con derechos de autor para entrenar sus modelos. Es un poco decepcionante, pero supongo que es el salvaje oeste allá en el mundo de la IA. 🤔 ¿Quizás deberían ser más cuidadosos la próxima vez?
OpenAIが著作権付きの資料を使ってAIを訓練しているという研究は本当に驚きですね!クリエイターにとっては残念ですが、AIの訓練方法について知るのは面白いです。もっと透明性が必要かもしれませんね?🤔












