

 首页
微软高管称AI数据抓取是“历史上最大的劳动盗窃”,未经删减的文件显示
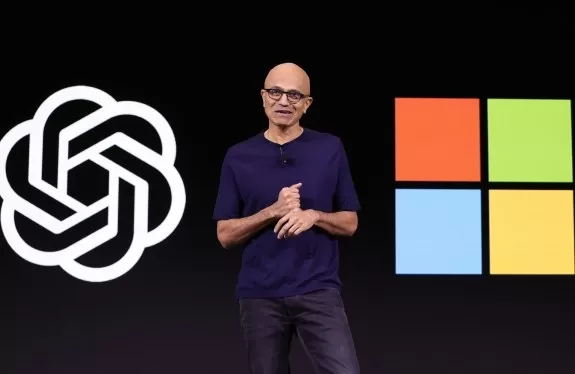
纽约时报针对OpenAI和微软提起的为期三年的版权诉讼中解密的文件显示,一家公司承认AI抓取构成盗窃,并对媒体机构构成严重威胁。
根据诉讼文件,微软的一位高管私下将公司的AI训练方法称为“盗窃”,而OpenAI的领导层承认,其模型对训练它们的出版商和记者构成了“生存威胁”。
新解密的记录还详细说明了这些公司如何绕过付费墙而不被察觉地访问和利用这些内容,通过大规模抓取构建训练数据集,并故意从数据中删除版权声明。
需要注意的是,这些新信息大多来自《纽约时报》自身的法律简报,而非仍处于保密状态的原始证据。以下引用的内容未提供原始语境。
这份未经删节的文件标志着这场三年诉讼的最新升级,纽约时报最初声称这些公司通过利用其内容训练生成式AI模型违反了版权法。
关于AI公司是否可以合法使用受版权保护的材料进行训练,目前尚无明确的法律答案,尽管法官们通常倾向于支持AI公司的观点,即此类训练属于“合理使用”。这一法律原则允许在特定情况下未经许可使用受版权保护的作品,例如讽刺、新闻报道或评论。本月早些时候,特朗普政府提交了一份简报,支持OpenAI未经授权使用受版权保护的材料来训练其大型语言模型。
然而,这些新承认中的几项与OpenAI的合理使用抗辩相矛盾,特别是要求这种使用不替代或损害原作品的市场。
例如,微软自己的数据显示,其Copilot“答案引擎”导致《纽约时报》域名的点击率与传统必应搜索相比下降了高达93%。微软应用科学总监布伦特·赫克于2024年1月撰写的一份内部微软演示文稿将这种下降描述为“死亡循环”,这将同时“损害我们模型的性能和整个网络”。
“一个最终产品威胁其基本供应商的经济基础是非常不寻常的,但这就是我们为LLM业务在其‘内容供应链’方面创造的情况,”微软文件在文件中引用道。
微软首席执行官萨提亚·纳德拉今年早些时候在证词中也表示,“任何受付费墙保护的内容,任何希望使用它的人……都应获得授权,用于基础或训练”,并澄清如果他“得知OpenAI抓取并训练了受付费墙保护的信息”,他将“援引[微软的权利]要求OpenAI重新训练其模型”。
其他承认削弱了合理使用测试的不同方面:OpenAI ChatGPT负责人尼克·特利在内部通信中写道,出版商面临来自聊天机器人等产品的“生存威胁”,这些产品“在很大程度上是可替代的”,并且“随着它们变得更好,将变得越来越可替代”。
OpenAI总裁格雷格·布罗克曼将模型描述为“擅长新闻”。纳德拉今年早些时候在宣誓作证时同意,与聊天机器人互动“已经替代了……直接在AI平台上的网站上提供信息,而不是需要去底层来源”。
此类语言突显了该技术如何直接与原作品竞争,而不是对其进行改造。
微软的一份文件指出,生成式AI“有可能严重扰乱那些为基础模型训练生成数据的人的就业”的“现实风险”。
复制的规模令人震惊。文件首次显示,OpenAI的中期训练数据集中仅包含来自《纽约时报》、《每日新闻》和调查报道中心的91,692多部作品的副本。一个源自Common Crawl的数据集仅包含来自nytimes.com的200多万份文档。
在2023年1月的一份内部备忘录中,赫克称其为“前所未有的惊人盗窃”和“人类历史上最大的劳动盗窃”。
该文件提供了OpenAI和微软如何获取原告内容的细节,包括从必应索引中抓取内容。
“OpenAI将整个GPT-3训练数据集交付给微软,微软利用该数据集评估如何在自己的商业产品中实施OpenAI的模型,”文件指出。“微软还通过名为Project Taxi和Project Mango的计划向OpenAI提供了类似的数据。”
据称,这些公司将Project Mango数据组装成一个训练数据集,其中包含来自新闻出版商至少160,903部独特作品的副本。
为了最大化抓取的有效性,OpenAI员工据称制定了一项计划,以在不被察觉的情况下规避付费墙。文件显示,当OpenAI研究员尼克·莱德向布罗克曼告知“绕过nytimes付费墙的破解方法”时,布罗克曼回复道:“啊,不错。”
据称,OpenAI员工还构建了像WebText和WebText2这样的训练数据集,这些数据集不成比例地依赖于抓取的新闻内容。他们还据称从Common Crawl(一个免费的网络抓取数据开放存储库)中提取了数百万篇文章。调查结果还描述了在数据到达模型之前故意从训练数据中删除版权声明的努力,因为研究人员“不希望模型向用户输出”“版权声明”。
OpenAI和微软未回复置评请求。
相关文章
 随着Sol和Luna的加入,OpenAI GPT-6在各项基准测试中将令牌成本削减了一半
据Artificial Analysis报道,GPT-6 Sol(最高配置)在智能排名中位居榜首,售价为48美元。图片来源:Getty Images在OpenAI发布GPT-6 Sol和Luna之后,解决方案工程主管马特·韦弗(Matt Weaver)向《AI Magazine》解释了这些新模型如何为企业提供更强的运营灵活性。OpenAI 近期推出了 GPT-6 Astra,并将其描述为“全球最智
AI坟场:一份不断更新的失败项目与初创公司清单
Relay 是一家定位为 Zapier 替代方案的人工智能驱动工作流自动化平台,已于周一停止运营。该服务曾允许用户通过人工智能代理实现电子邮件和任务工作流的自动化,但随着 OpenAI、谷歌等主要平台将类似的自动化功能直接整合到其生态系统中,这家成立五年的 Relay 难以证明其作为独立产品的存在价值。Relay这家被大型平台超越的初创公司,反映了当前行业格局的一个侧面。然而,许多人工智能项目甚至
OpenAI 押注家庭,ChatGPT 深入千家万户
ChatGPT 将生成式 AI 推向聚光灯下已逾三年,OpenAI 正将其业务范围从个人用户扩展至整个家庭。OpenAI 正在旧金山招聘一名产品经理,以开发其平台上的家庭导向体验,目标受众包括父母、照护者和老年人。根据职位列表,该职位要求具备为家庭及其他对信任敏感的消费者应用开发产品的背景。此次招聘与 ChatGPT 不断演变的用户群体相契合,其用户年龄已超出最初的年轻群体。Sensor Tower 独家向 TechCrunch 分享的数据显示,全球范围内,35 岁及以上用户在 Q2 占 Cha
相关专题推荐
金融
 Excel AI 预算预测工具,用于现金流规划和费用控制
2026 年最新最佳 Excel AI 工具,用于现金流规划和费用控制,现已收录于 XIX.AI 的顶级精选榜单。这些强大的变革性解决方案通过实际测试和严格排名,帮助您显著提升生产力。获取免费与付费版的对比,找到最适合您需求的产品。立即探索,解锁您在财务管理中的 AI 优势。
 9 个工具
 xix.ai
提示词
团队使用的AI提示词管理工具
2026 年最新最佳顶级评分 AI 提示词管理工具由 XIX.AI 精心策划,专为团队打造。本指南每周更新,收录了经实际测试和详细排名验证的、能显著提升团队生产力的强大变革性解决方案。获取免费与付费版的对比,助您选择最合适的工具。立即探索,解锁您的 AI 优势。
9 个工具
xix.ai
音乐创作
用于音乐创作的AI歌词创意工具
2026年最新、最受欢迎、评价最高的AI歌词创意工具现已登陆XIX.AI!这份精心精选的合集汇集了多款功能强大、颠覆性的工具,它们均经过实际测试,能够快速提供高质量的歌词创意,帮助用户激发创造力并优化音乐创作流程。 您还可以获取免费版与付费版的对比概览。立即探索,发现最适合您的工具!
16 个工具
xix.ai
漫画创作
用于漫画世界构建的AI角色设定表工具
2026 年最新最佳顶级评分 AI 角色表工具,助力漫画世界构建,现已登陆 XIX.AI!本精选列表收录了经过严格现实测试的强大且具颠覆性的选项。您将看到免费与付费版本的对比,以及每周更新的排行榜,助您发掘那些能激发创意并简化世界构建任务的必备工具。立即探索,解锁您的 AI 优势!
13 个工具
xix.ai
自动化
n8n 人工智能自动化工具,适用于内部运维、数据同步和多步骤代理流程
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
11 个工具
xix.ai
提示词
适合多模型团队的最佳提示词管理工具
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

 评论 (0)
0/500
纽约时报针对OpenAI和微软提起的为期三年的版权诉讼中解密的文件显示,一家公司承认AI抓取构成盗窃,并对媒体机构构成严重威胁。
根据诉讼文件,微软的一位高管私下将公司的AI训练方法称为“盗窃”,而OpenAI的领导层承认,其模型对训练它们的出版商和记者构成了“生存威胁”。
新解密的记录还详细说明了这些公司如何绕过付费墙而不被察觉地访问和利用这些内容,通过大规模抓取构建训练数据集,并故意从数据中删除版权声明。
需要注意的是,这些新信息大多来自《纽约时报》自身的法律简报,而非仍处于保密状态的原始证据。以下引用的内容未提供原始语境。
这份未经删节的文件标志着这场三年诉讼的最新升级,纽约时报最初声称这些公司通过利用其内容训练生成式AI模型违反了版权法。
关于AI公司是否可以合法使用受版权保护的材料进行训练,目前尚无明确的法律答案,尽管法官们通常倾向于支持AI公司的观点,即此类训练属于“合理使用”。这一法律原则允许在特定情况下未经许可使用受版权保护的作品,例如讽刺、新闻报道或评论。本月早些时候,特朗普政府提交了一份简报,支持OpenAI未经授权使用受版权保护的材料来训练其大型语言模型。
然而,这些新承认中的几项与OpenAI的合理使用抗辩相矛盾,特别是要求这种使用不替代或损害原作品的市场。
例如,微软自己的数据显示,其Copilot“答案引擎”导致《纽约时报》域名的点击率与传统必应搜索相比下降了高达93%。微软应用科学总监布伦特·赫克于2024年1月撰写的一份内部微软演示文稿将这种下降描述为“死亡循环”,这将同时“损害我们模型的性能和整个网络”。
“一个最终产品威胁其基本供应商的经济基础是非常不寻常的,但这就是我们为LLM业务在其‘内容供应链’方面创造的情况,”微软文件在文件中引用道。
微软首席执行官萨提亚·纳德拉今年早些时候在证词中也表示,“任何受付费墙保护的内容,任何希望使用它的人……都应获得授权,用于基础或训练”,并澄清如果他“得知OpenAI抓取并训练了受付费墙保护的信息”,他将“援引[微软的权利]要求OpenAI重新训练其模型”。
其他承认削弱了合理使用测试的不同方面:OpenAI ChatGPT负责人尼克·特利在内部通信中写道,出版商面临来自聊天机器人等产品的“生存威胁”,这些产品“在很大程度上是可替代的”,并且“随着它们变得更好,将变得越来越可替代”。
OpenAI总裁格雷格·布罗克曼将模型描述为“擅长新闻”。纳德拉今年早些时候在宣誓作证时同意,与聊天机器人互动“已经替代了……直接在AI平台上的网站上提供信息,而不是需要去底层来源”。
此类语言突显了该技术如何直接与原作品竞争,而不是对其进行改造。
微软的一份文件指出,生成式AI“有可能严重扰乱那些为基础模型训练生成数据的人的就业”的“现实风险”。
复制的规模令人震惊。文件首次显示,OpenAI的中期训练数据集中仅包含来自《纽约时报》、《每日新闻》和调查报道中心的91,692多部作品的副本。一个源自Common Crawl的数据集仅包含来自nytimes.com的200多万份文档。
在2023年1月的一份内部备忘录中,赫克称其为“前所未有的惊人盗窃”和“人类历史上最大的劳动盗窃”。
该文件提供了OpenAI和微软如何获取原告内容的细节,包括从必应索引中抓取内容。
“OpenAI将整个GPT-3训练数据集交付给微软,微软利用该数据集评估如何在自己的商业产品中实施OpenAI的模型,”文件指出。“微软还通过名为Project Taxi和Project Mango的计划向OpenAI提供了类似的数据。”
据称,这些公司将Project Mango数据组装成一个训练数据集,其中包含来自新闻出版商至少160,903部独特作品的副本。
为了最大化抓取的有效性,OpenAI员工据称制定了一项计划,以在不被察觉的情况下规避付费墙。文件显示,当OpenAI研究员尼克·莱德向布罗克曼告知“绕过nytimes付费墙的破解方法”时,布罗克曼回复道:“啊,不错。”
据称,OpenAI员工还构建了像WebText和WebText2这样的训练数据集,这些数据集不成比例地依赖于抓取的新闻内容。他们还据称从Common Crawl(一个免费的网络抓取数据开放存储库)中提取了数百万篇文章。调查结果还描述了在数据到达模型之前故意从训练数据中删除版权声明的努力,因为研究人员“不希望模型向用户输出”“版权声明”。
OpenAI和微软未回复置评请求。


 随着Sol和Luna的加入,OpenAI GPT-6在各项基准测试中将令牌成本削减了一半
据Artificial Analysis报道,GPT-6 Sol(最高配置)在智能排名中位居榜首,售价为48美元。图片来源:Getty Images在OpenAI发布GPT-6 Sol和Luna之后,解决方案工程主管马特·韦弗(Matt Weaver)向《AI Magazine》解释了这些新模型如何为企业提供更强的运营灵活性。OpenAI 近期推出了 GPT-6 Astra,并将其描述为“全球最智
 AI坟场:一份不断更新的失败项目与初创公司清单
Relay 是一家定位为 Zapier 替代方案的人工智能驱动工作流自动化平台,已于周一停止运营。该服务曾允许用户通过人工智能代理实现电子邮件和任务工作流的自动化,但随着 OpenAI、谷歌等主要平台将类似的自动化功能直接整合到其生态系统中,这家成立五年的 Relay 难以证明其作为独立产品的存在价值。Relay这家被大型平台超越的初创公司,反映了当前行业格局的一个侧面。然而,许多人工智能项目甚至
 OpenAI 押注家庭,ChatGPT 深入千家万户
ChatGPT 将生成式 AI 推向聚光灯下已逾三年,OpenAI 正将其业务范围从个人用户扩展至整个家庭。OpenAI 正在旧金山招聘一名产品经理,以开发其平台上的家庭导向体验,目标受众包括父母、照护者和老年人。根据职位列表,该职位要求具备为家庭及其他对信任敏感的消费者应用开发产品的背景。此次招聘与 ChatGPT 不断演变的用户群体相契合,其用户年龄已超出最初的年轻群体。Sensor Tower 独家向 TechCrunch 分享的数据显示,全球范围内,35 岁及以上用户在 Q2 占 Cha
2026 年最新最佳 Excel AI 工具,用于现金流规划和费用控制,现已收录于 XIX.AI 的顶级精选榜单。这些强大的变革性解决方案通过实际测试和严格排名,帮助您显著提升生产力。获取免费与付费版的对比,找到最适合您需求的产品。立即探索,解锁您在财务管理中的 AI 优势。
9 个工具
xix.ai
2026 年最新最佳顶级评分 AI 提示词管理工具由 XIX.AI 精心策划,专为团队打造。本指南每周更新,收录了经实际测试和详细排名验证的、能显著提升团队生产力的强大变革性解决方案。获取免费与付费版的对比,助您选择最合适的工具。立即探索,解锁您的 AI 优势。
9 个工具
xix.ai
2026年最新、最受欢迎、评价最高的AI歌词创意工具现已登陆XIX.AI!这份精心精选的合集汇集了多款功能强大、颠覆性的工具,它们均经过实际测试,能够快速提供高质量的歌词创意,帮助用户激发创造力并优化音乐创作流程。 您还可以获取免费版与付费版的对比概览。立即探索,发现最适合您的工具!
16 个工具
xix.ai
2026 年最新最佳顶级评分 AI 角色表工具,助力漫画世界构建,现已登陆 XIX.AI!本精选列表收录了经过严格现实测试的强大且具颠覆性的选项。您将看到免费与付费版本的对比,以及每周更新的排行榜,助您发掘那些能激发创意并简化世界构建任务的必备工具。立即探索,解锁您的 AI 优势!
13 个工具
xix.ai
2026年最新最佳n8n AI自动化工具——适用于内部运营、数据同步和多步骤代理流程——现已发布!XIX.AI精心甄选了一系列广受好评、功能强大的颠覆性工具,可提升所有工作任务的生产力。 每款工具均经过严格的实际应用测试以确保可靠性,并附有详细的免费版与付费版对比分析及每周更新的排行榜。这些必试选项能助您发挥人工智能优势,轻松优化工作流程。立即探索,发现最适合您的工具!
11 个工具
xix.ai
2026年最新最佳、评分最高的面向多模型团队的提示词管理工具! XIX.AI 精心精选了一系列功能强大、颠覆性的必试工具,提供免费与付费版本对比、实际应用测试及详细排名。这些广受好评的解决方案通过优化工作流程、消除重复劳动并在所有团队项目中激发创造力,能显著提升工作效率。立即探索,发现最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai












