

 家
Microsoftの執行部は、AIによるデータスクレイピングを「歴史上最大の労働の盗難」と呼んでおり、非公開でない提出書類が示している
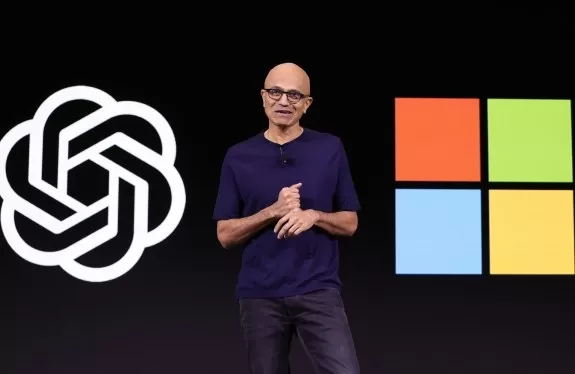
ニューヨーク・タイムズがOpenAIおよびMicrosoftに対して提起した3年前の著作権訴訟から開示された文書は、AIによるスクレイピングが窃盗であり、メディア企業に深刻な脅威をもたらしていることを認める内容を示している。
訴訟によれば、Microsoftの上級経営者は社内のAI学習方法を「窃盗」と私的に呼称し、OpenAIのリーダーシップは、それらのコンテンツで学習したモデルが、出版社やジャーナリストに対して「存続の危機」をもたらしていることを認めた。
新たに開示された記録は、これらの企業がペイウォールを回避して検知されずにコンテンツにアクセスし、大量のスクレイピングを通じて学習データセットを構築し、意図的に著作権表示をデータから削除した方法についても詳述している。
重要な点として、この新情報の多くは、依然として機密保持されている基礎資料ではなく、タイムズ自身の法的主張書から来ていることに留意する必要がある。以下の引用は、元の文脈なしで提示されている。
この無修正の提出書類は、3年前の訴訟における最新のエスカレーションを示すものであり、ニューヨーク・タイムズは当初、生成AIモデルの学習に自社のコンテンツを使用したことで、これらの企業が著作権法に違反したと主張していた。
AI企業が学習のために著作権で保護された素材を合法的に使用できるかどうかについては明確な法的回答がないものの、裁判官たちは一般的に、そのような学習が「フェアユース」に該当するというAI企業の主張を支持してきた。この法的教義は、パロディ、ニュース報道、批評などの特定のケースにおいて、許可なく著作権で保護された作品を使用することを認めるものである。今月初め、トランプ政権は、OpenAIが著作権で保護された素材をライセンスなしで使用するのを支持する意見書を送付した。
しかし、これらの新たな認めるべき事実のいくつかは、OpenAIのフェアユースの主張と矛盾しており、特に、そのような使用が元の作品の市場を代替したり害を与えたりしないという要件がそれに該当する。
例えば、Microsoft自身のデータによると、そのCopilot「回答エンジン」は、従来のBing検索と比較して、ニューヨーク・タイムズのドメインへのクリック率を最大93%低下させたという。2024年1月にMicrosoftの応用科学部長であるBrent Hechtが作成したMicrosoftの内部プレゼンテーションは、この減少を、モデルのパフォーマンスとウェブ全体を同時に「損なう」「破滅のループ」として記述している。
「エンド製品がその不可欠なサプライヤーの経済的基盤を脅かすことは極めて稀であるが、それが私たちがLLM事業において『コンテンツサプライチェーン』に対して作成した状況である」と、Microsoftの文書は提出書類の中で引用されている。
MicrosoftのCEOであるSatya Nadellaも、今年早些に証言で、「ペイウォールで保護されているものは、それを使用したい誰もが、グラウンディングや学習のためにライセンスを取得すべきである」と述べ、もし彼が「OpenAIがペイウォールの背後にある情報をスクレイピングして学習していたことを知らされていれば」、「OpenAIにモデルの再学習を要求する[Microsoftの権利]」を発動しただろうと明確にした。
他の認めるべき事実は、フェアユーステストの異なる側面を弱体化させる:OpenAIのChatGPT責任者であるNick Turleyは、内部通信において、チャットボットのような製品が「本質的に代替可能」であり、「より良くなるにつれてますます代替可能になる」として、出版社が「存続の危機」に直面していると記した。
OpenAIの社長であるGreg Brockmanは、モデルを「ニュースに優れている」と記述した。Nadellaも今年早些に宣誓供述で、チャットボットとの対話は「ウェブサイト上のAIプラットフォームでその情報を直接得ることと代替し、元のソースにアクセスする必要がなくなる」と述べた。
このような言語は、技術が元の作品を変革するのではなく、直接競争しうることを浮き彫りにしている。
Microsoftの文書は、生成AIが「基礎モデルの学習に使用されたデータを生成した人々の雇用を著しく混乱させる」「現実的なリスク」があると述べている。
コピーの規模は顕著である。文書は、OpenAIの中間学習データセットのみで、ニューヨーク・タイムズ、デイリー・ニュース、および調査報道センターによって出版された91,692以上の作品のコピーが含まれていることを初めて明らかにした。Common Crawlから派生したデータセットには、nytimes.comからのみ200万以上の文書が含まれていた。
2023年1月の内部メモにおいて、Hechtはそれを「前例のない規模の驚くべき窃盗」および「人類史上最大の労働の窃盗」と呼んだ。
提出書類は、OpenAIおよびMicrosoftが原告らのコンテンツをBingインデックスからスクレイピングするなどして取得した方法に関する新たな詳細を提供している。
「OpenAIはGPT-3の学習データセット全体をMicrosoftに提供し、Microsoftはそれを自社の商業製品内でOpenAIのモデルを実装する方法を評価するために使用した」と提出書類は述べる。「Microsoftも同様に、Project TaxiおよびProject Mangoと呼ばれるイニシアチブを通じて、OpenAIに学習データを提供した。」
両社は、Project Mangoのデータを、ニュース出版社からの少なくとも160,903の固有な作品のコピーを含む学習データセットに組み立てた alleged されている。
スクレイピングの有効性を最大化するために、OpenAIの従業員は、検知されずにペイウォールを回避する計画を立案した alleged されている。提出書類によると、OpenAIの研究者であるNick RyderがBrockmanに「nytimesのペイウォールを回避するハック」について知らせた際、Brockmanは「ああ、いいね」と返信した。
OpenAIの従業員はまた、WebTextやWebText2のような学習データセットを構築し、それらはスクレイピングされたニュースコンテンツに不均衡に依存していた alleged されている。彼らはまた、ウェブクロールデータの無料かつオープンなリポジトリであるCommon Crawlから数百万の記事を抽出した alleged されている。これらの発見は、研究者が「モデルがユーザーに著作権表示を出力することを望まない」という理由で、データがモデルに到達する前に著作権表示を削除する意図的な努力も記述している。
OpenAIおよびMicrosoftは、コメントの要請に応じなかった。
関連記事
 SolとLunaが参入し、OpenAIのGPT-6が各ベンチマークでトークンコストを半減
Artificial Analysisによると、GPT-6 Sol(max)は知能面でトップモデルにランクインしており、価格は48ドルだ。画像提供:Getty ImagesOpenAIがGPT-6 SolとLunaをリリースした後、ソリューション・エンジニアリング責任者のマット・ウィーバー氏は『AI Magazine』に対し、これらの新モデルが企業にどのように業務上の柔軟性を高めるかを説明した。O
AIの墓場:成功しなかったプロジェクトやスタートアップのリスト(随時更新中)
Zapierの代替として位置づけられていたAI駆動のワークフロー自動化プラットフォーム「Relay」は、月曜日にサービスを終了した。同サービスは、AIエージェントを通じてメールやタスクのワークフローを自動化することを可能にしていたが、OpenAIやGoogleなどの主要プラットフォームが同様の自動化機能を自社のエコシステムに直接組み込むようになったため、設立から5年を経たRelayは、独立した製品
OpenAIは、ChatGPTが家庭に深く浸透する中で、家族を対象とした戦略に賭けている
ChatGPTが生成系AIを注目の的に押し上げてから3年以上が経過し、OpenAIは対象を個人ユーザーから世帯全体へと拡大している。OpenAIは、親、介護者、シニア層を対象に、プラットフォーム全体で家族向けの体験を開発するためのプロダクトマネージャーをサンフランシスコで募集している。求人票によると、この職位には、家族向けおよび信頼が敏感な消費者向けアプリケーションの製品作成に関する背景経験が求められている。この募集は、ChatGPTのユーザー層が当初の若年層を超えて高齢化していることと一致する
関連特集おすすめ
ファイナンス
 現金フロー計画と費用管理のためのExcel AI予算予測ツール
2026年最新のExcel用AIツールのベストコレクションが、XIX.AIの高評価キュレーションリストに掲載されています。これらの強力なゲームチェンジャーソリューションは、実際のテストと厳格なランキングを通じて、生産性を大幅に向上させるのを支援します。無料版と有料版の比較を確認し、あなたのニーズに最適なツールを見つけてください。今すぐ探索して、財務管理におけるAIの優位性を解き放ちましょう。
 9 ツール
 xix.ai
プロンプト
チーム向けのAIプロンプト管理ツール
2026年最新版のチーム向けベスト・トップ評価AIプロンプト管理ツールは、XIX.AIによって厳選されています。この週刊更新ガイドは、実際のテストと詳細なランキングを通じてチームの生産性を大幅に向上させる強力な革新的ソリューションを特集しています。無料版と有料版の比較を無料で入手し、最適なツールを選べるようサポートします。今すぐ探索して、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai
作曲
作曲のためのAI歌詞生成ツール
2026年最新の、音楽制作に最適な高評価AI歌詞アイデアツールがXIX.AIに登場!この厳選されたコレクションには、実環境でのテストを経て、高品質な歌詞のコンセプトを迅速に提供し、ユーザーの創造性を高め、音楽制作プロセスを効率化する、画期的な強力なツールが揃っています。 無料版と有料版の比較概要もご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
16 ツール
xix.ai
漫画制作
漫画の世界観構築のためのAIキャラクターシートツール
2026年最新のベスト・高評価AIキャラクターシートツールがXIX.AIに登場!コミックの世界構築に最適な厳選リストには、実世界での厳格なテストを経て選出された強力なゲームチェンジャーが含まれています。無料版と有料版の比較や、毎週更新されるランキングも提供されており、創造性を高め、世界構築作業を効率化する必須ツールを見つけることができます。今すぐ探索して、AIによる優位性を解き放ちましょう!
13 ツール
xix.ai
オートメーション
n8nのAI自動化ツール:社内運用、データ同期、および多段階のエージェントフロー向け
2026年版、社内運用、データ同期、多段階エージェントフローに最適な最新のn8n AI自動化ツールが登場!XIX.AIは、あらゆる業務の生産性を飛躍的に向上させる、画期的な高評価ツールを厳選してリストアップしました。 各ツールは信頼性を確保するため、実環境での厳格なテストを経ており、無料版と有料版の詳細な比較や、毎週更新されるランキングも掲載されています。ぜひ試してみたいこれらのツールで、AIの真価を引き出し、ワークフローをスムーズに効率化しましょう。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai
プロンプト
マルチモデルチームに最適なプロンプト管理ツール
2026年版:マルチモデルチーム向け、最新・最高評価のプロンプト管理ツール! XIX.AIは、無料版と有料版の比較、実環境でのテスト、詳細なランキングを掲載した、強力で画期的な「必試ツール」のコレクションを厳選しました。これらの高評価ソリューションは、ワークフローを効率化し、反復作業を排除し、チームのあらゆるプロジェクトにおいて創造性を引き出すことで、生産性を大幅に向上させます。今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

 コメント (0)
0/500
ニューヨーク・タイムズがOpenAIおよびMicrosoftに対して提起した3年前の著作権訴訟から開示された文書は、AIによるスクレイピングが窃盗であり、メディア企業に深刻な脅威をもたらしていることを認める内容を示している。
訴訟によれば、Microsoftの上級経営者は社内のAI学習方法を「窃盗」と私的に呼称し、OpenAIのリーダーシップは、それらのコンテンツで学習したモデルが、出版社やジャーナリストに対して「存続の危機」をもたらしていることを認めた。
新たに開示された記録は、これらの企業がペイウォールを回避して検知されずにコンテンツにアクセスし、大量のスクレイピングを通じて学習データセットを構築し、意図的に著作権表示をデータから削除した方法についても詳述している。
重要な点として、この新情報の多くは、依然として機密保持されている基礎資料ではなく、タイムズ自身の法的主張書から来ていることに留意する必要がある。以下の引用は、元の文脈なしで提示されている。
この無修正の提出書類は、3年前の訴訟における最新のエスカレーションを示すものであり、ニューヨーク・タイムズは当初、生成AIモデルの学習に自社のコンテンツを使用したことで、これらの企業が著作権法に違反したと主張していた。
AI企業が学習のために著作権で保護された素材を合法的に使用できるかどうかについては明確な法的回答がないものの、裁判官たちは一般的に、そのような学習が「フェアユース」に該当するというAI企業の主張を支持してきた。この法的教義は、パロディ、ニュース報道、批評などの特定のケースにおいて、許可なく著作権で保護された作品を使用することを認めるものである。今月初め、トランプ政権は、OpenAIが著作権で保護された素材をライセンスなしで使用するのを支持する意見書を送付した。
しかし、これらの新たな認めるべき事実のいくつかは、OpenAIのフェアユースの主張と矛盾しており、特に、そのような使用が元の作品の市場を代替したり害を与えたりしないという要件がそれに該当する。
例えば、Microsoft自身のデータによると、そのCopilot「回答エンジン」は、従来のBing検索と比較して、ニューヨーク・タイムズのドメインへのクリック率を最大93%低下させたという。2024年1月にMicrosoftの応用科学部長であるBrent Hechtが作成したMicrosoftの内部プレゼンテーションは、この減少を、モデルのパフォーマンスとウェブ全体を同時に「損なう」「破滅のループ」として記述している。
「エンド製品がその不可欠なサプライヤーの経済的基盤を脅かすことは極めて稀であるが、それが私たちがLLM事業において『コンテンツサプライチェーン』に対して作成した状況である」と、Microsoftの文書は提出書類の中で引用されている。
MicrosoftのCEOであるSatya Nadellaも、今年早些に証言で、「ペイウォールで保護されているものは、それを使用したい誰もが、グラウンディングや学習のためにライセンスを取得すべきである」と述べ、もし彼が「OpenAIがペイウォールの背後にある情報をスクレイピングして学習していたことを知らされていれば」、「OpenAIにモデルの再学習を要求する[Microsoftの権利]」を発動しただろうと明確にした。
他の認めるべき事実は、フェアユーステストの異なる側面を弱体化させる:OpenAIのChatGPT責任者であるNick Turleyは、内部通信において、チャットボットのような製品が「本質的に代替可能」であり、「より良くなるにつれてますます代替可能になる」として、出版社が「存続の危機」に直面していると記した。
OpenAIの社長であるGreg Brockmanは、モデルを「ニュースに優れている」と記述した。Nadellaも今年早些に宣誓供述で、チャットボットとの対話は「ウェブサイト上のAIプラットフォームでその情報を直接得ることと代替し、元のソースにアクセスする必要がなくなる」と述べた。
このような言語は、技術が元の作品を変革するのではなく、直接競争しうることを浮き彫りにしている。
Microsoftの文書は、生成AIが「基礎モデルの学習に使用されたデータを生成した人々の雇用を著しく混乱させる」「現実的なリスク」があると述べている。
コピーの規模は顕著である。文書は、OpenAIの中間学習データセットのみで、ニューヨーク・タイムズ、デイリー・ニュース、および調査報道センターによって出版された91,692以上の作品のコピーが含まれていることを初めて明らかにした。Common Crawlから派生したデータセットには、nytimes.comからのみ200万以上の文書が含まれていた。
2023年1月の内部メモにおいて、Hechtはそれを「前例のない規模の驚くべき窃盗」および「人類史上最大の労働の窃盗」と呼んだ。
提出書類は、OpenAIおよびMicrosoftが原告らのコンテンツをBingインデックスからスクレイピングするなどして取得した方法に関する新たな詳細を提供している。
「OpenAIはGPT-3の学習データセット全体をMicrosoftに提供し、Microsoftはそれを自社の商業製品内でOpenAIのモデルを実装する方法を評価するために使用した」と提出書類は述べる。「Microsoftも同様に、Project TaxiおよびProject Mangoと呼ばれるイニシアチブを通じて、OpenAIに学習データを提供した。」
両社は、Project Mangoのデータを、ニュース出版社からの少なくとも160,903の固有な作品のコピーを含む学習データセットに組み立てた alleged されている。
スクレイピングの有効性を最大化するために、OpenAIの従業員は、検知されずにペイウォールを回避する計画を立案した alleged されている。提出書類によると、OpenAIの研究者であるNick RyderがBrockmanに「nytimesのペイウォールを回避するハック」について知らせた際、Brockmanは「ああ、いいね」と返信した。
OpenAIの従業員はまた、WebTextやWebText2のような学習データセットを構築し、それらはスクレイピングされたニュースコンテンツに不均衡に依存していた alleged されている。彼らはまた、ウェブクロールデータの無料かつオープンなリポジトリであるCommon Crawlから数百万の記事を抽出した alleged されている。これらの発見は、研究者が「モデルがユーザーに著作権表示を出力することを望まない」という理由で、データがモデルに到達する前に著作権表示を削除する意図的な努力も記述している。
OpenAIおよびMicrosoftは、コメントの要請に応じなかった。


 SolとLunaが参入し、OpenAIのGPT-6が各ベンチマークでトークンコストを半減
Artificial Analysisによると、GPT-6 Sol(max)は知能面でトップモデルにランクインしており、価格は48ドルだ。画像提供:Getty ImagesOpenAIがGPT-6 SolとLunaをリリースした後、ソリューション・エンジニアリング責任者のマット・ウィーバー氏は『AI Magazine』に対し、これらの新モデルが企業にどのように業務上の柔軟性を高めるかを説明した。O
 AIの墓場:成功しなかったプロジェクトやスタートアップのリスト(随時更新中)
Zapierの代替として位置づけられていたAI駆動のワークフロー自動化プラットフォーム「Relay」は、月曜日にサービスを終了した。同サービスは、AIエージェントを通じてメールやタスクのワークフローを自動化することを可能にしていたが、OpenAIやGoogleなどの主要プラットフォームが同様の自動化機能を自社のエコシステムに直接組み込むようになったため、設立から5年を経たRelayは、独立した製品
 OpenAIは、ChatGPTが家庭に深く浸透する中で、家族を対象とした戦略に賭けている
ChatGPTが生成系AIを注目の的に押し上げてから3年以上が経過し、OpenAIは対象を個人ユーザーから世帯全体へと拡大している。OpenAIは、親、介護者、シニア層を対象に、プラットフォーム全体で家族向けの体験を開発するためのプロダクトマネージャーをサンフランシスコで募集している。求人票によると、この職位には、家族向けおよび信頼が敏感な消費者向けアプリケーションの製品作成に関する背景経験が求められている。この募集は、ChatGPTのユーザー層が当初の若年層を超えて高齢化していることと一致する

2026年最新のExcel用AIツールのベストコレクションが、XIX.AIの高評価キュレーションリストに掲載されています。これらの強力なゲームチェンジャーソリューションは、実際のテストと厳格なランキングを通じて、生産性を大幅に向上させるのを支援します。無料版と有料版の比較を確認し、あなたのニーズに最適なツールを見つけてください。今すぐ探索して、財務管理におけるAIの優位性を解き放ちましょう。
9 ツール
xix.ai

2026年最新版のチーム向けベスト・トップ評価AIプロンプト管理ツールは、XIX.AIによって厳選されています。この週刊更新ガイドは、実際のテストと詳細なランキングを通じてチームの生産性を大幅に向上させる強力な革新的ソリューションを特集しています。無料版と有料版の比較を無料で入手し、最適なツールを選べるようサポートします。今すぐ探索して、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai

2026年最新の、音楽制作に最適な高評価AI歌詞アイデアツールがXIX.AIに登場!この厳選されたコレクションには、実環境でのテストを経て、高品質な歌詞のコンセプトを迅速に提供し、ユーザーの創造性を高め、音楽制作プロセスを効率化する、画期的な強力なツールが揃っています。 無料版と有料版の比較概要もご確認いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
16 ツール
xix.ai
2026年最新のベスト・高評価AIキャラクターシートツールがXIX.AIに登場!コミックの世界構築に最適な厳選リストには、実世界での厳格なテストを経て選出された強力なゲームチェンジャーが含まれています。無料版と有料版の比較や、毎週更新されるランキングも提供されており、創造性を高め、世界構築作業を効率化する必須ツールを見つけることができます。今すぐ探索して、AIによる優位性を解き放ちましょう!
13 ツール
xix.ai
2026年版、社内運用、データ同期、多段階エージェントフローに最適な最新のn8n AI自動化ツールが登場!XIX.AIは、あらゆる業務の生産性を飛躍的に向上させる、画期的な高評価ツールを厳選してリストアップしました。 各ツールは信頼性を確保するため、実環境での厳格なテストを経ており、無料版と有料版の詳細な比較や、毎週更新されるランキングも掲載されています。ぜひ試してみたいこれらのツールで、AIの真価を引き出し、ワークフローをスムーズに効率化しましょう。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
11 ツール
xix.ai
2026年版:マルチモデルチーム向け、最新・最高評価のプロンプト管理ツール! XIX.AIは、無料版と有料版の比較、実環境でのテスト、詳細なランキングを掲載した、強力で画期的な「必試ツール」のコレクションを厳選しました。これらの高評価ソリューションは、ワークフローを効率化し、反復作業を排除し、チームのあらゆるプロジェクトにおいて創造性を引き出すことで、生産性を大幅に向上させます。今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai












