

 首頁
微軟高管稱AI資料抓取是“歷史上最大的勞動盜竊”,未經刪減的檔案顯示
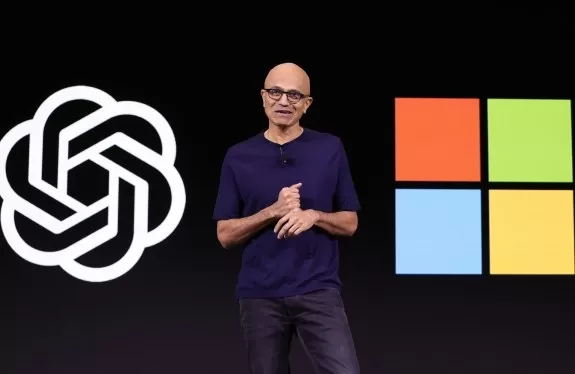
紐約時報針對OpenAI和微軟提起的為期三年的版權訴訟中解密的檔案顯示,一家公司承認AI抓取構成盜竊,並對媒體機構構成嚴重威脅。
根據訴訟檔案,微軟的一位高管私下將公司的AI訓練方法稱為“盜竊”,而OpenAI的領導層承認,其模型對訓練它們的出版商和記者構成了“生存威脅”。
新解密的記錄還詳細說明了這些公司如何繞過付費牆而不被察覺地訪問和利用這些內容,透過大規模抓取構建訓練資料集,並故意從資料中刪除版權宣告。
需要注意的是,這些新資訊大多來自《紐約時報》自身的法律簡報,而非仍處於保密狀態的原始證據。以下引用的內容未提供原始語境。
這份未經刪節的檔案標誌著這場三年訴訟的最新升級,紐約時報最初聲稱這些公司透過利用其內容訓練生成式AI模型違反了版權法。
關於AI公司是否可以合法使用受版權保護的材料進行訓練,目前尚無明確的法律答案,儘管法官們通常傾向於支援AI公司的觀點,即此類訓練屬於“合理使用”。這一法律原則允許在特定情況下未經許可使用受版權保護的作品,例如諷刺、新聞報道或評論。本月早些時候,特朗普政府提交了一份簡報,支援OpenAI未經授權使用受版權保護的材料來訓練其大型語言模型。
然而,這些新承認中的幾項與OpenAI的合理使用抗辯相矛盾,特別是要求這種使用不替代或損害原作品的市場。
例如,微軟自己的資料顯示,其Copilot“答案引擎”導致《紐約時報》域名的點選率與傳統必應搜尋相比下降了高達93%。微軟應用科學總監布倫特·赫克於2024年1月撰寫的一份內部微軟簡報將這種下降描述為“死亡迴圈”,這將同時“損害我們模型的效能和整個網路”。
“一個最終產品威脅其基本供應商的經濟基礎是非常不尋常的,但這就是我們為LLM業務在其‘內容供應鏈’方面創造的情況,”微軟檔案在檔案中引用道。
微軟執行長薩提亞·納德拉今年早些時候在證詞中也表示,“任何受付費牆保護的內容,任何希望使用它的人……都應獲得授權,用於基礎或訓練”,並澄清如果他“得知OpenAI抓取並訓練了受付費牆保護的資訊”,他將“援引[微軟的權利]要求OpenAI重新訓練其模型”。
其他承認削弱了合理使用測試的不同方面:OpenAI ChatGPT負責人尼克·特利在內部通訊中寫道,出版商面臨來自聊天機器人等產品的“生存威脅”,這些產品“在很大程度上是可替代的”,並且“隨著它們變得更好,將變得越來越可替代”。
OpenAI總裁格雷格·布羅克曼將模型描述為“擅長新聞”。納德拉今年早些時候在宣誓作證時同意,與聊天機器人互動“已經替代了……直接在AI平臺上的網站上提供資訊,而不是需要去底層來源”。
此類語言突顯了該技術如何直接與原作品競爭,而不是對其進行改造。
微軟的一份檔案指出,生成式AI“有可能嚴重擾亂那些為基礎模型訓練生成資料的人的就業”的“現實風險”。
複製的規模令人震驚。檔案首次顯示,OpenAI的中期訓練資料集中僅包含來自《紐約時報》、《每日新聞》和調查報道中心的91,692多部作品的副本。一個源自Common Crawl的資料集僅包含來自nytimes.com的200多萬份文件。
在2023年1月的一份內部備忘錄中,赫克稱其為“前所未有的驚人盜竊”和“人類歷史上最大的勞動盜竊”。
該檔案提供了OpenAI和微軟如何獲取原告內容的細節,包括從必應索引中抓取內容。
“OpenAI將整個GPT-3訓練資料集交付給微軟,微軟利用該資料集評估如何在自己的商業產品中實施OpenAI的模型,”檔案指出。“微軟還透過名為Project Taxi和Project Mango的計劃向OpenAI提供了類似的資料。”
據稱,這些公司將Project Mango資料組裝成一個訓練資料集,其中包含來自新聞出版商至少160,903部獨特作品的副本。
為了最大化抓取的有效性,OpenAI員工據稱制定了一項計劃,以在不被察覺的情況下規避付費牆。檔案顯示,當OpenAI研究員尼克·萊德向布羅克曼告知“繞過nytimes付費牆的破解方法”時,布羅克曼回覆道:“啊,不錯。”
據稱,OpenAI員工還構建了像WebText和WebText2這樣的訓練資料集,這些資料集不成比例地依賴於抓取的新聞內容。他們還據稱從Common Crawl(一個免費的網路抓取資料開放儲存庫)中提取了數百萬篇文章。調查結果還描述了在資料到達模型之前故意從訓練資料中刪除版權宣告的努力,因為研究人員“不希望模型向使用者輸出”“版權宣告”。
OpenAI和微軟未回覆置評請求。
相關文章
 隨著 Sol 和 Luna 加入,OpenAI GPT-6 在各項基準測試中將代幣成本削減一半
根據 Artificial Analysis 的報告,GPT-6 Sol (max) 在智慧能力方面名列榜首,售價為 48 美元。圖片來源:Getty Images在 OpenAI 推出 GPT-6 Sol 和 Luna 之後,解決方案工程總監 Matt Weaver 向《AI Magazine》闡述了這些新模型如何為企業提供更強大的營運靈活性。OpenAI 近期推出了 GPT-6 Astra,並
AI 墳場:一份持續更新的失敗專案與新創公司清單
Relay 是一項以人工智慧驅動的工作流程自動化平台,定位為 Zapier 的替代方案,已於週一停止營運。該服務讓使用者能透過 AI 代理程式自動化電子郵件和任務工作流程,但隨著 OpenAI、Google 及其他主要平台將類似的自動化功能直接整合至其生態系統中,成立五年的 Relay 已難以證明其作為獨立產品的存在價值。Relay 這家被大型平台超越的新創公司,反映了當前產業格局的一面。然而,許
OpenAI 押注家庭,ChatGPT 深入千家萬戶
ChatGPT 將生成式 AI 推向聚光燈下已逾三年,OpenAI 正將其業務範圍從個人使用者擴充套件至整個家庭。OpenAI 正在舊金山招聘一名產品經理,以開發其平臺上的家庭導向體驗,目標受眾包括父母、照護者和老年人。根據職位列表,該職位要求具備為家庭及其他對信任敏感的消費者應用開發產品的背景。此次招聘與 ChatGPT 不斷演變的使用者群體相契合,其使用者年齡已超出最初的年輕群體。Sensor Tower 獨家向 TechCrunch 分享的資料顯示,全球範圍內,35 歲及以上使用者在 Q2 佔 Cha
相關專題推薦
金融
 Excel AI 預算預測工具,用於現金流規劃和費用控制
2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
 9 個工具
 xix.ai
迅速的
團隊使用的AI提示詞管理工具
2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai
音樂創作
用於音樂創作的 AI 歌詞構思工具
2026 年最新、最受好評的 AI 歌詞構思工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,這些工具均經過實際測試,能快速提供高品質的歌詞構思,協助使用者激發創意並簡化音樂創作流程。 您還可獲取免費版與付費版的比較概覽。立即探索,發掘最適合您的工具!
16 個工具
xix.ai
漫畫創作
用於漫畫世界構建的AI角色設定表工具
2026 年最新最佳頂級評分 AI 角色表工具,助力漫畫世界構建,現已登陸 XIX.AI!本精選列表收錄了經過嚴格現實測試的強大且具顛覆性的選項。您將看到免費與付費版本的對比,以及每週更新的排行榜,助您發掘那些能激發創意並簡化世界構建任務的必備工具。立即探索,解鎖您的 AI 優勢!
13 個工具
xix.ai
自動化
n8n AI 自動化工具,適用於內部營運、資料同步及多步驟代理流程
2026 年最新最佳 n8n AI 自動化工具,適用於內部營運、資料同步及多步驟代理流程,現已登場!XIX.AI 精心精選了一系列廣受好評、功能強大且能徹底改變遊戲規則的工具,可提升各項工作任務的生產力。 每項工具均經過嚴格的實際環境測試以確保可靠性,並提供詳盡的免費版與付費版比較,以及每週更新的排行榜。這些必試選項能助您發揮 AI 優勢,並輕鬆優化工作流程。立即探索,找出最適合您的工具!
11 個工具
xix.ai
迅速的
最適合多模型團隊的最佳提示管理工具
2026 年最新、最受好評的多模型團隊必備提示語管理工具! XIX.AI 精心精選了一系列強大且顛覆遊戲規則的必試工具,提供免費與付費版本的比較、實際應用測試以及詳細排名。這些頂級解決方案能透過簡化工作流程、消除重複作業,並在所有團隊專案中激發創意,從而顯著提升生產力。立即探索,找到最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (0)
0/500
紐約時報針對OpenAI和微軟提起的為期三年的版權訴訟中解密的檔案顯示,一家公司承認AI抓取構成盜竊,並對媒體機構構成嚴重威脅。
根據訴訟檔案,微軟的一位高管私下將公司的AI訓練方法稱為“盜竊”,而OpenAI的領導層承認,其模型對訓練它們的出版商和記者構成了“生存威脅”。
新解密的記錄還詳細說明了這些公司如何繞過付費牆而不被察覺地訪問和利用這些內容,透過大規模抓取構建訓練資料集,並故意從資料中刪除版權宣告。
需要注意的是,這些新資訊大多來自《紐約時報》自身的法律簡報,而非仍處於保密狀態的原始證據。以下引用的內容未提供原始語境。
這份未經刪節的檔案標誌著這場三年訴訟的最新升級,紐約時報最初聲稱這些公司透過利用其內容訓練生成式AI模型違反了版權法。
關於AI公司是否可以合法使用受版權保護的材料進行訓練,目前尚無明確的法律答案,儘管法官們通常傾向於支援AI公司的觀點,即此類訓練屬於“合理使用”。這一法律原則允許在特定情況下未經許可使用受版權保護的作品,例如諷刺、新聞報道或評論。本月早些時候,特朗普政府提交了一份簡報,支援OpenAI未經授權使用受版權保護的材料來訓練其大型語言模型。
然而,這些新承認中的幾項與OpenAI的合理使用抗辯相矛盾,特別是要求這種使用不替代或損害原作品的市場。
例如,微軟自己的資料顯示,其Copilot“答案引擎”導致《紐約時報》域名的點選率與傳統必應搜尋相比下降了高達93%。微軟應用科學總監布倫特·赫克於2024年1月撰寫的一份內部微軟簡報將這種下降描述為“死亡迴圈”,這將同時“損害我們模型的效能和整個網路”。
“一個最終產品威脅其基本供應商的經濟基礎是非常不尋常的,但這就是我們為LLM業務在其‘內容供應鏈’方面創造的情況,”微軟檔案在檔案中引用道。
微軟執行長薩提亞·納德拉今年早些時候在證詞中也表示,“任何受付費牆保護的內容,任何希望使用它的人……都應獲得授權,用於基礎或訓練”,並澄清如果他“得知OpenAI抓取並訓練了受付費牆保護的資訊”,他將“援引[微軟的權利]要求OpenAI重新訓練其模型”。
其他承認削弱了合理使用測試的不同方面:OpenAI ChatGPT負責人尼克·特利在內部通訊中寫道,出版商面臨來自聊天機器人等產品的“生存威脅”,這些產品“在很大程度上是可替代的”,並且“隨著它們變得更好,將變得越來越可替代”。
OpenAI總裁格雷格·布羅克曼將模型描述為“擅長新聞”。納德拉今年早些時候在宣誓作證時同意,與聊天機器人互動“已經替代了……直接在AI平臺上的網站上提供資訊,而不是需要去底層來源”。
此類語言突顯了該技術如何直接與原作品競爭,而不是對其進行改造。
微軟的一份檔案指出,生成式AI“有可能嚴重擾亂那些為基礎模型訓練生成資料的人的就業”的“現實風險”。
複製的規模令人震驚。檔案首次顯示,OpenAI的中期訓練資料集中僅包含來自《紐約時報》、《每日新聞》和調查報道中心的91,692多部作品的副本。一個源自Common Crawl的資料集僅包含來自nytimes.com的200多萬份文件。
在2023年1月的一份內部備忘錄中,赫克稱其為“前所未有的驚人盜竊”和“人類歷史上最大的勞動盜竊”。
該檔案提供了OpenAI和微軟如何獲取原告內容的細節,包括從必應索引中抓取內容。
“OpenAI將整個GPT-3訓練資料集交付給微軟,微軟利用該資料集評估如何在自己的商業產品中實施OpenAI的模型,”檔案指出。“微軟還透過名為Project Taxi和Project Mango的計劃向OpenAI提供了類似的資料。”
據稱,這些公司將Project Mango資料組裝成一個訓練資料集,其中包含來自新聞出版商至少160,903部獨特作品的副本。
為了最大化抓取的有效性,OpenAI員工據稱制定了一項計劃,以在不被察覺的情況下規避付費牆。檔案顯示,當OpenAI研究員尼克·萊德向布羅克曼告知“繞過nytimes付費牆的破解方法”時,布羅克曼回覆道:“啊,不錯。”
據稱,OpenAI員工還構建了像WebText和WebText2這樣的訓練資料集,這些資料集不成比例地依賴於抓取的新聞內容。他們還據稱從Common Crawl(一個免費的網路抓取資料開放儲存庫)中提取了數百萬篇文章。調查結果還描述了在資料到達模型之前故意從訓練資料中刪除版權宣告的努力,因為研究人員“不希望模型向使用者輸出”“版權宣告”。
OpenAI和微軟未回覆置評請求。


 隨著 Sol 和 Luna 加入,OpenAI GPT-6 在各項基準測試中將代幣成本削減一半
根據 Artificial Analysis 的報告,GPT-6 Sol (max) 在智慧能力方面名列榜首,售價為 48 美元。圖片來源:Getty Images在 OpenAI 推出 GPT-6 Sol 和 Luna 之後,解決方案工程總監 Matt Weaver 向《AI Magazine》闡述了這些新模型如何為企業提供更強大的營運靈活性。OpenAI 近期推出了 GPT-6 Astra,並
 AI 墳場:一份持續更新的失敗專案與新創公司清單
Relay 是一項以人工智慧驅動的工作流程自動化平台,定位為 Zapier 的替代方案,已於週一停止營運。該服務讓使用者能透過 AI 代理程式自動化電子郵件和任務工作流程,但隨著 OpenAI、Google 及其他主要平台將類似的自動化功能直接整合至其生態系統中,成立五年的 Relay 已難以證明其作為獨立產品的存在價值。Relay 這家被大型平台超越的新創公司,反映了當前產業格局的一面。然而,許
 OpenAI 押注家庭,ChatGPT 深入千家萬戶
ChatGPT 將生成式 AI 推向聚光燈下已逾三年,OpenAI 正將其業務範圍從個人使用者擴充套件至整個家庭。OpenAI 正在舊金山招聘一名產品經理,以開發其平臺上的家庭導向體驗,目標受眾包括父母、照護者和老年人。根據職位列表,該職位要求具備為家庭及其他對信任敏感的消費者應用開發產品的背景。此次招聘與 ChatGPT 不斷演變的使用者群體相契合,其使用者年齡已超出最初的年輕群體。Sensor Tower 獨家向 TechCrunch 分享的資料顯示,全球範圍內,35 歲及以上使用者在 Q2 佔 Cha

2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai

2026 年最新、最受好評的 AI 歌詞構思工具,盡在 XIX.AI!這份精心挑選的清單收錄了多款強大且具革命性的工具,這些工具均經過實際測試,能快速提供高品質的歌詞構思,協助使用者激發創意並簡化音樂創作流程。 您還可獲取免費版與付費版的比較概覽。立即探索,發掘最適合您的工具!
16 個工具
xix.ai
2026 年最新最佳頂級評分 AI 角色表工具,助力漫畫世界構建,現已登陸 XIX.AI!本精選列表收錄了經過嚴格現實測試的強大且具顛覆性的選項。您將看到免費與付費版本的對比,以及每週更新的排行榜,助您發掘那些能激發創意並簡化世界構建任務的必備工具。立即探索,解鎖您的 AI 優勢!
13 個工具
xix.ai
2026 年最新最佳 n8n AI 自動化工具,適用於內部營運、資料同步及多步驟代理流程,現已登場!XIX.AI 精心精選了一系列廣受好評、功能強大且能徹底改變遊戲規則的工具,可提升各項工作任務的生產力。 每項工具均經過嚴格的實際環境測試以確保可靠性,並提供詳盡的免費版與付費版比較,以及每週更新的排行榜。這些必試選項能助您發揮 AI 優勢,並輕鬆優化工作流程。立即探索,找出最適合您的工具!
11 個工具
xix.ai
2026 年最新、最受好評的多模型團隊必備提示語管理工具! XIX.AI 精心精選了一系列強大且顛覆遊戲規則的必試工具,提供免費與付費版本的比較、實際應用測試以及詳細排名。這些頂級解決方案能透過簡化工作流程、消除重複作業,並在所有團隊專案中激發創意,從而顯著提升生產力。立即探索,找到最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai












