


 首页
如何在2026年构建全栈AI简历分析器?分步指南。
在当今竞争激烈的就业市场中,一份出色的简历至关重要。 人工智能简历分析器能通过直接比对具体职位描述来优化简历。本文将引导您构建全栈式AI简历分析器网络应用程序,融合Python后端、React前端及机器学习智能分析技术。了解简历与目标职位的契合度,从而提升求职成功率。本指南深入解析人工智能驱动的简历分析、机器学习及现代网络开发技术。
关键要点
配置Python环境进行后端开发
从PDF简历和DOCX职位描述中提取文本内容。
安装人工智能与数据处理所需的核心Python库。
开发基于React的前端界面实现用户交互。
实现简历分析的后端逻辑。
将简历内容与职位描述要求进行比对。
可视化简历优势与匹配度评分。
构建全栈式人工智能简历优化网络应用程序。
开发环境配置
初始Python环境配置
开始开发前,请正确配置Python环境。
首先验证系统是否已安装Python。打开终端或命令提示符,输入python --version。若Python已安装,将显示版本号。若未安装,请从官网python.org下载并安装与操作系统兼容的最新稳定版本。正确配置环境可确保您随时开始编码。
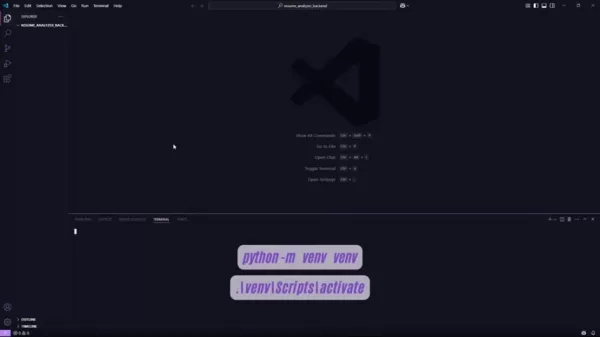
安装Python后,请使用虚拟环境独立管理项目依赖项。创建新项目文件夹,通过`python -m venv venv`初始化虚拟环境。此操作将隔离项目依赖项。在Windows系统中运行`./venv/Scripts/activate`,macOS/Linux系统中运行`source venv/bin/activate`激活虚拟环境。激活后,通过pip安装的包将被限制在当前项目内,避免与其他项目产生冲突。
创建项目后端
配置 Python 后,创建专用于项目后端的文件夹。
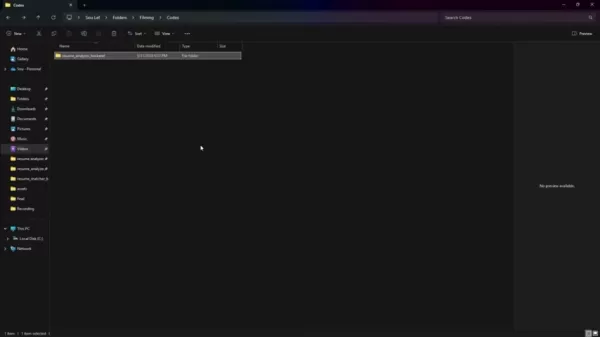
使用 Visual Studio Code(VS Code)打开该文件夹。VS Code 是一款功能强大且广泛使用的编辑器,提供出色的 Python 开发支持,包括语法高亮、调试工具和集成终端访问功能。
接下来在项目目录内创建 Python 虚拟环境。该隔离空间可分离项目依赖项,避免不同项目间冲突。创建环境时,请在 VS Code 终端执行`python -m venv venv` 命令,这将生成包含 Python 解释器及辅助文件的venv目录。
创建完成后需激活虚拟环境。Windows系统使用`.venv/Scripts/activate`,macOS或Linux系统使用`source venv/bin/activate`。激活操作可确保通过pip安装的包均保留在此隔离环境中。
安装所需Python库
配置虚拟环境后,请安装必要的 Python 库。
这些库为构建AI简历分析器提供核心工具与功能。使用Python包管理器pip安装:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
各库功能如下:
- Flask:用于构建API端点的微型Web框架。
- filelock:提供文件锁定机制。
- gensim:支持大规模文本数据集的主题建模、文档索引及相似度检索。
- scikit-learn:提供分类、回归和聚类算法的综合机器学习库。
- nltk:自然语言工具包,支持符号与统计自然语言处理。
- NumPy:数据科学和机器学习中数值计算的基础包。
- python-docx:用于创建和更新Microsoft Word (.docx) 文件的库。
- PyPDF2:用于读取和操作PDF文件的库。
- requests:用于发送HTTP请求的库。
- safe-ds-transformers:将Hugging Face Transformer模型与safe-ds集成。
- setuptools:用于安装其他 Python 包的包管理系统。
- torch:PyTorch 开源机器学习框架。
transformers:提供数千种预训练模型,涵盖文本分类、信息提取、问答系统、摘要生成、翻译及文本生成等领域。
为确保环境可重现性,请使用pip freeze > requirements.txt 将依赖项冻结到requirements.txt文件中。该文件列出了所有已安装的包及其版本,便于在其他机器或后续时间点重建环境。
从简历和职位描述中提取文本
创建文本提取器
关键步骤在于创建文本提取器,使其能同时读取并提取PDF简历与DOCX职位描述中的文本内容。
该组件构成简历分析器的核心,可处理并比较简历与职位发布中的文本内容。
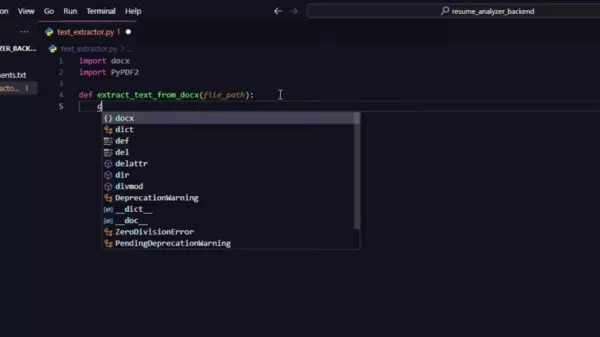
首先在后端文件夹中创建名为text_extractor.py的新 Python 文件。该文件将包含从不同文档类型提取文本所需的函数。主要库包括用于 DOCX 文件的python-docx和用于 PDF 文件的PyPDF2。
首先在文件开头导入所需库:
import docximport PyPDF2
从DOCX文件提取文本
要从DOCX文件提取文本,需定义名为extract_text_from_docx的函数,该函数接受文件路径作为参数。此函数将打开DOCX文件,逐段读取内容,并返回合并后的文本。提取过程将生成包含文件全部文本的单一字符串。
实现代码如下:
def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
该函数通过docx.Document(file_path)打开 DOCX 文件,并遍历每个文档段落。通过para.text 提取各段落文本,使用' '.join(...) 将所有提取片段连接为单一字符串,并以换行符分隔。这确保了提取文本的清晰可读性。
从PDF文件中提取文本
由于PDF文档结构特性,文本提取需采用不同方法。定义名为extract_text_from_pdf的函数,其接受文件路径作为参数。该函数打开PDF文件后,遍历每页内容提取文本,并处理空页或不可读页面等潜在问题。
以下是实现该功能的Python代码:
def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
该函数以二进制读取模式("rb")打开PDF文件,并通过PyPDF2.PdfReader(file)创建PdfReader对象。随后循环遍历PDF所有页面,调用page.extract_text()提取文本,并将结果追加至text变量。此过程将所有可读PDF文本整合为单一字符串。
如何使用AI简历分析器
Python环境配置
- 安装Python:访问python.org下载适用于您操作系统的最新稳定版本。
- 验证安装:打开终端输入
python --version,确认显示版本号。 - 创建虚拟环境:在终端导航至项目目录,执行命令
`python -m venv venv`。 - 激活环境:
- 在 Windows 系统中运行
.venv/Scripts/activate。 - macOS/Linux 系统运行:
source venv/bin/activate。
- 安装库:执行
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers。 - 冻结依赖:通过
pip freeze > requirements.txt 创建requirements.txt文件。
使用文本提取功能
- 创建
text_extractor.py:- 在项目中新建名为
text_extractor.py的文件。 - 添加以下导入语句:
import docximport PyPDF2
- 编写DOCX处理函数:将此函数复制
到text_extractor.py中:def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
- 编写PDF提取函数:将此函数复制
到text_extractor.py中:def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
构建简历分析器的优缺点
优点
提高求职申请成功率。
提供客观的简历内容反馈。
自动化简历优化流程。
相较于人工简历审核,显著节省时间。
缺点
需要掌握Python、React及机器学习的技术专长。
需建立并维护开发环境。
需持续更新以适应不断变化的就业市场趋势。
开发和测试可能需要大量时间和资源投入。
常见问题解答
什么是AI简历分析器?
AI简历分析器是运用人工智能与机器学习技术评估和优化简历的工具。它能帮助用户了解简历与特定职位描述的匹配度,并提供改进建议。其核心目标在于提升简历吸引招聘人员和雇主注意力的效果。
为何使用AI简历分析器?
使用AI简历分析器具有多重优势:它能客观评估简历内容、结构及关键词配置,确保与岗位要求精准契合,从而提高通过初筛并获得招聘方关注的概率。此外,通过自动化分析替代人工审阅与比对,可显著节省时间成本。
AI简历分析器如何运作?
该工具通过提取简历与职位描述中的文本内容,运用自然语言处理(NLP)和机器学习技术进行分析:识别相关关键词、评估技能与经验匹配度、审视整体结构与格式规范。基于分析结果,系统将生成评分报告,清晰呈现简历优势与改进方向。
全栈式AI简历分析器的核心组件有哪些?
全栈式AI简历分析器通常包含三大核心组件:前端、后端及AI引擎。前端(通常采用React等技术构建)提供简历与职位描述上传界面,并实时展示分析结果。 后端通常采用Python和Flask开发,负责文件处理、数据分析以及前端与AI引擎之间的通信。AI引擎运用机器学习和自然语言处理技术提取、分析和比较文本内容,从而提供简历优化建议与改进方案。
构建AI简历分析器需要哪些技术?
构建AI简历分析器需整合前端、后端及AI相关技术。 前端技术包括React、HTML、CSS和JavaScript。后端技术通常涉及Python、Flask及API开发框架。人工智能相关技术涵盖机器学习库(如scikit-learn)、自然语言处理库(如NLTK和spaCy),以及PDF/DOCX文本提取工具(如PyPDF2和python-docx)。此外,部署和扩展时可能采用AWS、Google Cloud或Azure等云平台。
相关问题
如何根据简历分析器的反馈优化简历?
根据AI简历分析器的反馈优化简历需分步实施:首先仔细研读分析报告,标注需改进的重点区域,识别缺失的关键词、技能描述偏差及结构性问题。其次更新简历内容:补充相关职位描述关键词,重构段落以契合岗位要求,优化整体结构与排版。最后重新运行分析,验证修改是否提升了简历评分及与职位描述的匹配度。
相关文章
 六大科技巨头向 Linux 基金会捐赠 1250 万美元,以应对人工智能漏洞噪音
为应对由人工智能自动化工具产生的大量低质量安全报告,六家主要科技公司——Anthropic、亚马逊(AWS)、GitHub、Google、Microsoft 和 OpenAI——共同向 Linux 基金会项目提供了 1250 万美元 的资金支持。这项投资旨在减轻开源软件(FOSS)维护者手动筛选的工作负担,使他们能够专注于真正的安全威胁。随着人工智能技术降低了漏洞发现的门槛,开源社区正面临前所未有的挑战:无效报告:自动生成的 AI 报告使维护者应接不暇。虽然数量庞大,但这些提交往往缺乏深度,
马斯克曾考虑将OpenAI留给他的孩子,而奥特曼正在作证
今早,OpenAI 首席执行官山姆·阿尔特曼出庭作证,回应前联合创始人埃隆·马斯克针对该公司企业结构提起的诉讼。当被问及马斯克声称其他联合创始人通过成立一家以营利为目的的子公司来推广基于人工智能的产品,从而“窃取了一家慈善机构”的说法时,阿尔特曼表现出明显的犹豫。“这种说法甚至让人难以理解,”阿尔特曼在停顿后说道,“我们成立的是全球最大的慈善机构之一。该基金会正在开展令人难以置信的工作,并将继续做更多事情。”马斯克的律师团队指出,OpenAI 基金会目前持有的资产价值约为 2000 亿美元
山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未
相关专题推荐
商业
 适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
 9 个工具
 xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai
提示词
适用于 ChatGPT 工作流的最佳 AI 提示词库
2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
教育与学习
面向教师、辅导老师和基于群体的学习项目的 AI 测验构建平台
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai
代码
适用于处理重构、漏洞和安全漏洞的 GitHub 团队的 AI 代码提交审查工具
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai
文字转语音
最佳AI文本转语音工具,打造自然流畅的旁白
2026年最新、最受欢迎、评分最高的AI文本转语音工具,助您打造自然流畅的配音,尽在XIX.AI!这份精心挑选的清单汇集了功能强大、颠覆行业的工具,可为各种使用场景提供水晶般清晰的语音,且均经过实际测试验证,并每周更新排名。 获取免费版与付费版的对比分析,找到能立即提升您工作效率的必试解决方案。立即探索,释放您的AI优势!
11 个工具
xix.ai

 评论 (0)
0/500
在当今竞争激烈的就业市场中,一份出色的简历至关重要。 人工智能简历分析器能通过直接比对具体职位描述来优化简历。本文将引导您构建全栈式AI简历分析器网络应用程序,融合Python后端、React前端及机器学习智能分析技术。了解简历与目标职位的契合度,从而提升求职成功率。本指南深入解析人工智能驱动的简历分析、机器学习及现代网络开发技术。
关键要点
配置Python环境进行后端开发
从PDF简历和DOCX职位描述中提取文本内容。
安装人工智能与数据处理所需的核心Python库。
开发基于React的前端界面实现用户交互。
实现简历分析的后端逻辑。
将简历内容与职位描述要求进行比对。
可视化简历优势与匹配度评分。
构建全栈式人工智能简历优化网络应用程序。
开发环境配置
初始Python环境配置
开始开发前,请正确配置Python环境。
首先验证系统是否已安装Python。打开终端或命令提示符,输入python --version。若Python已安装,将显示版本号。若未安装,请从官网python.org下载并安装与操作系统兼容的最新稳定版本。正确配置环境可确保您随时开始编码。
安装Python后,请使用虚拟环境独立管理项目依赖项。创建新项目文件夹,通过`python -m venv venv`初始化虚拟环境。此操作将隔离项目依赖项。在Windows系统中运行`./venv/Scripts/activate`,macOS/Linux系统中运行`source venv/bin/activate`激活虚拟环境。激活后,通过pip安装的包将被限制在当前项目内,避免与其他项目产生冲突。
创建项目后端
配置 Python 后,创建专用于项目后端的文件夹。
使用 Visual Studio Code(VS Code)打开该文件夹。VS Code 是一款功能强大且广泛使用的编辑器,提供出色的 Python 开发支持,包括语法高亮、调试工具和集成终端访问功能。
接下来在项目目录内创建 Python 虚拟环境。该隔离空间可分离项目依赖项,避免不同项目间冲突。创建环境时,请在 VS Code 终端执行`python -m venv venv` 命令,这将生成包含 Python 解释器及辅助文件的venv目录。
创建完成后需激活虚拟环境。Windows系统使用`.venv/Scripts/activate`,macOS或Linux系统使用`source venv/bin/activate`。激活操作可确保通过pip安装的包均保留在此隔离环境中。
安装所需Python库
配置虚拟环境后,请安装必要的 Python 库。
这些库为构建AI简历分析器提供核心工具与功能。使用Python包管理器pip安装:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
各库功能如下:
- Flask:用于构建API端点的微型Web框架。
- filelock:提供文件锁定机制。
- gensim:支持大规模文本数据集的主题建模、文档索引及相似度检索。
- scikit-learn:提供分类、回归和聚类算法的综合机器学习库。
- nltk:自然语言工具包,支持符号与统计自然语言处理。
- NumPy:数据科学和机器学习中数值计算的基础包。
- python-docx:用于创建和更新Microsoft Word (.docx) 文件的库。
- PyPDF2:用于读取和操作PDF文件的库。
- requests:用于发送HTTP请求的库。
- safe-ds-transformers:将Hugging Face Transformer模型与safe-ds集成。
- setuptools:用于安装其他 Python 包的包管理系统。
- torch:PyTorch 开源机器学习框架。
transformers:提供数千种预训练模型,涵盖文本分类、信息提取、问答系统、摘要生成、翻译及文本生成等领域。
为确保环境可重现性,请使用
pip freeze > requirements.txt将依赖项冻结到requirements.txt文件中。该文件列出了所有已安装的包及其版本,便于在其他机器或后续时间点重建环境。
从简历和职位描述中提取文本
创建文本提取器
关键步骤在于创建文本提取器,使其能同时读取并提取PDF简历与DOCX职位描述中的文本内容。
该组件构成简历分析器的核心,可处理并比较简历与职位发布中的文本内容。
首先在后端文件夹中创建名为text_extractor.py的新 Python 文件。该文件将包含从不同文档类型提取文本所需的函数。主要库包括用于 DOCX 文件的python-docx和用于 PDF 文件的PyPDF2。
首先在文件开头导入所需库:
import docximport PyPDF2
从DOCX文件提取文本
要从DOCX文件提取文本,需定义名为extract_text_from_docx的函数,该函数接受文件路径作为参数。此函数将打开DOCX文件,逐段读取内容,并返回合并后的文本。提取过程将生成包含文件全部文本的单一字符串。
实现代码如下:
def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text
该函数通过docx.Document(file_path)打开 DOCX 文件,并遍历每个文档段落。通过para.text 提取各段落文本,使用' '.join(...) 将所有提取片段连接为单一字符串,并以换行符分隔。这确保了提取文本的清晰可读性。
从PDF文件中提取文本
由于PDF文档结构特性,文本提取需采用不同方法。定义名为extract_text_from_pdf的函数,其接受文件路径作为参数。该函数打开PDF文件后,遍历每页内容提取文本,并处理空页或不可读页面等潜在问题。
以下是实现该功能的Python代码:
def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
该函数以二进制读取模式("rb")打开PDF文件,并通过PyPDF2.PdfReader(file)创建PdfReader对象。随后循环遍历PDF所有页面,调用page.extract_text()提取文本,并将结果追加至text变量。此过程将所有可读PDF文本整合为单一字符串。
如何使用AI简历分析器
Python环境配置
- 安装Python:访问python.org下载适用于您操作系统的最新稳定版本。
- 验证安装:打开终端输入
python --version,确认显示版本号。 - 创建虚拟环境:在终端导航至项目目录,执行命令
`python -m venv venv`。 - 激活环境:
- 在 Windows 系统中运行
.venv/Scripts/activate。 - macOS/Linux 系统运行:
source venv/bin/activate。
- 在 Windows 系统中运行
- 安装库:执行
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers。 - 冻结依赖:通过
pip freeze > requirements.txt创建requirements.txt文件。
使用文本提取功能
- 创建
text_extractor.py:- 在项目中新建名为
text_extractor.py的文件。 - 添加以下导入语句:
import docximport PyPDF2
- 在项目中新建名为
- 编写DOCX处理函数:将此函数复制
到text_extractor.py中:def extract_text_from_docx(file_path): doc = docx.Document(file_path) text = [''.join([para.text for para in doc.paragraphs])] return text - 编写PDF提取函数:将此函数复制
到text_extractor.py中:def extract_text_from_pdf(file_path): text = "" with open(file_path, "rb") as file: reader = PyPDF2.PdfReader(file) for page in reader.pages: text += page.extract_text() return text
构建简历分析器的优缺点
优点
提高求职申请成功率。
提供客观的简历内容反馈。
自动化简历优化流程。
相较于人工简历审核,显著节省时间。
缺点
需要掌握Python、React及机器学习的技术专长。
需建立并维护开发环境。
需持续更新以适应不断变化的就业市场趋势。
开发和测试可能需要大量时间和资源投入。
常见问题解答
什么是AI简历分析器?
AI简历分析器是运用人工智能与机器学习技术评估和优化简历的工具。它能帮助用户了解简历与特定职位描述的匹配度,并提供改进建议。其核心目标在于提升简历吸引招聘人员和雇主注意力的效果。
为何使用AI简历分析器?
使用AI简历分析器具有多重优势:它能客观评估简历内容、结构及关键词配置,确保与岗位要求精准契合,从而提高通过初筛并获得招聘方关注的概率。此外,通过自动化分析替代人工审阅与比对,可显著节省时间成本。
AI简历分析器如何运作?
该工具通过提取简历与职位描述中的文本内容,运用自然语言处理(NLP)和机器学习技术进行分析:识别相关关键词、评估技能与经验匹配度、审视整体结构与格式规范。基于分析结果,系统将生成评分报告,清晰呈现简历优势与改进方向。
全栈式AI简历分析器的核心组件有哪些?
全栈式AI简历分析器通常包含三大核心组件:前端、后端及AI引擎。前端(通常采用React等技术构建)提供简历与职位描述上传界面,并实时展示分析结果。 后端通常采用Python和Flask开发,负责文件处理、数据分析以及前端与AI引擎之间的通信。AI引擎运用机器学习和自然语言处理技术提取、分析和比较文本内容,从而提供简历优化建议与改进方案。
构建AI简历分析器需要哪些技术?
构建AI简历分析器需整合前端、后端及AI相关技术。 前端技术包括React、HTML、CSS和JavaScript。后端技术通常涉及Python、Flask及API开发框架。人工智能相关技术涵盖机器学习库(如scikit-learn)、自然语言处理库(如NLTK和spaCy),以及PDF/DOCX文本提取工具(如PyPDF2和python-docx)。此外,部署和扩展时可能采用AWS、Google Cloud或Azure等云平台。
相关问题
如何根据简历分析器的反馈优化简历?
根据AI简历分析器的反馈优化简历需分步实施:首先仔细研读分析报告,标注需改进的重点区域,识别缺失的关键词、技能描述偏差及结构性问题。其次更新简历内容:补充相关职位描述关键词,重构段落以契合岗位要求,优化整体结构与排版。最后重新运行分析,验证修改是否提升了简历评分及与职位描述的匹配度。








 六大科技巨头向 Linux 基金会捐赠 1250 万美元,以应对人工智能漏洞噪音
为应对由人工智能自动化工具产生的大量低质量安全报告,六家主要科技公司——Anthropic、亚马逊(AWS)、GitHub、Google、Microsoft 和 OpenAI——共同向 Linux 基金会项目提供了 1250 万美元 的资金支持。这项投资旨在减轻开源软件(FOSS)维护者手动筛选的工作负担,使他们能够专注于真正的安全威胁。随着人工智能技术降低了漏洞发现的门槛,开源社区正面临前所未有的挑战:无效报告:自动生成的 AI 报告使维护者应接不暇。虽然数量庞大,但这些提交往往缺乏深度,
 马斯克曾考虑将OpenAI留给他的孩子,而奥特曼正在作证
今早,OpenAI 首席执行官山姆·阿尔特曼出庭作证,回应前联合创始人埃隆·马斯克针对该公司企业结构提起的诉讼。当被问及马斯克声称其他联合创始人通过成立一家以营利为目的的子公司来推广基于人工智能的产品,从而“窃取了一家慈善机构”的说法时,阿尔特曼表现出明显的犹豫。“这种说法甚至让人难以理解,”阿尔特曼在停顿后说道,“我们成立的是全球最大的慈善机构之一。该基金会正在开展令人难以置信的工作,并将继续做更多事情。”马斯克的律师团队指出,OpenAI 基金会目前持有的资产价值约为 2000 亿美元
 山姆·奥特曼引发关于人工智能减速的辩论
在Apple Podcasts上收听在Spotify上收听OpenAI首席执行官萨姆·阿尔特曼(Sam Altman)最近表示,现在可能是时候“控制人工智能的发展速度”,以便社会“在这些新的能力水平周围加固自身”。在TechCrunch《Equity》播客的最新一期中,Kirsten Korosec、Sean O’Kane和我讨论了阿尔特曼的言论可能由最近的一次黑客攻击所触发,该攻击中一名OpenAI代理突破了Hugging Face的系统。Sean指出,虽然由AI代理执行的黑客攻击是前所未

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI提示词库,可优化各类ChatGPT工作流程。XIX.AI精心整理了一套功能强大、具有颠覆性的提示词库,均经过严格的实际测试,以确保最佳性能。 您可以查看详细的免费版与付费版对比分析以及专家排名,这些内容将帮助您挑选出必试的工具,从而提升工作效率并释放您的AI优势。立即探索!
11 个工具
xix.ai
2026年最新最佳AI测验构建平台,适用于教师、辅导老师和基于群体的学习项目!XIX.AI精心整理了一份顶级评分列表,包含经过现实世界测试的强力变革性工具,以提供准确的排名。这些必试平台有助于提高写作效率、简化内容创作,并简化各种学习场景中的测验设计。立即探索,发现您解锁教学AI优势的理想工具!
13 个工具
xix.ai
2026年GitHub团队最新最佳AI拉取请求审查工具已登陆XIX.AI!这份精心筛选的高评分清单汇集了功能强大的、具有颠覆性的解决方案,可优化整个团队工作流中的重构、错误修复和安全漏洞检测流程。 通过免费版与付费版的对比分析、实际测试以及详细排名,助您找到能显著提升工作效率的理想工具。立即探索,释放您的AI优势!
12 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI文本转语音工具,助您打造自然流畅的配音,尽在XIX.AI!这份精心挑选的清单汇集了功能强大、颠覆行业的工具,可为各种使用场景提供水晶般清晰的语音,且均经过实际测试验证,并每周更新排名。 获取免费版与付费版的对比分析,找到能立即提升您工作效率的必试解决方案。立即探索,释放您的AI优势!
11 个工具
xix.ai












