


 Дом
Как создать полнофункциональный анализатор резюме на базе искусственного интеллекта в 2026 году? Пошаговое руководство.
На современном конкурентном рынке труда важно иметь выделяющееся резюме. AI Resume Analyzer может оптимизировать ваше резюме, сравнивая его непосредственно с конкретными описаниями вакансий. В этой статье вы узнаете, как создать полнофункциональное веб-приложение AI Resume Analyzer, сочетающее Python для бэкэнда, React для фронтэнда и машинное обучение для интеллектуального анализа. Узнайте, как повысить вероятность успеха при поиске работы, понимая, насколько ваше резюме соответствует целевым должностям. В этом руководстве представлены сведения об анализе резюме с помощью искусственного интеллекта, машинном обучении и современной веб-разработке.
Ключевые моменты
Настройте среду Python для разработки бэкэнда.
Извлеките текстовое содержание из резюме в формате PDF и описаний должностей в формате DOCX.
Установите необходимые библиотеки Python для искусственного интеллекта и обработки данных.
Разработайте фронтенд на основе React для взаимодействия с пользователем.
Реализуйте логику бэкэнда для анализа резюме.
Сравнить содержание резюме с требованиями описания вакансии.
Визуализировать сильные стороны резюме и оценки соответствия.
Создайте полнофункциональное веб-приложение для улучшения резюме с помощью искусственного интеллекта.
Настройка среды разработки
Начальная настройка среды Python
Перед началом разработки правильно настройте среду Python.
Сначала проверьте, установлен ли Python в вашей системе. Откройте терминал или командную строку и введите python --version. Если Python установлен, отобразится номер версии. Если нет, загрузите и установите Python с официального сайта python.org, выбрав последнюю стабильную версию, совместимую с вашей операционной системой. Правильная настройка среды гарантирует, что вы готовы приступить к программированию.
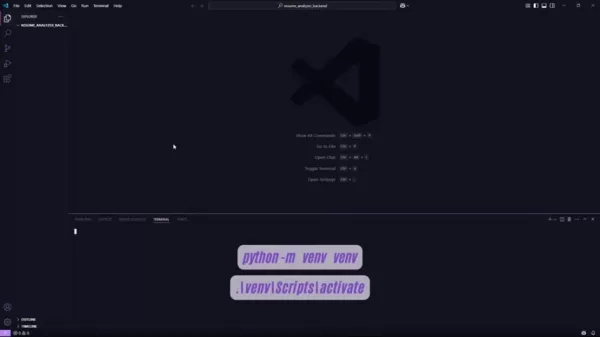
После установки Python используйте виртуальные среды для отдельного управления зависимостями проекта. Создайте новую папку проекта и инициализируйте виртуальную среду с помощью python -m venv venv. Это изолирует зависимости проекта. Активируйте виртуальную среду, запустив . ./venv/Scripts/activate в Windows или source venv/bin/activate в macOS и Linux. Активация гарантирует, что пакеты, установленные через pip, останутся в пределах этого проекта, предотвращая конфликты с другими проектами.
Создание бэкэнда проекта
После настройки Python создайте специальную папку для бэкэнда вашего проекта.
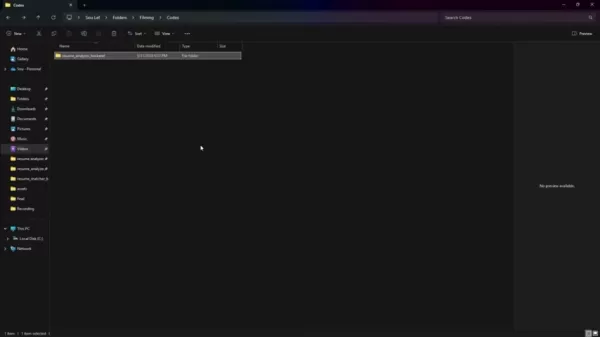
Откройте эту папку с помощью Visual Studio Code (VS Code). VS Code — это универсальный, широко используемый редактор, предлагающий отличную поддержку разработки на Python, включая подсветку синтаксиса, инструменты отладки и интегрированный доступ к терминалу.
Затем создайте виртуальную среду Python в каталоге вашего проекта. Это изолированное пространство позволяет разделить зависимости проекта, предотвращая конфликты между разными проектами. Чтобы создать среду, откройте терминал VS Code и выполните команду python -m venv venv. Это создаст каталог venv, содержащий интерпретатор Python и вспомогательные файлы.
Активируйте виртуальную среду после ее создания. В Windows используйте .venvScriptsactivate. В macOS или Linux используйте source venv/bin/activate. Активация гарантирует, что все пакеты, установленные через pip, останутся в этой изолированной среде.
Установка необходимых библиотек Python
После настройки виртуальной среды установите необходимые библиотеки Python.
Эти библиотеки предоставляют необходимые инструменты и функции для создания вашего AI Resume Analyzer. Для их установки используйте pip, установщик пакетов Python. Следующая команда устанавливает ключевые пакеты:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Каждая библиотека служит определенным целям:
- Flask: микро-веб-фреймворк для создания конечных точек API.
- filelock: предоставляет механизмы блокировки файлов.
- gensim: позволяет моделировать темы, индексировать документы и находить сходства в больших наборах текстовых данных.
- scikit-learn: комплексная библиотека машинного обучения, предлагающая алгоритмы классификации, регрессии и кластеризации.
- nltk: набор инструментов для символьной и статистической обработки естественного языка.
- NumPy: базовый пакет для численных вычислений в области науки о данных и машинного обучения.
- python-docx: библиотека для создания и обновления файлов Microsoft Word (.docx).
- PyPDF2: библиотека для чтения и обработки файлов PDF.
- requests: библиотека для отправки HTTP-запросов.
- safe-ds-transformers: интегрирует модели трансформаторов Hugging Face с safe-ds.
- setuptools: система управления пакетами для установки других пакетов Python.
- torch: открытая среда машинного обучения PyTorch.
transformers: предоставляет тысячи предварительно обученных моделей для классификации текста, извлечения информации, ответов на вопросы, резюмирования, перевода и генерации текста.
Чтобы обеспечить воспроизводимость среды, зафиксируйте требования в файле requirements.txt с помощью pip freeze > requirements.txt. В этом файле перечислены все установленные пакеты и версии, что позволяет воссоздать среду на других машинах или в более поздние сроки.
Извлечение текста из резюме и описаний вакансий
Создание инструмента для извлечения текста
Следующий важный шаг — создание текстового экстрактора, способного читать и извлекать текст как из резюме в формате PDF, так и из описаний вакансий в формате DOCX.
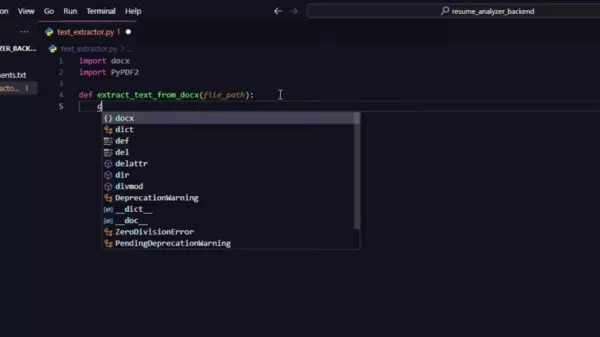
Этот компонент составляет ядро вашего анализатора резюме, позволяя обрабатывать и сравнивать текстовое содержание резюме и объявлений о вакансиях.
Начните с создания нового файла Python с именем text_extractor.py в папке backend. Этот файл будет содержать функции, необходимые для извлечения текста из различных типов документов. Основные библиотеки для этой цели включают python-docx для файлов DOCX и PyPDF2 для файлов PDF.
Начните с импорта необходимых библиотек в начале файла:
import docximport PyPDF2
Извлечение текста из файлов DOCX
Чтобы извлечь текст из файлов DOCX, определите функцию с именем extract_text_from_docx, которая принимает путь к файлу в качестве аргумента. Эта функция открывает файл DOCX, считывает содержимое абзац за абзацем и возвращает объединенный текст. В результате процесса извлечения получается одна строка, содержащая весь текст файла.
Вот код Python для выполнения этой задачи:
def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
Эта функция открывает файл DOCX с помощью docx.Document(file_path) и проходит по каждому абзацу документа. Текст из каждого абзаца извлекается с помощью para.text, а все извлеченные сегменты объединяются в одну строку с помощью ' '.join(...), разделенные символами новой строки. Это обеспечивает чистый и читаемый извлеченный текст.
Извлечение текста из файлов PDF
Извлечение текста из файлов PDF требует немного другого подхода из-за структуры документов PDF. Определите функцию с именем extract_text_from_pdf, которая принимает путь к файлу в качестве аргумента. Эта функция открывает файл PDF, проходит по каждой странице, извлекает текст и обрабатывает потенциальные проблемы, такие как пустые или нечитаемые страницы.
Вот код на Python для выполнения этой задачи:
def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Эта функция открывает PDF-файл в режиме двоичного чтения («rb») и создает объект PdfReader с помощью PyPDF2.PdfReader(file). Затем функция проходит по каждой странице PDF, извлекая текст с помощью page.extract_text(), и добавляет извлеченный текст к переменной text. Таким образом, весь читаемый текст PDF собирается в одну строку.
Как использовать AI Resume Analyzer
Настройка Python
- Установите Python: посетите сайт python.org и загрузите последнюю стабильную версию для вашей операционной системы.
- Проверьте установку: откройте терминал и введите
python --version. Убедитесь, что отображается номер версии. - Создайте виртуальную среду: перейдите в папку вашего проекта в терминале и выполните
python -m venv venv. - Активируйте среду:
- В Windows запустите
.venvScriptsactivate. - В macOS/Linux запустите
source venv/bin/activate.
- Установите библиотеки: выполните
команду pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers. - Заморозьте требования: Создайте файл
requirements.txt с помощью pip freeze > requirements.txt.
Использование функций извлечения текста
- Создайте файл
text_extractor.py:- Создайте новый файл с именем
text_extractor.py в вашем проекте. - Добавьте следующие операторы импорта:
import docximport PyPDF2
- Напишите функцию DOCX: Скопируйте эту функцию в файл
text_extractor.py:def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
- Написать функцию PDF: Скопируйте эту функцию в
text_extractor.py:def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Преимущества и недостатки создания анализатора резюме
Плюсы
Повышает вероятность успешного трудоустройства.
Предоставляет объективную обратную связь по содержанию резюме.
Автоматизирует процесс оптимизации резюме.
Экономит время по сравнению с ручным просмотром резюме.
Недостатки
Требует технических знаний в области Python, React и машинного обучения.
Требует создания и поддержания среды разработки.
Требует постоянных обновлений для адаптации к меняющимся тенденциям рынка труда.
Может потребовать значительного времени и ресурсов для разработки и тестирования.
Часто задаваемые вопросы
Что такое AI Resume Analyzer?
AI Resume Analyzer — это инструмент, который использует искусственный интеллект и машинное обучение для оценки и оптимизации резюме. Он помогает пользователям понять, насколько их резюме соответствует конкретным описаниям вакансий, и дает рекомендации по его улучшению. Цель — повысить эффективность резюме в привлечении внимания рекрутеров и менеджеров по найму.
Зачем использовать AI Resume Analyzer?
Использование анализатора резюме на базе искусственного интеллекта дает множество преимуществ. Он предоставляет объективную обратную связь по содержанию, структуре и ключевым словам резюме, обеспечивая соответствие конкретным требованиям вакансии. Это увеличивает шансы пройти первичный отбор и привлечь внимание рекрутера. Кроме того, он экономит время за счет автоматизации анализа, который в противном случае потребовал бы ручного просмотра и сравнения.
Как работает AI Resume Analyzer?
Анализатор резюме на базе искусственного интеллекта извлекает текст как из резюме, так и из описаний вакансий. Затем он использует технологии обработки естественного языка (NLP) и машинного обучения для анализа текста, выявления релевантных ключевых слов, оценки соответствия навыков и опыта, а также оценки общей структуры и форматирования. На основе этого анализа инструмент генерирует оценки или отчеты, в которых выделяются сильные стороны резюме и области, требующие улучшения.
Каковы ключевые компоненты полнофункционального AI Resume Analyzer?
Полнофункциональный AI Resume Analyzer обычно состоит из трех основных компонентов: фронтенда, бэкенда и AI-движка. Фронтенд, обычно созданный с использованием таких технологий, как React, предоставляет пользовательские интерфейсы для загрузки резюме и описаний вакансий, а также отображает результаты анализа. Бэкенд, часто разработанный с использованием Python и Flask, обрабатывает файлы, анализирует данные и обеспечивает связь между фронтендом и AI-движком. AI-движок использует технологии машинного обучения и NLP для извлечения, анализа и сравнения текста, предоставляя рекомендации по оптимизации резюме.
Какие технологии используются для создания AI Resume Analyzer?
Создание AI-анализатора резюме сочетает в себе технологии фронтенда, бэкенда и искусственного интеллекта. Фронтенд-технологии включают React, HTML, CSS и JavaScript. Бэкенд-технологии обычно включают Python, Flask и фреймворки для разработки API. Технологии, связанные с ИИ, включают библиотеки машинного обучения, такие как scikit-learn, библиотеки обработки естественного языка, такие как NLTK и spaCy, а также инструменты для извлечения текста из PDF/DOCX, такие как PyPDF2 и python-docx. Кроме того, для развертывания и масштабирования могут использоваться облачные платформы, такие как AWS, Google Cloud или Azure.
Связанные вопросы
Как я могу улучшить свое резюме на основе отзывов анализатора?
Улучшение резюме на основе отзывов AI Resume Analyzer включает в себя несколько шагов. Во-первых, внимательно просмотрите отчет анализатора, обратив внимание на выделенные области, требующие улучшения. Определите отсутствующие ключевые слова, несоответствующие навыки и структурные проблемы. Затем обновите свое резюме, чтобы устранить эти проблемы, включив в него соответствующие ключевые слова из описания должности, переформулировав разделы, чтобы они лучше соответствовали желаемым квалификациям, и улучшив общую структуру и форматирование. Наконец, запустите анализ заново, чтобы убедиться, что изменения улучшили оценку резюме и соответствие описанию должности.
Связанная статья
 Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ
Сэм Альтман вызывает споры о замедлении развития ИИ
Слушайте наApple PodcastsСлушайте наSpotifyГенеральный директор OpenAI Сэм Алтман недавно предположил, что, возможно, пришло время «сдерживать темпы развития ИИ», чтобы позволить обществу «укрепиться вокруг некоторых из этих новых уровней возможност
Рекомендации по связанным специальным темам
Бизнес
 Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
 9 инструментов
 xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai
код
Инструменты на базе ИИ для проверки пулл-реквестов в командах GitHub, занимающихся рефакторингом, устранением ошибок и устранением уязвимостей
2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai
Преобразование текста в речь
Лучшие инструменты преобразования текста в речь на базе ИИ для создания естественного озвучивания
2026 года: самые новые, лучшие и высокооцененные инструменты преобразования текста в речь на базе ИИ для естественного озвучивания — уже здесь, на XIX.AI! В этом тщательно отобранном списке представлены мощные, революционные решения, обеспечивающие кристально чистый голос для любого сценария использования, подтвержденные реальными тестами и еженедельно обновляемым рейтингом. Воспользуйтесь сравнением бесплатных и платных версий, чтобы найти решение, которое обязательно стоит попробовать и которое мгновенно повысит вашу продуктивность. Откройте для себя все возможности ИИ прямо сейчас!
11 инструментов
xix.ai

 Комментарии (0)
На современном конкурентном рынке труда важно иметь выделяющееся резюме. AI Resume Analyzer может оптимизировать ваше резюме, сравнивая его непосредственно с конкретными описаниями вакансий. В этой статье вы узнаете, как создать полнофункциональное веб-приложение AI Resume Analyzer, сочетающее Python для бэкэнда, React для фронтэнда и машинное обучение для интеллектуального анализа. Узнайте, как повысить вероятность успеха при поиске работы, понимая, насколько ваше резюме соответствует целевым должностям. В этом руководстве представлены сведения об анализе резюме с помощью искусственного интеллекта, машинном обучении и современной веб-разработке.
Ключевые моменты
Настройте среду Python для разработки бэкэнда.
Извлеките текстовое содержание из резюме в формате PDF и описаний должностей в формате DOCX.
Установите необходимые библиотеки Python для искусственного интеллекта и обработки данных.
Разработайте фронтенд на основе React для взаимодействия с пользователем.
Реализуйте логику бэкэнда для анализа резюме.
Сравнить содержание резюме с требованиями описания вакансии.
Визуализировать сильные стороны резюме и оценки соответствия.
Создайте полнофункциональное веб-приложение для улучшения резюме с помощью искусственного интеллекта.
Настройка среды разработки
Начальная настройка среды Python
Перед началом разработки правильно настройте среду Python.
Сначала проверьте, установлен ли Python в вашей системе. Откройте терминал или командную строку и введите python --version. Если Python установлен, отобразится номер версии. Если нет, загрузите и установите Python с официального сайта python.org, выбрав последнюю стабильную версию, совместимую с вашей операционной системой. Правильная настройка среды гарантирует, что вы готовы приступить к программированию.
После установки Python используйте виртуальные среды для отдельного управления зависимостями проекта. Создайте новую папку проекта и инициализируйте виртуальную среду с помощью python -m venv venv. Это изолирует зависимости проекта. Активируйте виртуальную среду, запустив . ./venv/Scripts/activate в Windows или source venv/bin/activate в macOS и Linux. Активация гарантирует, что пакеты, установленные через pip, останутся в пределах этого проекта, предотвращая конфликты с другими проектами.
Создание бэкэнда проекта
После настройки Python создайте специальную папку для бэкэнда вашего проекта.
Откройте эту папку с помощью Visual Studio Code (VS Code). VS Code — это универсальный, широко используемый редактор, предлагающий отличную поддержку разработки на Python, включая подсветку синтаксиса, инструменты отладки и интегрированный доступ к терминалу.
Затем создайте виртуальную среду Python в каталоге вашего проекта. Это изолированное пространство позволяет разделить зависимости проекта, предотвращая конфликты между разными проектами. Чтобы создать среду, откройте терминал VS Code и выполните команду python -m venv venv. Это создаст каталог venv, содержащий интерпретатор Python и вспомогательные файлы.
Активируйте виртуальную среду после ее создания. В Windows используйте .venvScriptsactivate. В macOS или Linux используйте source venv/bin/activate. Активация гарантирует, что все пакеты, установленные через pip, останутся в этой изолированной среде.
Установка необходимых библиотек Python
После настройки виртуальной среды установите необходимые библиотеки Python.
Эти библиотеки предоставляют необходимые инструменты и функции для создания вашего AI Resume Analyzer. Для их установки используйте pip, установщик пакетов Python. Следующая команда устанавливает ключевые пакеты:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Каждая библиотека служит определенным целям:
- Flask: микро-веб-фреймворк для создания конечных точек API.
- filelock: предоставляет механизмы блокировки файлов.
- gensim: позволяет моделировать темы, индексировать документы и находить сходства в больших наборах текстовых данных.
- scikit-learn: комплексная библиотека машинного обучения, предлагающая алгоритмы классификации, регрессии и кластеризации.
- nltk: набор инструментов для символьной и статистической обработки естественного языка.
- NumPy: базовый пакет для численных вычислений в области науки о данных и машинного обучения.
- python-docx: библиотека для создания и обновления файлов Microsoft Word (.docx).
- PyPDF2: библиотека для чтения и обработки файлов PDF.
- requests: библиотека для отправки HTTP-запросов.
- safe-ds-transformers: интегрирует модели трансформаторов Hugging Face с safe-ds.
- setuptools: система управления пакетами для установки других пакетов Python.
- torch: открытая среда машинного обучения PyTorch.
transformers: предоставляет тысячи предварительно обученных моделей для классификации текста, извлечения информации, ответов на вопросы, резюмирования, перевода и генерации текста.
Чтобы обеспечить воспроизводимость среды, зафиксируйте требования в файле
requirements.txtс помощьюpip freeze > requirements.txt. В этом файле перечислены все установленные пакеты и версии, что позволяет воссоздать среду на других машинах или в более поздние сроки.
Извлечение текста из резюме и описаний вакансий
Создание инструмента для извлечения текста
Следующий важный шаг — создание текстового экстрактора, способного читать и извлекать текст как из резюме в формате PDF, так и из описаний вакансий в формате DOCX.
Этот компонент составляет ядро вашего анализатора резюме, позволяя обрабатывать и сравнивать текстовое содержание резюме и объявлений о вакансиях.
Начните с создания нового файла Python с именем text_extractor.py в папке backend. Этот файл будет содержать функции, необходимые для извлечения текста из различных типов документов. Основные библиотеки для этой цели включают python-docx для файлов DOCX и PyPDF2 для файлов PDF.
Начните с импорта необходимых библиотек в начале файла:
import docximport PyPDF2
Извлечение текста из файлов DOCX
Чтобы извлечь текст из файлов DOCX, определите функцию с именем extract_text_from_docx, которая принимает путь к файлу в качестве аргумента. Эта функция открывает файл DOCX, считывает содержимое абзац за абзацем и возвращает объединенный текст. В результате процесса извлечения получается одна строка, содержащая весь текст файла.
Вот код Python для выполнения этой задачи:
def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text
Эта функция открывает файл DOCX с помощью docx.Document(file_path) и проходит по каждому абзацу документа. Текст из каждого абзаца извлекается с помощью para.text, а все извлеченные сегменты объединяются в одну строку с помощью ' '.join(...), разделенные символами новой строки. Это обеспечивает чистый и читаемый извлеченный текст.
Извлечение текста из файлов PDF
Извлечение текста из файлов PDF требует немного другого подхода из-за структуры документов PDF. Определите функцию с именем extract_text_from_pdf, которая принимает путь к файлу в качестве аргумента. Эта функция открывает файл PDF, проходит по каждой странице, извлекает текст и обрабатывает потенциальные проблемы, такие как пустые или нечитаемые страницы.
Вот код на Python для выполнения этой задачи:
def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Эта функция открывает PDF-файл в режиме двоичного чтения («rb») и создает объект PdfReader с помощью PyPDF2.PdfReader(file). Затем функция проходит по каждой странице PDF, извлекая текст с помощью page.extract_text(), и добавляет извлеченный текст к переменной text. Таким образом, весь читаемый текст PDF собирается в одну строку.
Как использовать AI Resume Analyzer
Настройка Python
- Установите Python: посетите сайт python.org и загрузите последнюю стабильную версию для вашей операционной системы.
- Проверьте установку: откройте терминал и введите
python --version. Убедитесь, что отображается номер версии. - Создайте виртуальную среду: перейдите в папку вашего проекта в терминале и выполните
python -m venv venv. - Активируйте среду:
- В Windows запустите
.venvScriptsactivate. - В macOS/Linux запустите
source venv/bin/activate.
- В Windows запустите
- Установите библиотеки: выполните
команду pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers. - Заморозьте требования: Создайте файл
requirements.txtс помощьюpip freeze > requirements.txt.
Использование функций извлечения текста
- Создайте файл
text_extractor.py:- Создайте новый файл с именем
text_extractor.pyв вашем проекте. - Добавьте следующие операторы импорта:
import docximport PyPDF2
- Создайте новый файл с именем
- Напишите функцию DOCX: Скопируйте эту функцию в файл
text_extractor.py:def extract_text_from_docx(file_path):doc = docx.Document(file_path)text = [''.join([para.text for para in doc.paragraphs])]return text - Написать функцию PDF: Скопируйте эту функцию в
text_extractor.py:def extract_text_from_pdf(file_path):text = ""with open(file_path, "rb") as file:reader = PyPDF2.PdfReader(file)for page in reader.pages:text += page.extract_text()return text
Преимущества и недостатки создания анализатора резюме
Плюсы
Повышает вероятность успешного трудоустройства.
Предоставляет объективную обратную связь по содержанию резюме.
Автоматизирует процесс оптимизации резюме.
Экономит время по сравнению с ручным просмотром резюме.
Недостатки
Требует технических знаний в области Python, React и машинного обучения.
Требует создания и поддержания среды разработки.
Требует постоянных обновлений для адаптации к меняющимся тенденциям рынка труда.
Может потребовать значительного времени и ресурсов для разработки и тестирования.
Часто задаваемые вопросы
Что такое AI Resume Analyzer?
AI Resume Analyzer — это инструмент, который использует искусственный интеллект и машинное обучение для оценки и оптимизации резюме. Он помогает пользователям понять, насколько их резюме соответствует конкретным описаниям вакансий, и дает рекомендации по его улучшению. Цель — повысить эффективность резюме в привлечении внимания рекрутеров и менеджеров по найму.
Зачем использовать AI Resume Analyzer?
Использование анализатора резюме на базе искусственного интеллекта дает множество преимуществ. Он предоставляет объективную обратную связь по содержанию, структуре и ключевым словам резюме, обеспечивая соответствие конкретным требованиям вакансии. Это увеличивает шансы пройти первичный отбор и привлечь внимание рекрутера. Кроме того, он экономит время за счет автоматизации анализа, который в противном случае потребовал бы ручного просмотра и сравнения.
Как работает AI Resume Analyzer?
Анализатор резюме на базе искусственного интеллекта извлекает текст как из резюме, так и из описаний вакансий. Затем он использует технологии обработки естественного языка (NLP) и машинного обучения для анализа текста, выявления релевантных ключевых слов, оценки соответствия навыков и опыта, а также оценки общей структуры и форматирования. На основе этого анализа инструмент генерирует оценки или отчеты, в которых выделяются сильные стороны резюме и области, требующие улучшения.
Каковы ключевые компоненты полнофункционального AI Resume Analyzer?
Полнофункциональный AI Resume Analyzer обычно состоит из трех основных компонентов: фронтенда, бэкенда и AI-движка. Фронтенд, обычно созданный с использованием таких технологий, как React, предоставляет пользовательские интерфейсы для загрузки резюме и описаний вакансий, а также отображает результаты анализа. Бэкенд, часто разработанный с использованием Python и Flask, обрабатывает файлы, анализирует данные и обеспечивает связь между фронтендом и AI-движком. AI-движок использует технологии машинного обучения и NLP для извлечения, анализа и сравнения текста, предоставляя рекомендации по оптимизации резюме.
Какие технологии используются для создания AI Resume Analyzer?
Создание AI-анализатора резюме сочетает в себе технологии фронтенда, бэкенда и искусственного интеллекта. Фронтенд-технологии включают React, HTML, CSS и JavaScript. Бэкенд-технологии обычно включают Python, Flask и фреймворки для разработки API. Технологии, связанные с ИИ, включают библиотеки машинного обучения, такие как scikit-learn, библиотеки обработки естественного языка, такие как NLTK и spaCy, а также инструменты для извлечения текста из PDF/DOCX, такие как PyPDF2 и python-docx. Кроме того, для развертывания и масштабирования могут использоваться облачные платформы, такие как AWS, Google Cloud или Azure.
Связанные вопросы
Как я могу улучшить свое резюме на основе отзывов анализатора?
Улучшение резюме на основе отзывов AI Resume Analyzer включает в себя несколько шагов. Во-первых, внимательно просмотрите отчет анализатора, обратив внимание на выделенные области, требующие улучшения. Определите отсутствующие ключевые слова, несоответствующие навыки и структурные проблемы. Затем обновите свое резюме, чтобы устранить эти проблемы, включив в него соответствующие ключевые слова из описания должности, переформулировав разделы, чтобы они лучше соответствовали желаемым квалификациям, и улучшив общую структуру и форматирование. Наконец, запустите анализ заново, чтобы убедиться, что изменения улучшили оценку резюме и соответствие описанию должности.








 Шесть технологических гигантов поддерживают Linux Foundation с суммой $12,5 млн для борьбы с шумом уязвимостей в ИИ
Для борьбы с потоком низкокачественных отчетов о безопасности, генерируемых инструментами автоматизации на базе ИИ, шесть крупных технологических компаний — Anthropic, Amazon (AWS), GitHub, Google, Microsoft и OpenAI — совместно выделили 12,5 млн дол
 Маск рассматривал возможность оставить OpenAI своим детям, пока Альтман давал показания
Утром генеральный директор OpenAI Сэм Альтман выступил в суде, чтобы ответить на иск бывшего сооснователя Илона Маска, оспаривающего корпоративную структуру компании.Когда его спросили об утверждении Маска о том, что другие основатели «похитили благ
 Сэм Альтман вызывает споры о замедлении развития ИИ
Слушайте наApple PodcastsСлушайте наSpotifyГенеральный директор OpenAI Сэм Алтман недавно предположил, что, возможно, пришло время «сдерживать темпы развития ИИ», чтобы позволить обществу «укрепиться вокруг некоторых из этих новых уровней возможност

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

2026 года: лучшие инструменты для проверки пул-реквестов с помощью ИИ для команд GitHub — уже здесь, на XIX.AI! В этом тщательно отобранном списке, получившем высокие оценки, представлены мощные революционные решения, которые оптимизируют рефакторинг, исправление ошибок и выявление уязвимостей в безопасности во всех рабочих процессах команды. Воспользуйтесь сравнением бесплатных и платных инструментов, а также результатами реальных тестов и подробными рейтингами, которые помогут вам найти идеальный инструмент, значительно повышающий производительность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
12 инструментов
xix.ai

2026 года: самые новые, лучшие и высокооцененные инструменты преобразования текста в речь на базе ИИ для естественного озвучивания — уже здесь, на XIX.AI! В этом тщательно отобранном списке представлены мощные, революционные решения, обеспечивающие кристально чистый голос для любого сценария использования, подтвержденные реальными тестами и еженедельно обновляемым рейтингом. Воспользуйтесь сравнением бесплатных и платных версий, чтобы найти решение, которое обязательно стоит попробовать и которое мгновенно повысит вашу продуктивность. Откройте для себя все возможности ИИ прямо сейчас!
11 инструментов
xix.ai












