


 Lar
Como construir um analisador de currículos com IA full stack em 2026? Guia passo a passo.
No competitivo mercado de trabalho atual, um currículo que se destaque é fundamental. Um analisador de currículos com IA pode otimizar seu currículo, comparando-o diretamente com descrições de cargos específicos. Este artigo orienta você na criação de um aplicativo web completo de análise de currículos com IA, combinando Python para o back-end, React para o front-end e aprendizado de máquina para análise inteligente. Aprenda como aumentar sua taxa de sucesso em candidaturas a empregos, entendendo o quanto seu currículo se alinha às funções almejadas. Este guia fornece insights sobre análise de currículos com IA, aprendizado de máquina e desenvolvimento web moderno.
Pontos principais
Configure um ambiente Python para desenvolvimento de back-end.
Extraia o conteúdo de texto de currículos em PDF e descrições de cargos em DOCX.
Instale bibliotecas Python essenciais para IA e processamento de dados.
Desenvolva um front-end baseado em React para interação com o usuário.
Implemente a lógica de back-end para análise de currículos.
Comparar o conteúdo do currículo com os requisitos da descrição do cargo.
Visualizar os pontos fortes do currículo e as pontuações de correspondência.
Crie um aplicativo web full-stack para aprimoramento de currículos com IA.
Configurando o ambiente de desenvolvimento
Configuração inicial do ambiente Python
Antes de iniciar o desenvolvimento, configure corretamente seu ambiente Python.
Primeiro, verifique se o Python está instalado no seu sistema. Abra o terminal ou prompt de comando e digite python --version. Se o Python estiver instalado, o número da versão será exibido. Caso contrário, baixe e instale o Python no site oficial python.org, selecionando a versão estável mais recente compatível com o seu sistema operacional. A configuração adequada do ambiente garante que você esteja pronto para começar a programar.
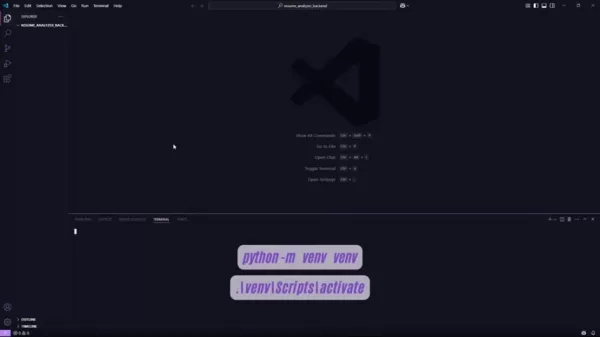
Após instalar o Python, use ambientes virtuais para gerenciar as dependências do projeto separadamente. Crie uma nova pasta de projeto e inicialize um ambiente virtual usando python -m venv venv. Isso isola as dependências do projeto. Ative o ambiente virtual executando . ./venv/Scripts/activate no Windows ou source venv/bin/activate no macOS e Linux. A ativação garante que os pacotes instalados via pip permaneçam contidos neste projeto, evitando conflitos com outros projetos.
Criando o backend do projeto
Com o Python configurado, crie uma pasta dedicada para o back-end do seu projeto.
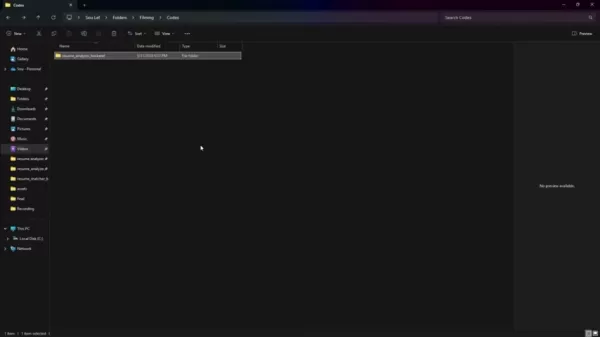
Abra essa pasta usando o Visual Studio Code (VS Code). O VS Code é um editor versátil e amplamente utilizado que oferece excelente suporte ao desenvolvimento em Python, incluindo destaque de sintaxe, ferramentas de depuração e acesso integrado ao terminal.
Em seguida, estabeleça um ambiente virtual Python dentro do diretório do seu projeto. Esse espaço isolado mantém as dependências do projeto separadas, evitando conflitos entre diferentes projetos. Para criar o ambiente, abra o terminal do VS Code e execute python -m venv venv. Isso gera um diretório venv contendo o interpretador Python e os arquivos de suporte.
Ative o ambiente virtual depois de criado. No Windows, use .venvScriptsactivate. No macOS ou Linux, use source venv/bin/activate. A ativação garante que todos os pacotes instalados via pip permaneçam dentro desse ambiente isolado.
Instalando as bibliotecas Python necessárias
Após configurar o ambiente virtual, instale as bibliotecas Python necessárias.
Essas bibliotecas fornecem ferramentas e funcionalidades essenciais para construir seu Analisador de Currículos com IA. Use o pip, o instalador de pacotes do Python, para instalá-las. O comando a seguir instala os pacotes principais:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Cada biblioteca tem uma finalidade específica:
- Flask: uma microestrutura da web para criar pontos finais de API.
- filelock: fornece mecanismos de bloqueio de arquivos.
- gensim: Permite modelagem de tópicos, indexação de documentos e recuperação de similaridades com grandes conjuntos de dados de texto.
- scikit-learn: Uma biblioteca abrangente de aprendizado de máquina que oferece algoritmos de classificação, regressão e agrupamento.
- nltk: Natural Language Toolkit para processamento simbólico e estatístico de linguagem natural.
- NumPy: Pacote fundamental para cálculos numéricos em ciência de dados e aprendizado de máquina.
- python-docx: Biblioteca para criar e atualizar arquivos do Microsoft Word (.docx).
- PyPDF2: Biblioteca para leitura e manipulação de arquivos PDF.
- requests: Biblioteca para envio de solicitações HTTP.
- safe-ds-transformers: Integra modelos de transformadores Hugging Face com safe-ds.
- setuptools: Sistema de gerenciamento de pacotes para instalar outros pacotes Python.
- torch: Framework de aprendizado de máquina de código aberto PyTorch.
transformers: Fornece milhares de modelos pré-treinados para classificação de texto, extração de informações, resposta a perguntas, resumo, tradução e geração de texto.
Para garantir a reprodutibilidade do ambiente, congele os requisitos em um arquivo requirements.txt usando pip freeze > requirements.txt. Esse arquivo lista todos os pacotes e versões instalados, permitindo a recriação do ambiente em outras máquinas ou datas posteriores.
Extraindo texto de currículos e descrições de cargos
Criando o extrator de texto
A próxima etapa crucial envolve a criação de um extrator de texto capaz de ler e extrair texto de currículos em PDF e descrições de vagas em DOCX.
Esse componente forma o núcleo do seu Analisador de Currículos, permitindo o processamento e a comparação do conteúdo textual de currículos e anúncios de vagas.
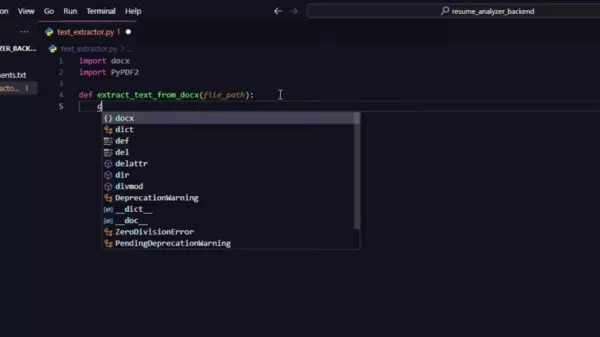
Comece criando um novo arquivo Python chamado text_extractor.py na sua pasta backend. Esse arquivo conterá as funções necessárias para extrair texto de diferentes tipos de documentos. As principais bibliotecas para essa finalidade incluem python-docx para arquivos DOCX e PyPDF2 para arquivos PDF.
Comece importando as bibliotecas necessárias no início do arquivo:
import docximport PyPDF2
Extraindo texto de arquivos DOCX
Para extrair texto de arquivos DOCX, defina uma função chamada extract_text_from_docx que aceite o caminho do arquivo como argumento. Essa função abre o arquivo DOCX, lê o conteúdo parágrafo por parágrafo e retorna o texto combinado. O processo de extração gera uma única string contendo todo o texto do arquivo.
Aqui está o código Python para fazer isso:
def extrair_texto_de_docx(caminho_do_arquivo):doc = docx.Document(caminho_do_arquivo)texto = [''.join([para.text for para in doc.paragraphs])]retornar texto
Esta função abre o arquivo DOCX usando docx.Document(file_path) e itera por cada parágrafo do documento. O texto de cada parágrafo é extraído via para.text, com todos os segmentos extraídos unidos em uma única string usando ' '.join(...), separados por caracteres de nova linha. Isso garante um texto extraído limpo e legível.
Extraindo texto de arquivos PDF
A extração de texto de arquivos PDF requer uma abordagem ligeiramente diferente devido à estrutura do documento PDF. Defina uma função chamada extract_text_from_pdf que aceite o caminho do arquivo como argumento. Essa função abre o arquivo PDF, itera por cada página, extrai o texto e lida com possíveis problemas, como páginas vazias ou ilegíveis.
Aqui está o código Python para fazer isso:
def extrair_texto_de_pdf(caminho_do_arquivo):texto = ""with open(caminho_do_arquivo, "rb") as arquivo:leitor = PyPDF2.PdfReader(arquivo)para página em leitor.páginas:texto += página.extract_text()retornar texto
Essa função abre o arquivo PDF no modo de leitura binária (“rb”) e cria um objeto PdfReader usando PyPDF2.PdfReader(file). Em seguida, a função percorre cada página do PDF, extraindo o texto por meio de page.extract_text(), e anexa o texto extraído à variável text. Isso reúne todo o texto legível do PDF em uma única string.
Como usar o Analisador de Currículos com IA
Configurando o Python
- Instale o Python: acesse python.org e baixe a versão estável mais recente para o seu sistema operacional.
- Verifique a instalação: abra seu terminal e digite
python --version. Confirme se o número da versão aparece. - Crie um ambiente virtual: navegue até a pasta do seu projeto no terminal e execute
python -m venv venv. - Ative o ambiente:
- No Windows, execute
.venvScriptsactivate. - No macOS/Linux, execute
source venv/bin/activate.
- Instale as bibliotecas: Execute
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers. - Congelar requisitos: Crie o arquivo
requirements.txt usando pip freeze > requirements.txt.
Usando funções de extração de texto
- Crie
text_extractor.py:- Crie um novo arquivo chamado
text_extractor.py em seu projeto. - Adicione estas instruções de importação:
import docximport PyPDF2
- Escreva a função DOCX: Copie esta função para
text_extractor.py:def extrair_texto_de_docx(caminho_do_arquivo): doc = docx.Document(caminho_do_arquivo) texto = [''.join([para.text for para in doc.paragraphs])] return texto
- Função Write PDF: Copie esta função para
text_extractor.py:def extrair_texto_de_pdf(caminho_do_arquivo):texto = ""com open(caminho_do_arquivo, "rb") como arquivo:leitor = PyPDF2.PdfReader(arquivo)para página em leitor.páginas:texto += página.extrair_texto()retornar texto
Vantagens e desvantagens de criar um analisador de currículos
Prós
Aumenta as taxas de sucesso nas candidaturas a empregos.
Fornece feedback objetivo sobre o conteúdo do currículo.
Automatiza o processo de otimização do currículo.
Economiza tempo em comparação com as revisões manuais de currículos.
Contras
Requer conhecimento técnico em Python, React e aprendizado de máquina.
Envolve a criação e manutenção de um ambiente de desenvolvimento.
Requer atualizações contínuas para se adaptar às tendências em evolução do mercado de trabalho.
Pode exigir tempo e recursos significativos para desenvolvimento e testes.
Perguntas frequentes
O que é um analisador de currículos com IA?
Um analisador de currículos com IA é uma ferramenta que utiliza inteligência artificial e aprendizado de máquina para avaliar e otimizar currículos. Ele ajuda os usuários a entender o quanto seu currículo se encaixa em descrições de cargos específicas, fornecendo recomendações de melhorias. O objetivo é aumentar a eficácia do currículo para atrair a atenção de recrutadores e gerentes de contratação.
Por que usar um analisador de currículos com IA?
Usar um analisador de currículos com IA oferece vários benefícios. Ele fornece feedback objetivo sobre o conteúdo, a estrutura e as palavras-chave do currículo, garantindo o alinhamento com os requisitos específicos do cargo. Isso aumenta as chances de passar nos processos de triagem inicial e chamar a atenção do recrutador. Além disso, economiza tempo ao automatizar a análise que, de outra forma, exigiria revisão e comparação manuais.
Como funciona o analisador de currículos com IA?
O analisador de currículos com IA opera extraindo texto de currículos e descrições de cargos. Em seguida, ele emprega técnicas de processamento de linguagem natural (NLP) e aprendizado de máquina para analisar o texto, identificar palavras-chave relevantes, avaliar o alinhamento de habilidades e experiência e avaliar a estrutura e formatação geral. Com base nessa análise, a ferramenta gera pontuações ou relatórios destacando os pontos fortes e as áreas de melhoria do currículo.
Quais são os principais componentes de um AI Resume Analyzer full-stack?
Um Analisador de Currículos com IA completo normalmente compreende três componentes principais: front-end, back-end e mecanismo de IA. O front-end, geralmente construído com tecnologias como React, fornece interfaces de usuário para o upload de currículos e descrições de cargos, enquanto exibe os resultados da análise. O backend, frequentemente desenvolvido com Python e Flask, lida com o processamento de arquivos, análise de dados e comunicação entre o frontend e o mecanismo de IA. O mecanismo de IA utiliza técnicas de aprendizado de máquina e NLP para extrair, analisar e comparar textos, fornecendo insights e recomendações para otimização do currículo.
Quais tecnologias são usadas para construir um analisador de currículos com IA?
A construção de um analisador de currículos com IA combina tecnologias de front-end, back-end e relacionadas à IA. As tecnologias de front-end incluem React, HTML, CSS e JavaScript. As tecnologias de back-end geralmente envolvem Python, Flask e estruturas de desenvolvimento de API. As tecnologias relacionadas à IA abrangem bibliotecas de aprendizado de máquina como scikit-learn, bibliotecas de processamento de linguagem natural como NLTK e spaCy e ferramentas de extração de texto PDF/DOCX como PyPDF2 e python-docx. Além disso, plataformas em nuvem como AWS, Google Cloud ou Azure podem ser utilizadas para implantação e escalabilidade.
Perguntas relacionadas
Como posso melhorar meu currículo com base no feedback do analisador?
Melhorar seu currículo com base no feedback do Analisador de Currículos com IA envolve várias etapas. Primeiro, analise cuidadosamente o relatório do analisador, observando as áreas de melhoria destacadas. Identifique palavras-chave ausentes, habilidades desalinhadas e problemas estruturais. Em seguida, atualize seu currículo para resolver essas questões, incorporando palavras-chave relevantes da descrição do cargo, reformulando seções para melhor se alinhar às qualificações desejadas e aprimorando a estrutura e a formatação geral. Por fim, execute a análise novamente para verificar se as alterações melhoraram as pontuações do currículo e o alinhamento com a descrição do cargo.
Artigo relacionado
 Musk Considerou Deixar a OpenAI Para Seus Filhos Enquanto Altman Presta Testemunho
Esta manhã, o CEO da OpenAI, Sam Altman, prestou depoimento para responder à ação judicial movida pelo ex-cofundador Elon Musk, que questiona a estrutura corporativa da empresa.Quando questionado sobre a alegação de Musk de que outros fundadores “ro
Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
A Anthropic abre as portas para a Agência de Cibersegurança da UE à medida que o modelo Mythos5 enfrenta o exame de conformidade
Os regulamentos de conformidade da inteligência artificial estão avançando significativamente. A principal empresa de IA, Anthropic, concedeu oficialmente à autoridade de cibersegurança da União Europeia acesso ao seu modelo de IA Mythos, uma medida
Recomendações de tópicos especiais relacionados
Edição de imagem
 Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
 10 ferramentas
 xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai
Educação e Aprendizagem
Plataformas de Construção de Questionários de IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes
2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai
código
Ferramentas de revisão de pull requests com IA para equipes do GitHub que lidam com refatorações, bugs e falhas de segurança
As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai
Conversão de texto para fala
As melhores ferramentas de conversão de texto em fala com IA para narrações com voz natural
As melhores e mais bem avaliadas ferramentas de conversão de texto em fala com IA de 2026 para dublagens naturais estão aqui no XIX.AI! Esta lista selecionada apresenta opções poderosas e revolucionárias que oferecem vozes cristalinas para todos os tipos de uso, respaldadas por testes reais e rankings atualizados semanalmente. Veja uma comparação entre versões gratuitas e pagas para encontrar a solução imperdível que aumentará sua produtividade instantaneamente. Explore agora para aproveitar toda a vantagem da IA!
11 ferramentas
xix.ai
Criação de quadrinhos
Geradores de plano de fundo com IA para mangás: capítulos em série, capas e ilustrações promocionais
2026: Os melhores geradores de fundos para mangá com IA – Classificação dos mais bem avaliados! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias, perfeitas para criar fundos de capítulos, capas de livros e artes promocionais de alta qualidade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Veja uma comparação entre versões gratuitas e pagas, além de informações detalhadas. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA na criação de mangás.
6 ferramentas
xix.ai

 Comentários (0)
No competitivo mercado de trabalho atual, um currículo que se destaque é fundamental. Um analisador de currículos com IA pode otimizar seu currículo, comparando-o diretamente com descrições de cargos específicos. Este artigo orienta você na criação de um aplicativo web completo de análise de currículos com IA, combinando Python para o back-end, React para o front-end e aprendizado de máquina para análise inteligente. Aprenda como aumentar sua taxa de sucesso em candidaturas a empregos, entendendo o quanto seu currículo se alinha às funções almejadas. Este guia fornece insights sobre análise de currículos com IA, aprendizado de máquina e desenvolvimento web moderno.
Pontos principais
Configure um ambiente Python para desenvolvimento de back-end.
Extraia o conteúdo de texto de currículos em PDF e descrições de cargos em DOCX.
Instale bibliotecas Python essenciais para IA e processamento de dados.
Desenvolva um front-end baseado em React para interação com o usuário.
Implemente a lógica de back-end para análise de currículos.
Comparar o conteúdo do currículo com os requisitos da descrição do cargo.
Visualizar os pontos fortes do currículo e as pontuações de correspondência.
Crie um aplicativo web full-stack para aprimoramento de currículos com IA.
Configurando o ambiente de desenvolvimento
Configuração inicial do ambiente Python
Antes de iniciar o desenvolvimento, configure corretamente seu ambiente Python.
Primeiro, verifique se o Python está instalado no seu sistema. Abra o terminal ou prompt de comando e digite python --version. Se o Python estiver instalado, o número da versão será exibido. Caso contrário, baixe e instale o Python no site oficial python.org, selecionando a versão estável mais recente compatível com o seu sistema operacional. A configuração adequada do ambiente garante que você esteja pronto para começar a programar.
Após instalar o Python, use ambientes virtuais para gerenciar as dependências do projeto separadamente. Crie uma nova pasta de projeto e inicialize um ambiente virtual usando python -m venv venv. Isso isola as dependências do projeto. Ative o ambiente virtual executando . ./venv/Scripts/activate no Windows ou source venv/bin/activate no macOS e Linux. A ativação garante que os pacotes instalados via pip permaneçam contidos neste projeto, evitando conflitos com outros projetos.
Criando o backend do projeto
Com o Python configurado, crie uma pasta dedicada para o back-end do seu projeto.
Abra essa pasta usando o Visual Studio Code (VS Code). O VS Code é um editor versátil e amplamente utilizado que oferece excelente suporte ao desenvolvimento em Python, incluindo destaque de sintaxe, ferramentas de depuração e acesso integrado ao terminal.
Em seguida, estabeleça um ambiente virtual Python dentro do diretório do seu projeto. Esse espaço isolado mantém as dependências do projeto separadas, evitando conflitos entre diferentes projetos. Para criar o ambiente, abra o terminal do VS Code e execute python -m venv venv. Isso gera um diretório venv contendo o interpretador Python e os arquivos de suporte.
Ative o ambiente virtual depois de criado. No Windows, use .venvScriptsactivate. No macOS ou Linux, use source venv/bin/activate. A ativação garante que todos os pacotes instalados via pip permaneçam dentro desse ambiente isolado.
Instalando as bibliotecas Python necessárias
Após configurar o ambiente virtual, instale as bibliotecas Python necessárias.
Essas bibliotecas fornecem ferramentas e funcionalidades essenciais para construir seu Analisador de Currículos com IA. Use o pip, o instalador de pacotes do Python, para instalá-las. O comando a seguir instala os pacotes principais:
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers
Cada biblioteca tem uma finalidade específica:
- Flask: uma microestrutura da web para criar pontos finais de API.
- filelock: fornece mecanismos de bloqueio de arquivos.
- gensim: Permite modelagem de tópicos, indexação de documentos e recuperação de similaridades com grandes conjuntos de dados de texto.
- scikit-learn: Uma biblioteca abrangente de aprendizado de máquina que oferece algoritmos de classificação, regressão e agrupamento.
- nltk: Natural Language Toolkit para processamento simbólico e estatístico de linguagem natural.
- NumPy: Pacote fundamental para cálculos numéricos em ciência de dados e aprendizado de máquina.
- python-docx: Biblioteca para criar e atualizar arquivos do Microsoft Word (.docx).
- PyPDF2: Biblioteca para leitura e manipulação de arquivos PDF.
- requests: Biblioteca para envio de solicitações HTTP.
- safe-ds-transformers: Integra modelos de transformadores Hugging Face com safe-ds.
- setuptools: Sistema de gerenciamento de pacotes para instalar outros pacotes Python.
- torch: Framework de aprendizado de máquina de código aberto PyTorch.
transformers: Fornece milhares de modelos pré-treinados para classificação de texto, extração de informações, resposta a perguntas, resumo, tradução e geração de texto.
Para garantir a reprodutibilidade do ambiente, congele os requisitos em um arquivo
requirements.txtusandopip freeze > requirements.txt. Esse arquivo lista todos os pacotes e versões instalados, permitindo a recriação do ambiente em outras máquinas ou datas posteriores.
Extraindo texto de currículos e descrições de cargos
Criando o extrator de texto
A próxima etapa crucial envolve a criação de um extrator de texto capaz de ler e extrair texto de currículos em PDF e descrições de vagas em DOCX.
Esse componente forma o núcleo do seu Analisador de Currículos, permitindo o processamento e a comparação do conteúdo textual de currículos e anúncios de vagas.
Comece criando um novo arquivo Python chamado text_extractor.py na sua pasta backend. Esse arquivo conterá as funções necessárias para extrair texto de diferentes tipos de documentos. As principais bibliotecas para essa finalidade incluem python-docx para arquivos DOCX e PyPDF2 para arquivos PDF.
Comece importando as bibliotecas necessárias no início do arquivo:
import docximport PyPDF2
Extraindo texto de arquivos DOCX
Para extrair texto de arquivos DOCX, defina uma função chamada extract_text_from_docx que aceite o caminho do arquivo como argumento. Essa função abre o arquivo DOCX, lê o conteúdo parágrafo por parágrafo e retorna o texto combinado. O processo de extração gera uma única string contendo todo o texto do arquivo.
Aqui está o código Python para fazer isso:
def extrair_texto_de_docx(caminho_do_arquivo):doc = docx.Document(caminho_do_arquivo)texto = [''.join([para.text for para in doc.paragraphs])]retornar texto
Esta função abre o arquivo DOCX usando docx.Document(file_path) e itera por cada parágrafo do documento. O texto de cada parágrafo é extraído via para.text, com todos os segmentos extraídos unidos em uma única string usando ' '.join(...), separados por caracteres de nova linha. Isso garante um texto extraído limpo e legível.
Extraindo texto de arquivos PDF
A extração de texto de arquivos PDF requer uma abordagem ligeiramente diferente devido à estrutura do documento PDF. Defina uma função chamada extract_text_from_pdf que aceite o caminho do arquivo como argumento. Essa função abre o arquivo PDF, itera por cada página, extrai o texto e lida com possíveis problemas, como páginas vazias ou ilegíveis.
Aqui está o código Python para fazer isso:
def extrair_texto_de_pdf(caminho_do_arquivo):texto = ""with open(caminho_do_arquivo, "rb") as arquivo:leitor = PyPDF2.PdfReader(arquivo)para página em leitor.páginas:texto += página.extract_text()retornar texto
Essa função abre o arquivo PDF no modo de leitura binária (“rb”) e cria um objeto PdfReader usando PyPDF2.PdfReader(file). Em seguida, a função percorre cada página do PDF, extraindo o texto por meio de page.extract_text(), e anexa o texto extraído à variável text. Isso reúne todo o texto legível do PDF em uma única string.
Como usar o Analisador de Currículos com IA
Configurando o Python
- Instale o Python: acesse python.org e baixe a versão estável mais recente para o seu sistema operacional.
- Verifique a instalação: abra seu terminal e digite
python --version. Confirme se o número da versão aparece. - Crie um ambiente virtual: navegue até a pasta do seu projeto no terminal e execute
python -m venv venv. - Ative o ambiente:
- No Windows, execute
.venvScriptsactivate. - No macOS/Linux, execute
source venv/bin/activate.
- No Windows, execute
- Instale as bibliotecas: Execute
pip install Flask filelock genism scikit-learn nltk numpy python-docx PyPDF2 requests safe-ds-transformers setuptools torch transformers. - Congelar requisitos: Crie o arquivo
requirements.txtusandopip freeze > requirements.txt.
Usando funções de extração de texto
- Crie
text_extractor.py:- Crie um novo arquivo chamado
text_extractor.pyem seu projeto. - Adicione estas instruções de importação:
import docximport PyPDF2
- Crie um novo arquivo chamado
- Escreva a função DOCX: Copie esta função para
text_extractor.py:def extrair_texto_de_docx(caminho_do_arquivo): doc = docx.Document(caminho_do_arquivo) texto = [''.join([para.text for para in doc.paragraphs])] return texto - Função Write PDF: Copie esta função para
text_extractor.py:def extrair_texto_de_pdf(caminho_do_arquivo):texto = ""com open(caminho_do_arquivo, "rb") como arquivo:leitor = PyPDF2.PdfReader(arquivo)para página em leitor.páginas:texto += página.extrair_texto()retornar texto
Vantagens e desvantagens de criar um analisador de currículos
Prós
Aumenta as taxas de sucesso nas candidaturas a empregos.
Fornece feedback objetivo sobre o conteúdo do currículo.
Automatiza o processo de otimização do currículo.
Economiza tempo em comparação com as revisões manuais de currículos.
Contras
Requer conhecimento técnico em Python, React e aprendizado de máquina.
Envolve a criação e manutenção de um ambiente de desenvolvimento.
Requer atualizações contínuas para se adaptar às tendências em evolução do mercado de trabalho.
Pode exigir tempo e recursos significativos para desenvolvimento e testes.
Perguntas frequentes
O que é um analisador de currículos com IA?
Um analisador de currículos com IA é uma ferramenta que utiliza inteligência artificial e aprendizado de máquina para avaliar e otimizar currículos. Ele ajuda os usuários a entender o quanto seu currículo se encaixa em descrições de cargos específicas, fornecendo recomendações de melhorias. O objetivo é aumentar a eficácia do currículo para atrair a atenção de recrutadores e gerentes de contratação.
Por que usar um analisador de currículos com IA?
Usar um analisador de currículos com IA oferece vários benefícios. Ele fornece feedback objetivo sobre o conteúdo, a estrutura e as palavras-chave do currículo, garantindo o alinhamento com os requisitos específicos do cargo. Isso aumenta as chances de passar nos processos de triagem inicial e chamar a atenção do recrutador. Além disso, economiza tempo ao automatizar a análise que, de outra forma, exigiria revisão e comparação manuais.
Como funciona o analisador de currículos com IA?
O analisador de currículos com IA opera extraindo texto de currículos e descrições de cargos. Em seguida, ele emprega técnicas de processamento de linguagem natural (NLP) e aprendizado de máquina para analisar o texto, identificar palavras-chave relevantes, avaliar o alinhamento de habilidades e experiência e avaliar a estrutura e formatação geral. Com base nessa análise, a ferramenta gera pontuações ou relatórios destacando os pontos fortes e as áreas de melhoria do currículo.
Quais são os principais componentes de um AI Resume Analyzer full-stack?
Um Analisador de Currículos com IA completo normalmente compreende três componentes principais: front-end, back-end e mecanismo de IA. O front-end, geralmente construído com tecnologias como React, fornece interfaces de usuário para o upload de currículos e descrições de cargos, enquanto exibe os resultados da análise. O backend, frequentemente desenvolvido com Python e Flask, lida com o processamento de arquivos, análise de dados e comunicação entre o frontend e o mecanismo de IA. O mecanismo de IA utiliza técnicas de aprendizado de máquina e NLP para extrair, analisar e comparar textos, fornecendo insights e recomendações para otimização do currículo.
Quais tecnologias são usadas para construir um analisador de currículos com IA?
A construção de um analisador de currículos com IA combina tecnologias de front-end, back-end e relacionadas à IA. As tecnologias de front-end incluem React, HTML, CSS e JavaScript. As tecnologias de back-end geralmente envolvem Python, Flask e estruturas de desenvolvimento de API. As tecnologias relacionadas à IA abrangem bibliotecas de aprendizado de máquina como scikit-learn, bibliotecas de processamento de linguagem natural como NLTK e spaCy e ferramentas de extração de texto PDF/DOCX como PyPDF2 e python-docx. Além disso, plataformas em nuvem como AWS, Google Cloud ou Azure podem ser utilizadas para implantação e escalabilidade.
Perguntas relacionadas
Como posso melhorar meu currículo com base no feedback do analisador?
Melhorar seu currículo com base no feedback do Analisador de Currículos com IA envolve várias etapas. Primeiro, analise cuidadosamente o relatório do analisador, observando as áreas de melhoria destacadas. Identifique palavras-chave ausentes, habilidades desalinhadas e problemas estruturais. Em seguida, atualize seu currículo para resolver essas questões, incorporando palavras-chave relevantes da descrição do cargo, reformulando seções para melhor se alinhar às qualificações desejadas e aprimorando a estrutura e a formatação geral. Por fim, execute a análise novamente para verificar se as alterações melhoraram as pontuações do currículo e o alinhamento com a descrição do cargo.








 Musk Considerou Deixar a OpenAI Para Seus Filhos Enquanto Altman Presta Testemunho
Esta manhã, o CEO da OpenAI, Sam Altman, prestou depoimento para responder à ação judicial movida pelo ex-cofundador Elon Musk, que questiona a estrutura corporativa da empresa.Quando questionado sobre a alegação de Musk de que outros fundadores “ro
 Sam Altman Gera Debate Sobre a Desaceleração da IA
Escute noApple PodcastsEscute noSpotifyO CEO da OpenAI, Sam Altman, sugeriu recentemente que pode ser hora de “controlar o ritmo do desenvolvimento de IA” para permitir que a sociedade “se fortaleça em torno de alguns desses novos níveis de capacida
 A Anthropic abre as portas para a Agência de Cibersegurança da UE à medida que o modelo Mythos5 enfrenta o exame de conformidade
Os regulamentos de conformidade da inteligência artificial estão avançando significativamente. A principal empresa de IA, Anthropic, concedeu oficialmente à autoridade de cibersegurança da União Europeia acesso ao seu modelo de IA Mythos, uma medida

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para revisão de pull requests com IA para equipes do GitHub estão aqui no XIX.AI! Esta lista selecionada e com as melhores avaliações apresenta soluções poderosas e revolucionárias que otimizam a refatoração, a correção de bugs e a detecção de falhas de segurança em todos os fluxos de trabalho das equipes. Aproveite uma comparação entre versões gratuitas e pagas, além de testes reais e classificações detalhadas para ajudá-lo a encontrar a ferramenta perfeita que aumenta significativamente a produtividade. Explore agora para descobrir sua vantagem com IA!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de conversão de texto em fala com IA de 2026 para dublagens naturais estão aqui no XIX.AI! Esta lista selecionada apresenta opções poderosas e revolucionárias que oferecem vozes cristalinas para todos os tipos de uso, respaldadas por testes reais e rankings atualizados semanalmente. Veja uma comparação entre versões gratuitas e pagas para encontrar a solução imperdível que aumentará sua produtividade instantaneamente. Explore agora para aproveitar toda a vantagem da IA!
11 ferramentas
xix.ai

2026: Os melhores geradores de fundos para mangá com IA – Classificação dos mais bem avaliados! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias, perfeitas para criar fundos de capítulos, capas de livros e artes promocionais de alta qualidade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Veja uma comparação entre versões gratuitas e pagas, além de informações detalhadas. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo as vantagens da IA na criação de mangás.
6 ferramentas
xix.ai












