


 首页
优化AI模型选择以实现现实世界性能
企业必须确保其驱动应用的AI模型在现实世界场景中有效运行。预测这些场景可能具有挑战性,使评估复杂化。更新后的RewardBench 2基准为组织提供了更清晰的模型实际性能洞察。
艾伦人工智能研究所(Ai2)推出了RewardBench 2,这是其RewardBench基准的增强版,旨在全面评估模型性能以及与企业目标的契合度。
Ai2开发了RewardBench,包含分类任务,通过推理时计算和下游训练评估相关性。RewardBench专注于奖励模型(RMs),这些模型通过分配分数或“奖励”来判断大型语言模型输出,以指导基于人类反馈的强化学习(RHLF)。
RewardBench 2来了!我们花了很长时间从首个奖励模型评估工具中学习,打造了一个难度大幅提升、与下游RLHF和推理时扩展更相关的工具。pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025年6月2日
Ai2高级研究科学家Nathan Lambert对VentureBeat表示,最初的RewardBench表现良好,但模型环境的演变要求更新基准。
“随着奖励模型变得更复杂,用例更复杂,我们与社区一起发现,第一版未能完全解决现实世界中人类偏好的复杂性,”他解释道。
Lambert指出,RewardBench 2改进了评估范围和深度,纳入了多样化、具有挑战性的提示和优化方法,以更好地反映人类对AI输出的判断。它包括新的人类提示、更严格的评分系统和额外领域。
利用评估进行模型评估
奖励模型评估模型性能,但与公司价值观的契合至关重要。未对齐的奖励模型可能放大幻觉、降低泛化能力或在微调和强化学习中过度偏向有害响应。
RewardBench 2涵盖六个领域:事实性、精确指令遵循、数学、安全性、专注度和关联性。
“企业可根据需求以两种方式使用RewardBench 2。对于RLHF,应将顶级模型的最佳实践和数据集整合到其流程中,因为奖励模型需要在线训练。对于推理时扩展或数据过滤,RewardBench 2帮助选择与其领域性能相关的最佳模型,”Lambert说。
Lambert强调,像RewardBench这样的基准允许用户根据最相关的优先级评估模型,而非通用分数。他指出,性能是主观的,与用户背景和目标密切相关,人类偏好往往非常微妙。
Ai2于2024年3月推出原始RewardBench,称其为首个奖励模型基准和排行榜。此后,出现了Meta的FAIR reWordBench和DeepSeek的自我原则批判调优等新方法,用于更智能、可扩展的奖励模型。
非常兴奋我们的第二个奖励模型评估发布。它难度大幅提升,更清晰,与下游PPO/BoN采样高度相关。
祝爬坡愉快!
衷心祝贺@saumyamalik44,她以卓越的承诺领导了这个项目。https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2025年6月2日
模型性能洞察
通过RewardBench 2,Ai2测试了现有和新训练的模型,包括Gemini、Claude、GPT-4.1和Llama-3.1的变体,以及Qwen、Skywork和Tulu等数据集和模型。
结果显示,较大的奖励模型因更强大的基础模型而表现优异。Llama-3.1 Instruct变体在基准测试中名列前茅,Skywork数据有助于专注度和安全性,Tulu在事实性方面表现良好。
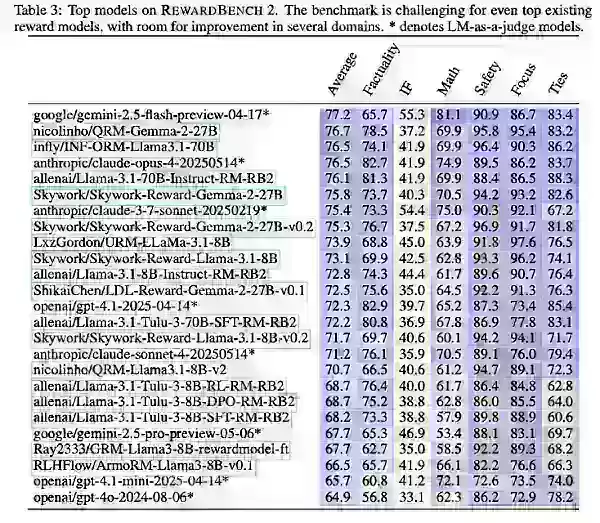
Ai2指出,虽然RewardBench 2推动了多领域、注重准确性的奖励模型评估,但企业应主要用它来选择最适合其特定需求的模型。
相关文章
 美国股市触及历史里程碑,人工智能与航空航天巨头准备开启万亿美元时代
埃隆·马斯克、山姆·阿尔特曼和达里奥·阿莫迪,这三位科技领域的巨头,正推动其各自的企业迈向首次公开募股(IPO)。随着 SpaceX、OpenAI 和 Anthropic——这三家估值接近万亿美元的行业巨头——即将上市,2026 年被预测将成为美国历史上新股发行规模最大的一年。这一历史性的资本激增已引起全球金融界的关注,成为检验公共市场吸收如此大规模资金能力的关键压力测试。这些主要融资活动的同步启动预计将打破 2021 年创下的 1560 亿美元纪录。超级独角兽的资本博弈每家公司上市的路径
瑞典人工智能初创公司Lovable Eyes在完成主要融资轮后估值达132亿美元
随着人工智能驱动的编码工具日益普及,瑞典初创公司 Lovable 已获一轮重大融资。该公司计划筹集 30 亿美元,其估值有望升至 132 亿美元——这是去年 12 月记录的 66 亿美元的两倍。预计 Menlo Ventures 将主导此次投资。Lovable 的吸引力源于其核心的“氛围编码”(vibe coding)技术,该技术通过消除对复杂编码技能的需求来简化软件开发。用户只需以自然语言描述其需求,系统即可自动生成应用程序。这种直观的方法吸引了个人开发者、设计师和小企业,并扩展至 Work
Google 测试 Remy AI 代理,以 Gemini 为重点转向用户控制
根据《商业内幕》的报道,谷歌正在测试 Remy,这是 Gemini 的一款全新 AI 个人代理工具。该工具旨在代表用户执行任务,从而简化专业工作流程和日常事务。目前,Remy 正在 Gemini 应用的内部员工专属版本中进行测试。该报告引用了一份内部文件以及对两位熟悉该项目的个人的采访。内部资料将 Remy 描述为“全天候个人代理”,将 Gemini 定位为能够代表用户行事的主动助手。接近该项目的消息人士证实,谷歌员工正在积极测试 Remy。谷歌发言人拒绝提供进一步评论。该报告未提及公开发布
相关专题推荐
数据分析
 适用于 SaaS 和电商团队的 KPI 监控最佳 AI 异常检测工具
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
 10 个工具
 xix.ai
写作
最适合撰写长篇SEO文章的AI大纲生成器
2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai
教育与学习
用于作业和考试备考的AI学习工具
2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai
音乐创作
面向词曲创作者、旋律片段、主旋律及多语言草稿创作的AI人声演示工具
2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai
商业
适合中小企业的最佳AI竞品分析工具
2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai
图像编辑
用于电商服装、皮肤清洁和色彩一致性的 Photoshop AI 修图工具
2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

 评论 (3)
0/500
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
企业必须确保其驱动应用的AI模型在现实世界场景中有效运行。预测这些场景可能具有挑战性,使评估复杂化。更新后的RewardBench 2基准为组织提供了更清晰的模型实际性能洞察。
艾伦人工智能研究所(Ai2)推出了RewardBench 2,这是其RewardBench基准的增强版,旨在全面评估模型性能以及与企业目标的契合度。
Ai2开发了RewardBench,包含分类任务,通过推理时计算和下游训练评估相关性。RewardBench专注于奖励模型(RMs),这些模型通过分配分数或“奖励”来判断大型语言模型输出,以指导基于人类反馈的强化学习(RHLF)。
RewardBench 2来了!我们花了很长时间从首个奖励模型评估工具中学习,打造了一个难度大幅提升、与下游RLHF和推理时扩展更相关的工具。pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025年6月2日
Ai2高级研究科学家Nathan Lambert对VentureBeat表示,最初的RewardBench表现良好,但模型环境的演变要求更新基准。
“随着奖励模型变得更复杂,用例更复杂,我们与社区一起发现,第一版未能完全解决现实世界中人类偏好的复杂性,”他解释道。
Lambert指出,RewardBench 2改进了评估范围和深度,纳入了多样化、具有挑战性的提示和优化方法,以更好地反映人类对AI输出的判断。它包括新的人类提示、更严格的评分系统和额外领域。
利用评估进行模型评估
奖励模型评估模型性能,但与公司价值观的契合至关重要。未对齐的奖励模型可能放大幻觉、降低泛化能力或在微调和强化学习中过度偏向有害响应。
RewardBench 2涵盖六个领域:事实性、精确指令遵循、数学、安全性、专注度和关联性。
“企业可根据需求以两种方式使用RewardBench 2。对于RLHF,应将顶级模型的最佳实践和数据集整合到其流程中,因为奖励模型需要在线训练。对于推理时扩展或数据过滤,RewardBench 2帮助选择与其领域性能相关的最佳模型,”Lambert说。
Lambert强调,像RewardBench这样的基准允许用户根据最相关的优先级评估模型,而非通用分数。他指出,性能是主观的,与用户背景和目标密切相关,人类偏好往往非常微妙。
Ai2于2024年3月推出原始RewardBench,称其为首个奖励模型基准和排行榜。此后,出现了Meta的FAIR reWordBench和DeepSeek的自我原则批判调优等新方法,用于更智能、可扩展的奖励模型。
非常兴奋我们的第二个奖励模型评估发布。它难度大幅提升,更清晰,与下游PPO/BoN采样高度相关。
— Nathan Lambert (@natolambert) 2025年6月2日
祝爬坡愉快!
衷心祝贺@saumyamalik44,她以卓越的承诺领导了这个项目。https://t.co/c0b6rHTXY5
模型性能洞察
通过RewardBench 2,Ai2测试了现有和新训练的模型,包括Gemini、Claude、GPT-4.1和Llama-3.1的变体,以及Qwen、Skywork和Tulu等数据集和模型。
结果显示,较大的奖励模型因更强大的基础模型而表现优异。Llama-3.1 Instruct变体在基准测试中名列前茅,Skywork数据有助于专注度和安全性,Tulu在事实性方面表现良好。
Ai2指出,虽然RewardBench 2推动了多领域、注重准确性的奖励模型评估,但企业应主要用它来选择最适合其特定需求的模型。








 美国股市触及历史里程碑,人工智能与航空航天巨头准备开启万亿美元时代
埃隆·马斯克、山姆·阿尔特曼和达里奥·阿莫迪,这三位科技领域的巨头,正推动其各自的企业迈向首次公开募股(IPO)。随着 SpaceX、OpenAI 和 Anthropic——这三家估值接近万亿美元的行业巨头——即将上市,2026 年被预测将成为美国历史上新股发行规模最大的一年。这一历史性的资本激增已引起全球金融界的关注,成为检验公共市场吸收如此大规模资金能力的关键压力测试。这些主要融资活动的同步启动预计将打破 2021 年创下的 1560 亿美元纪录。超级独角兽的资本博弈每家公司上市的路径
 瑞典人工智能初创公司Lovable Eyes在完成主要融资轮后估值达132亿美元
随着人工智能驱动的编码工具日益普及,瑞典初创公司 Lovable 已获一轮重大融资。该公司计划筹集 30 亿美元,其估值有望升至 132 亿美元——这是去年 12 月记录的 66 亿美元的两倍。预计 Menlo Ventures 将主导此次投资。Lovable 的吸引力源于其核心的“氛围编码”(vibe coding)技术,该技术通过消除对复杂编码技能的需求来简化软件开发。用户只需以自然语言描述其需求,系统即可自动生成应用程序。这种直观的方法吸引了个人开发者、设计师和小企业,并扩展至 Work
Google 测试 Remy AI 代理,以 Gemini 为重点转向用户控制
根据《商业内幕》的报道,谷歌正在测试 Remy,这是 Gemini 的一款全新 AI 个人代理工具。该工具旨在代表用户执行任务,从而简化专业工作流程和日常事务。目前,Remy 正在 Gemini 应用的内部员工专属版本中进行测试。该报告引用了一份内部文件以及对两位熟悉该项目的个人的采访。内部资料将 Remy 描述为“全天候个人代理”,将 Gemini 定位为能够代表用户行事的主动助手。接近该项目的消息人士证实,谷歌员工正在积极测试 Remy。谷歌发言人拒绝提供进一步评论。该报告未提及公开发布
2026 年最新最佳顶级评分 AI 异常检测工具,助力 SaaS 和电商团队的 KPI 监控!XIX.AI 基于严格的真实世界测试和每周更新的排名,精心策划了一套强大且颠覆性的工具合集。您将找到详细的免费与付费对比洞察,帮助您识别必须尝试的解决方案,从而提升生产力并释放您的 AI 优势。立即探索!
10 个工具
xix.ai

2026年最新、最受好评的AI大纲生成器,专为长篇SEO文章打造,由XIX.AI精心甄选。这些强大的工具在快速创建高质量内容方面提供了颠覆性的帮助,显著提升了写作效率。 获取免费版与付费版的对比分析,以及实际测试结果和详细排名,助您找到最适合自身需求、不容错过的理想选择。立即探索,解锁您的AI竞争优势。
8 个工具
xix.ai

2026年最新最佳AI学习工具,助您轻松完成作业和备考!XIX.AI精心筛选出一份广受好评的顶级工具清单,这些功能强大、颠覆传统的工具经过实际测试,能帮助学生提升效率、简化作业流程,并轻松通过考试。 获取免费版与付费版的对比分析、详细排名以及必试选项,释放你的AI优势。立即探索!
10 个工具
xix.ai

2026 年最新最佳 AI 人声演示工具,专为词曲创作者、旋律创作者和多语言内容团队打造!XIX.AI 精心整理了一份经过严格真实世界测试的高评分、变革性工具列表。您将找到详细的免费与付费对比数据、全面排名以及必试选项,帮助您提升创作效率并释放创意潜力。立即探索,发现满足您所有内容需求的完美工具!
9 个工具
xix.ai

2026年最新最佳、评价最高的中小企业AI竞争研究工具!XIX.AI精心精选了一系列功能强大、颠覆行业格局的工具,每周都会根据严格的实际测试和详细排名进行更新。您可以查看全面的免费版与付费版对比,从而找到那些能提升工作效率、助您赢得竞争优势的必试工具。 立即探索,发现最适合您的工具!
9 个工具
xix.ai

2026 年最新最佳 Photoshop AI 修图工具,适用于电商服装、皮肤清洁和色彩一致性!这份顶级精选列表包含强大的变革性解决方案,可帮助您提升写作效率、简化内容创作并轻松实现完美的视觉效果。每个工具都经过实际测试,并通过每周更新的排名进行验证,同时提供免费与付费版本的详细对比。由 XIX.AI 支持,这是任何希望发挥 AI 优势的人必试指南。立即探索!
10 个工具
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












