


 Дом
Оптимизация выбора модели ИИ для реальной производительности
Предприятия должны обеспечивать эффективную работу моделей ИИ, управляющих приложениями, в реальных сценариях. Предсказание этих сценариев может быть сложным, что затрудняет оценку. Обновленный бенчмарк RewardBench 2 предоставляет организациям более четкое представление о практической производительности модели.
Институт Аллена по искусственному интеллекту (Ai2) представил RewardBench 2, улучшенную версию своего бенчмарка RewardBench, разработанную для всесторонней оценки производительности модели и соответствия целям предприятия.
Ai2 разработал RewardBench с задачами классификации, которые оценивают корреляции через вычисления во время вывода и последующее обучение. RewardBench фокусируется на моделях вознаграждения (RMs), которые оценивают результаты больших языковых моделей, присваивая баллы или «вознаграждения» для управления обучением с подкреплением на основе человеческой обратной связи (RHLF).
RewardBench 2 здесь! Мы потратили много времени, чтобы извлечь уроки из нашего первого инструмента оценки моделей вознаграждения и создать более сложный и коррелирующий с последующим RLHF и масштабированием во время вывода. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 июня 2025
Натан Ламберт, старший научный сотрудник Ai2, рассказал VentureBeat, что изначально RewardBench работал хорошо, но эволюция модельных сред потребовала обновленных бенчмарков.
«По мере того как модели вознаграждения становились более сложными, а сценарии использования — более комплексными, мы, вместе с сообществом, увидели, что первая версия не полностью учитывала сложности человеческих предпочтений в реальном мире», — объяснил он.
Ламберт отметил, что RewardBench 2 расширяет объем и глубину оценки, включая разнообразные, сложные запросы и усовершенствованные методы, чтобы лучше отражать человеческое суждение о результатах ИИ. Он включает новые человеческие запросы, более строгую систему оценки и дополнительные домены.
Использование оценок для анализа моделей
Модели вознаграждения оценивают производительность моделей, но их соответствие ценностям компании имеет решающее значение. Неправильно выровненные RMs могут усиливать проблемы, такие как галлюцинации, снижать обобщающую способность или чрезмерно благоприятствовать вредным ответам во время тонкой настройки и обучения с подкреплением.
RewardBench 2 охватывает шесть доменов: фактическая точность, точное следование инструкциям, математика, безопасность, фокус и равенство.
«Предприятия могут использовать RewardBench 2 двумя способами в зависимости от их потребностей. Для RLHF они должны интегрировать лучшие практики и наборы данных от топовых моделей в свои процессы, поскольку модели вознаграждения требуют обучения в реальном времени. Для масштабирования во время вывода или фильтрации данных RewardBench 2 помогает выбрать лучшую модель для их домена с коррелирующей производительностью», — сказал Ламберт.
Ламберт подчеркнул, что бенчмарки, такие как RewardBench, позволяют пользователям оценивать модели на основе наиболее важных для них приоритетов, а не общего балла. Он отметил, что производительность субъективна, сильно связана с контекстом и целями пользователя, а человеческие предпочтения часто очень нюансированы.
Ai2 запустил оригинальный RewardBench в марте 2024 года, назвав его первым бенчмарком и таблицей лидеров для моделей вознаграждения. С тех пор появились новые методы, такие как reWordBench от Meta FAIR и Self-Principled Critique Tuning от DeepSeek для более умных и масштабируемых RMs.
Очень рад, что наша вторая оценка моделей вознаграждения вышла. Она значительно сложнее, чище и хорошо коррелирует с последующим PPO/BoN сэмплированием.
Счастливого восхождения на холм!
Огромные поздравления @saumyamalik44, которая руководила проектом с полной приверженностью к совершенству. https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2 июня 2025
Инсайты по производительности моделей
С помощью RewardBench 2 Ai2 протестировал как существующие, так и недавно обученные модели, включая варианты Gemini, Claude, GPT-4.1 и Llama-3.1, а также наборы данных и модели, такие как Qwen, Skywork и Tulu.
Результаты показали, что большие модели вознаграждения превосходят благодаря более сильным базовым моделям. Варианты Llama-3.1 Instruct возглавили бенчмарк, при этом данные Skywork помогли в фокусе и безопасности, а Tulu показал хорошие результаты в фактической точности.
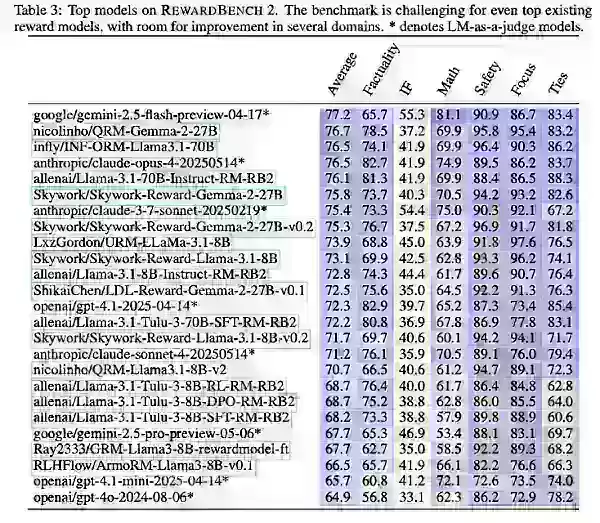
Ai2 отметил, что, хотя RewardBench 2 продвигает многодоменную оценку, ориентированную на точность, для моделей вознаграждения, он в первую очередь должен направлять предприятия в выборе моделей, наиболее подходящих для их конкретных потребностей.
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
Анализ данных
 Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
 10 инструментов
 xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

 Комментарии (3)
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
Предприятия должны обеспечивать эффективную работу моделей ИИ, управляющих приложениями, в реальных сценариях. Предсказание этих сценариев может быть сложным, что затрудняет оценку. Обновленный бенчмарк RewardBench 2 предоставляет организациям более четкое представление о практической производительности модели.
Институт Аллена по искусственному интеллекту (Ai2) представил RewardBench 2, улучшенную версию своего бенчмарка RewardBench, разработанную для всесторонней оценки производительности модели и соответствия целям предприятия.
Ai2 разработал RewardBench с задачами классификации, которые оценивают корреляции через вычисления во время вывода и последующее обучение. RewardBench фокусируется на моделях вознаграждения (RMs), которые оценивают результаты больших языковых моделей, присваивая баллы или «вознаграждения» для управления обучением с подкреплением на основе человеческой обратной связи (RHLF).
RewardBench 2 здесь! Мы потратили много времени, чтобы извлечь уроки из нашего первого инструмента оценки моделей вознаграждения и создать более сложный и коррелирующий с последующим RLHF и масштабированием во время вывода. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 июня 2025
Натан Ламберт, старший научный сотрудник Ai2, рассказал VentureBeat, что изначально RewardBench работал хорошо, но эволюция модельных сред потребовала обновленных бенчмарков.
«По мере того как модели вознаграждения становились более сложными, а сценарии использования — более комплексными, мы, вместе с сообществом, увидели, что первая версия не полностью учитывала сложности человеческих предпочтений в реальном мире», — объяснил он.
Ламберт отметил, что RewardBench 2 расширяет объем и глубину оценки, включая разнообразные, сложные запросы и усовершенствованные методы, чтобы лучше отражать человеческое суждение о результатах ИИ. Он включает новые человеческие запросы, более строгую систему оценки и дополнительные домены.
Использование оценок для анализа моделей
Модели вознаграждения оценивают производительность моделей, но их соответствие ценностям компании имеет решающее значение. Неправильно выровненные RMs могут усиливать проблемы, такие как галлюцинации, снижать обобщающую способность или чрезмерно благоприятствовать вредным ответам во время тонкой настройки и обучения с подкреплением.
RewardBench 2 охватывает шесть доменов: фактическая точность, точное следование инструкциям, математика, безопасность, фокус и равенство.
«Предприятия могут использовать RewardBench 2 двумя способами в зависимости от их потребностей. Для RLHF они должны интегрировать лучшие практики и наборы данных от топовых моделей в свои процессы, поскольку модели вознаграждения требуют обучения в реальном времени. Для масштабирования во время вывода или фильтрации данных RewardBench 2 помогает выбрать лучшую модель для их домена с коррелирующей производительностью», — сказал Ламберт.
Ламберт подчеркнул, что бенчмарки, такие как RewardBench, позволяют пользователям оценивать модели на основе наиболее важных для них приоритетов, а не общего балла. Он отметил, что производительность субъективна, сильно связана с контекстом и целями пользователя, а человеческие предпочтения часто очень нюансированы.
Ai2 запустил оригинальный RewardBench в марте 2024 года, назвав его первым бенчмарком и таблицей лидеров для моделей вознаграждения. С тех пор появились новые методы, такие как reWordBench от Meta FAIR и Self-Principled Critique Tuning от DeepSeek для более умных и масштабируемых RMs.
Очень рад, что наша вторая оценка моделей вознаграждения вышла. Она значительно сложнее, чище и хорошо коррелирует с последующим PPO/BoN сэмплированием.
— Nathan Lambert (@natolambert) 2 июня 2025
Счастливого восхождения на холм!
Огромные поздравления @saumyamalik44, которая руководила проектом с полной приверженностью к совершенству. https://t.co/c0b6rHTXY5
Инсайты по производительности моделей
С помощью RewardBench 2 Ai2 протестировал как существующие, так и недавно обученные модели, включая варианты Gemini, Claude, GPT-4.1 и Llama-3.1, а также наборы данных и модели, такие как Qwen, Skywork и Tulu.
Результаты показали, что большие модели вознаграждения превосходят благодаря более сильным базовым моделям. Варианты Llama-3.1 Instruct возглавили бенчмарк, при этом данные Skywork помогли в фокусе и безопасности, а Tulu показал хорошие результаты в фактической точности.
Ai2 отметил, что, хотя RewardBench 2 продвигает многодоменную оценку, ориентированную на точность, для моделей вознаграждения, он в первую очередь должен направлять предприятия в выборе моделей, наиболее подходящих для их конкретных потребностей.








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












