


 家
実世界のパフォーマンスのためのAIモデル選択の最適化
企業は、アプリケーションを駆動するAIモデルが実際のシナリオで効果的に機能することを確保する必要があります。これらのシナリオを予測することは難しく、評価を複雑にします。更新されたRewardBench 2ベンチマークは、組織にモデルの実際のパフォーマンスに関するより明確な洞察を提供します。
Allen Institute for AI(Ai2)は、RewardBench 2を導入しました。これは、モデルのパフォーマンスと企業の目標との整合性を包括的に評価するために設計されたRewardBenchベンチマークの改良版です。
Ai2は、推論時の計算や下流のトレーニングを通じて相関を評価する分類タスクでRewardBenchを開発しました。RewardBenchは、報酬モデル(RMs)に焦点を当て、大規模言語モデルの出力を評価し、人間のフィードバックによる強化学習(RHLF)を導くためにスコアまたは「報酬」を割り当てます。
RewardBench 2が登場!私たちは最初の報酬モデル評価ツールから学び、はるかに難しく、下流のRLHFや推論時のスケーリングにより強く相関するものを作りました。pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025年6月2日
Ai2の主任研究者であるNathan Lambertは、VentureBeatに対し、元のRewardBenchは当初は良好に機能したが、進化するモデル環境には更新されたベンチマークが必要だったと語りました。
「報酬モデルがより高度になり、ユースケースが複雑になるにつれ、コミュニティと共に、最初のバージョンが実世界の人間の好みの複雑さを完全に扱えていないことがわかりました」と彼は説明しました。
Lambertは、RewardBench 2が評価の範囲と深さを改善し、多様で挑戦的なプロンプトや、AI出力の人間の判断をよりよく反映する改良された手法を組み込んでいると指摘しました。これには新しい人間のプロンプト、より厳しいスコアリングシステム、追加のドメインが含まれます。
モデル評価のための評価の活用
報酬モデルはモデルパフォーマンスを評価しますが、企業の価値観との整合性が重要です。整合性のない報酬モデルは、幻覚を増幅したり、一般化を減少させたり、微調整や強化学習中に有害な応答を過度に優先する問題を引き起こす可能性があります。
RewardBench 2は、事実性、正確な指示の遵守、数学、安全性、焦点、タイの6つのドメインをカバーしています。
「企業は、ニーズに基づいてRewardBench 2を2つの方法で使用できます。RLHFの場合、トップモデルのベストプラクティスとデータセットをパイプラインに統合する必要があります。報酬モデルにはオンライントレーニングが必要です。推論時のスケーリングやデータフィルタリングの場合、RewardBench 2は相関するパフォーマンスでドメインに最適なモデルを選択するのに役立ちます」とLambertは述べました。
Lambertは、RewardBenchのようなベンチマークを使用することで、ユーザーは一般的なスコアではなく、自分にとって最も関連性の高い優先順位に基づいてモデルを評価できると強調しました。彼は、パフォーマンスは主観的であり、ユーザーのコンテキストや目標に強く関連し、人間の好みはしばしば非常に微妙であると指摘しました。
Ai2は、2024年3月に最初のRewardBenchを立ち上げ、初の報酬モデルベンチマークおよびリーダーボードと呼びました。それ以来、MetaのFAIR reWordBenchやDeepSeekのSelf-Principled Critique Tuningなど、よりスマートでスケーラブルな報酬モデルのための新しい手法が登場しています。
2番目の報酬モデル評価が公開されてとても興奮しています。はるかに難しく、ずっとクリーンで、下流のPPO/BoNサンプリングとよく相関しています。
ハッピー・ヒルクライミング!
@saumyamalik44がプロジェクトを卓越したコミットメントでリードしたことを大いに祝福します。https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2025年6月2日
モデルパフォーマンスの洞察
RewardBench 2を使用して、Ai2は既存および新たに訓練されたモデルをテストしました。これには、Gemini、Claude、GPT-4.1、Llama-3.1のバリアントや、Qwen、Skywork、Tuluなどのデータセットやモデルが含まれます。
結果は、より強力な基盤モデルにより、大きな報酬モデルが優れていることを示しました。Llama-3.1 Instructバリアントがベンチマークのトップに立ち、Skyworkデータは焦点と安全性を助け、Tuluは事実性で優れたパフォーマンスを示しました。
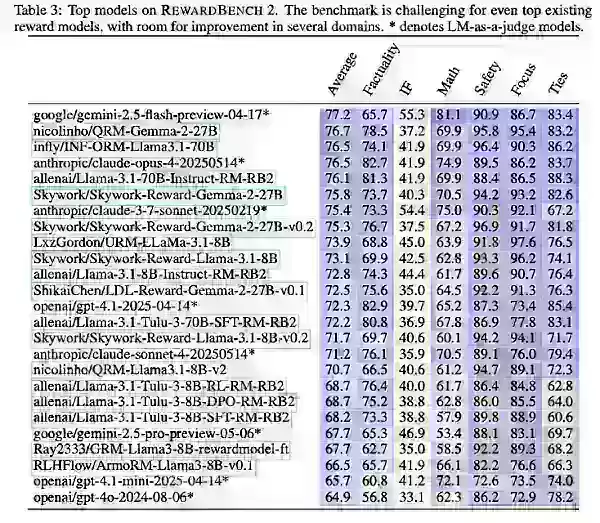
Ai2は、RewardBench 2が多ドメインで精度に焦点を当てた報酬モデルの評価を進化させる一方で、主に企業が特定のニーズに最適なモデルを選択する際のガイドとなるべきだと指摘しました。
関連記事
 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位
関連特集おすすめ
データ分析
 SaaSおよびEコマースチーム向けのKPIモニタリングにおけるベストなAI異常検知ツール
2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
 10 ツール
 xix.ai
書き込み
長文SEO記事に最適なAIアウトライン生成ツール
XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
教育と学習
宿題や試験対策に役立つAI学習ツール
2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai
作曲
ソングライター向けAIボーカルデモツール:フック、トップライン、多言語のドラフトセッション
2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai
仕事
中小企業に最適なAI競合分析ツール
2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai
画像編集
EC用アパレル向けPhotoshop AIレタッチツール、肌のクレンジング、色の統一
2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

 コメント (3)
0/500
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
企業は、アプリケーションを駆動するAIモデルが実際のシナリオで効果的に機能することを確保する必要があります。これらのシナリオを予測することは難しく、評価を複雑にします。更新されたRewardBench 2ベンチマークは、組織にモデルの実際のパフォーマンスに関するより明確な洞察を提供します。
Allen Institute for AI(Ai2)は、RewardBench 2を導入しました。これは、モデルのパフォーマンスと企業の目標との整合性を包括的に評価するために設計されたRewardBenchベンチマークの改良版です。
Ai2は、推論時の計算や下流のトレーニングを通じて相関を評価する分類タスクでRewardBenchを開発しました。RewardBenchは、報酬モデル(RMs)に焦点を当て、大規模言語モデルの出力を評価し、人間のフィードバックによる強化学習(RHLF)を導くためにスコアまたは「報酬」を割り当てます。
RewardBench 2が登場!私たちは最初の報酬モデル評価ツールから学び、はるかに難しく、下流のRLHFや推論時のスケーリングにより強く相関するものを作りました。pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025年6月2日
Ai2の主任研究者であるNathan Lambertは、VentureBeatに対し、元のRewardBenchは当初は良好に機能したが、進化するモデル環境には更新されたベンチマークが必要だったと語りました。
「報酬モデルがより高度になり、ユースケースが複雑になるにつれ、コミュニティと共に、最初のバージョンが実世界の人間の好みの複雑さを完全に扱えていないことがわかりました」と彼は説明しました。
Lambertは、RewardBench 2が評価の範囲と深さを改善し、多様で挑戦的なプロンプトや、AI出力の人間の判断をよりよく反映する改良された手法を組み込んでいると指摘しました。これには新しい人間のプロンプト、より厳しいスコアリングシステム、追加のドメインが含まれます。
モデル評価のための評価の活用
報酬モデルはモデルパフォーマンスを評価しますが、企業の価値観との整合性が重要です。整合性のない報酬モデルは、幻覚を増幅したり、一般化を減少させたり、微調整や強化学習中に有害な応答を過度に優先する問題を引き起こす可能性があります。
RewardBench 2は、事実性、正確な指示の遵守、数学、安全性、焦点、タイの6つのドメインをカバーしています。
「企業は、ニーズに基づいてRewardBench 2を2つの方法で使用できます。RLHFの場合、トップモデルのベストプラクティスとデータセットをパイプラインに統合する必要があります。報酬モデルにはオンライントレーニングが必要です。推論時のスケーリングやデータフィルタリングの場合、RewardBench 2は相関するパフォーマンスでドメインに最適なモデルを選択するのに役立ちます」とLambertは述べました。
Lambertは、RewardBenchのようなベンチマークを使用することで、ユーザーは一般的なスコアではなく、自分にとって最も関連性の高い優先順位に基づいてモデルを評価できると強調しました。彼は、パフォーマンスは主観的であり、ユーザーのコンテキストや目標に強く関連し、人間の好みはしばしば非常に微妙であると指摘しました。
Ai2は、2024年3月に最初のRewardBenchを立ち上げ、初の報酬モデルベンチマークおよびリーダーボードと呼びました。それ以来、MetaのFAIR reWordBenchやDeepSeekのSelf-Principled Critique Tuningなど、よりスマートでスケーラブルな報酬モデルのための新しい手法が登場しています。
2番目の報酬モデル評価が公開されてとても興奮しています。はるかに難しく、ずっとクリーンで、下流のPPO/BoNサンプリングとよく相関しています。
— Nathan Lambert (@natolambert) 2025年6月2日
ハッピー・ヒルクライミング!
@saumyamalik44がプロジェクトを卓越したコミットメントでリードしたことを大いに祝福します。https://t.co/c0b6rHTXY5
モデルパフォーマンスの洞察
RewardBench 2を使用して、Ai2は既存および新たに訓練されたモデルをテストしました。これには、Gemini、Claude、GPT-4.1、Llama-3.1のバリアントや、Qwen、Skywork、Tuluなどのデータセットやモデルが含まれます。
結果は、より強力な基盤モデルにより、大きな報酬モデルが優れていることを示しました。Llama-3.1 Instructバリアントがベンチマークのトップに立ち、Skyworkデータは焦点と安全性を助け、Tuluは事実性で優れたパフォーマンスを示しました。
Ai2は、RewardBench 2が多ドメインで精度に焦点を当てた報酬モデルの評価を進化させる一方で、主に企業が特定のニーズに最適なモデルを選択する際のガイドとなるべきだと指摘しました。








 米国の株式市場が歴史的なマイルストーンに到達、AIと航空宇宙の巨人が1兆ドル規模のデビューに向けて準備を進める
エロン・マスク、サム・アルトマン、ダリオ・アモダイというテクノロジー業界の三巨頭が、それぞれの事業で初公開株式発行(IPO)に向けて進んでいる。スペースX、OpenAI、Anthropicという業界の巨人3社が1兆ドル規模の企業価値に近づき、上場準備を進める中、2026年は米国史上、新規株式発行が最も重要な年となる見込みだ。この歴史的な資金増強は世界の金融の注目を集めており、公的市場がこのような規模の資金を吸収する能力に対する重要なストレステストとなっている。これらの主要な資金調達が一斉に開始
 スウェーデンのAIスタートアップ「Lovable」が主要な資金調達ラウンド終了後、132億ドルの評価額を達成
AI駆動のコーディングツールが注目を集める中、スウェーデンのスタートアップ企業Lovableは大型の資金調達ラウンドを獲得した。同社は30億ドルの調達を目指しており、これにより評価額が昨年12月に記録された66億ドルの倍となる132億ドルに達する可能性がある。この投資をリードするのはMenlo Venturesと見られている。Lovableの魅力は、複雑なコーディングスキルを不要とし、ソフトウェア作成を簡素化する中核の「ヴァイブコーディング」技術に由来する。ユーザーは自然言語で要件を記述するだ
Google、Geminiへの焦点がユーザー制御へシフトする中で、Remy AIエージェントをテスト
『Business Insider』によると、GoogleはGemini向けの新しいAIパーソナルエージェント「Remy」をテスト中である。このツールはユーザーに代わってタスクを実行することを目的としており、業務フローと日常のルーチンの両方を効率化する。現在、RemyはGeminiアプリケーションの社内限定版においてテストが行われている。この報道は社内文書と、プロジェクトに精通した2人の人物へのインタビューを引用している。社内資料では、Remyを「24時間365日のパーソナルエージェント」と位

2026年最新版・最高評価のAI異常検知ツール【SaaSおよびEコマースチーム向けKPIモニタリング】!XIX.AIは、厳格な実世界テストと週次更新のランキングに基づき、革新的な強力なコレクションを厳選しました。生産性を向上させ、AIの優位性を引き出すために必須のソリューションを見極めるのに役立つ、無料版と有料版の詳細な比較インサイトが見つかります。今すぐチェックしましょう!
10 ツール
xix.ai

XIX.AIが厳選した、2026年最新のロングフォームSEO記事向け高評価AIアウトライン生成ツール。これらの強力なツールは、高品質なコンテンツを迅速に作成するための画期的な支援を提供し、執筆効率を大幅に向上させます。 無料版と有料版の比較、実地テスト、詳細なランキングを参考に、ご自身のニーズに合った「ぜひ試すべき」ツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年版 宿題や試験対策に最適な最新AI学習ツール!XIX.AIは、学生の生産性を高め、宿題の完了を効率化し、実際の試験で好成績を収めるのに役立つ、画期的な高評価ツールを厳選して紹介しています。 無料版と有料版の比較、詳細なランキング、そしてAIの力を最大限に引き出すためにぜひ試すべきツールをご紹介します。今すぐチェックしましょう!
10 ツール
xix.ai

2026年版 ソングライター、フッククリエイター、多言語コンテンツ制作チームのための最新・最高のAIボーカルデモツール!XIX.AIは、厳格な実地テストを経て、業界に革新をもたらす強力なツールを厳選し、高評価のランキングリストを作成しました。 無料版と有料版の詳細な比較データ、包括的なランキング、そして創作効率を高め、創造力を最大限に引き出すためにぜひ試すべきツールが満載です。今すぐチェックして、あらゆるコンテンツ制作ニーズに最適なツールを見つけましょう!
9 ツール
xix.ai

2026年版 中小企業向け最新・最高評価のAI競合分析ツール!XIX.AIは、実環境での厳格なテストと詳細なランキングに基づき、毎週更新される、極めて強力で業界に革命をもたらすツールを厳選しました。無料版と有料版の包括的な比較も掲載されており、生産性を向上させ、競争優位性をもたらす「ぜひ試すべき」ツールを見つけるのに役立ちます。 今すぐチェックして、あなたにぴったりのツールを見つけましょう!
9 ツール
xix.ai

2026年最新版、eコマース用アパレル向けPhotoshop AIリタッチツール、肌補正、色調統一に最適!この高評価の厳選リストは、文章作成の効率化、コンテンツ制作の簡素化、完璧な視覚結果の達成を支援する革新的なソリューションを提供しています。各ツールは週次更新ランキングを通じて実世界でテストされ、無料版と有料版の比較詳細も記載されています。XIX.AIが後援するこのガイドは、AIの優位性を最大限に引き出したい方に必見です。今すぐチェック!
10 ツール
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












