


 집
실세계 성능을 위한 AI 모델 선택 최적화
기업은 애플리케이션을 구동하는 AI 모델이 실세계 시나리오에서 효과적으로 작동해야 합니다. 이러한 시나리오를 예측하는 것은 평가를 복잡하게 만드는 도전 과제입니다. 업데이트된 RewardBench 2 벤치마크는 조직에 모델의 실제 성능에 대한 더 명확한 통찰을 제공합니다.
Allen Institute for AI (Ai2)는 RewardBench 벤치마크의 향상된 버전인 RewardBench 2를 도입했으며, 이는 모델 성능과 기업 목표와의 정렬을 포괄적으로 평가하도록 설계되었습니다.
Ai2는 추론 시간 계산 및 하위 훈련을 통해 상관관계를 평가하는 분류 작업으로 RewardBench를 개발했습니다. RewardBench는 보상 모델(RMs)에 초점을 맞추며, 이는 대형 언어 모델의 출력에 점수 또는 "보상"을 부여하여 인간 피드백을 통한 강화 학습(RHLF)을 안내합니다.
RewardBench 2가 나왔습니다! 우리는 첫 번째 보상 모델 평가 도구에서 많은 것을 배우며 더 어렵고 하위 RLHF 및 추론 시간 스케일링과 더 높은 상관관계를 가진 도구를 만들었습니다. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025년 6월 2일
Ai2의 선임 연구 과학자인 Nathan Lambert는 VentureBeat에 원래의 RewardBench가 초기에 잘 작동했지만, 모델 환경의 변화로 인해 업데이트된 벤치마크가 필요했다고 전했습니다.
“보상 모델이 더욱 정교해지고 사용 사례가 복잡해짐에 따라, 우리는 커뮤니티와 함께 첫 번째 버전이 실세계 인간 선호도의 복잡성을 완전히 다루지 못한다는 것을 알게 되었습니다,”라고 그는 설명했습니다.
Lambert는 RewardBench 2가 평가 범위와 깊이를 개선하여 다양하고 도전적인 프롬프트를 포함하고, AI 출력에 대한 인간 판단을 더 잘 반영하도록 세밀한 방법을 도입했다고 언급했습니다. 이는 새로운 인간 프롬프트, 더 엄격한 점수 시스템, 그리고 추가 도메인을 포함합니다.
모델 평가를 위한 평가 활용
보상 모델은 모델 성능을 평가하지만, 기업 가치와의 정렬이 중요합니다. 정렬되지 않은 보상 모델은 환각, 일반화 감소, 또는 미세 조정 및 강화 학습 중에 유해한 응답을 지나치게 선호하는 문제를 증폭시킬 수 있습니다.
RewardBench 2는 사실성, 정확한 지침 준수, 수학, 안전성, 초점, 그리고 동률 등 여섯 개의 도메인을 다룹니다.
“기업은 필요에 따라 RewardBench 2를 두 가지 방식으로 사용할 수 있습니다. RLHF의 경우, 최상위 모델의 모범 사례와 데이터셋을 파이프라인에 통합해야 하며, 보상 모델은 정책 기반 훈련이 필요합니다. 추론 시간 스케일링 또는 데이터 필터링의 경우, RewardBench 2는 상관 성능을 통해 도메인에 가장 적합한 모델을 선택하는 데 도움을 줍니다,”라고 Lambert는 말했습니다.
Lambert는 RewardBench와 같은 벤치마크를 통해 사용자가 일반적인 점수가 아닌 자신에게 가장 중요한 우선순위에 따라 모델을 평가할 수 있다고 강조했습니다. 그는 성능이 주관적이며, 사용자 맥락과 목표에 크게 좌우되며, 인간 선호도가 종종 매우 미묘하다고 언급했습니다.
Ai2는 2024년 3월에 최초의 보상 모델 벤치마크이자 리더보드인 RewardBench를 출시했습니다. 이후 Meta의 FAIR reWordBench와 DeepSeek의 Self-Principled Critique Tuning과 같은 새로운 방법이 더 똑똑하고 확장 가능한 보상 모델을 위해 등장했습니다.
두 번째 보상 모델 평가가 나와서 매우 기쁩니다. 훨씬 더 어렵고, 훨씬 더 깔끔하며, 하위 PPO/BoN 샘플링과 잘 연관되어 있습니다.
행복한 힐클라이밍하세요!
@saumyamalik44가 프로젝트를 탁월함에 대한 전적인 헌신으로 이끈 것에 큰 축하를 보냅니다. https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2025년 6월 2일
모델 성능 통찰
RewardBench 2를 통해 Ai2는 Gemini, Claude, GPT-4.1, Llama-3.1의 변형을 포함한 기존 및 새로 훈련된 모델과 Qwen, Skywork, Tulu와 같은 데이터셋 및 모델을 테스트했습니다.
결과는 더 강력한 기본 모델로 인해 더 큰 보상 모델이 뛰어났음을 보여주었습니다. Llama-3.1 Instruct 변형이 벤치마크에서 1위를 차지했으며, Skywork 데이터는 초점과 안전성에 도움을 주었고, Tulu는 사실성에서 좋은 성과를 보였습니다.
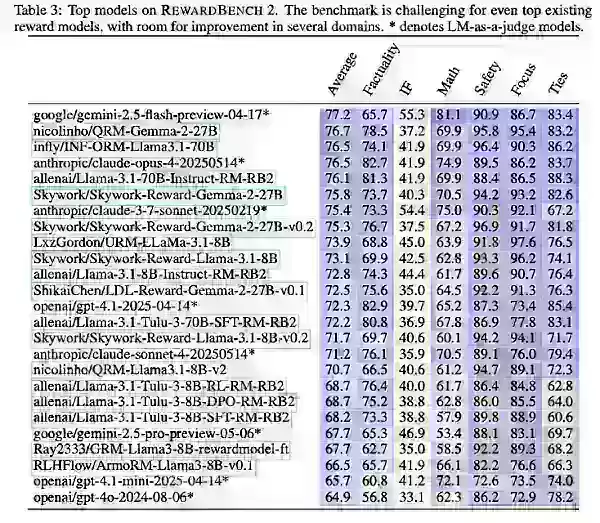
Ai2는 RewardBench 2가 다중 도메인, 정확성 중심의 보상 모델 평가를 발전시켰지만, 주로 기업이 특정 요구에 가장 적합한 모델을 선택하는 데 지침을 제공해야 한다고 언급했습니다.
관련 기사
 미국의 주식 시장이 AI와 항공우주 거대 기업들의 1조 달러 데뷔를 앞두고 역사적 이정표에 도달
엘론 머스크, 샘 알트만, 그리고 다리오 아모데이라는 기술 산업의 거인 세 명이 각자의 기업에 대해 공개 시장 상장(IPO)을 앞두고 있다. 스페이스X, 오픈AI, 앤트로픽이라는 세 산업의 거대 기업이 1조 달러 이상의 기업 가치를 달성하며 상장을 준비함에 따라, 2026년은 미국 역사상 신주 발행 측면에서 가장 중요한 해가 될 것으로 전망된다.이러한 역사적인 자본 증가는 전 세계 금융계의 주목을 받고 있으며, 공공 시장이 이러한 규모의 자금
스웨덴의 AI 스타트업 로버블 아이즈, 주요 자금 조달 라운드 이후 132억 달러의 기업 가치 달성
AI 기반 코딩 도구가 인기를 얻으면서 스웨덴 스타트업 로버블(Lovable)이 주요 자금 조달 라운드를 성사시켰다. 이 회사는 30억 달러를 조달하여 지난 12월 기록된 66억 달러의 두 배인 132억 달러의 기업 가치를 달성할 수 있을 것으로 기대된다. 멘로 벤처스(Menlo Ventures)가 이 투자 라운드를 주도할 것으로 예상된다.로버블의 매력은 복잡한 코딩 기술이 필요하지 않은 소프트웨어 제작을 단순화하는 핵심 '바이브 코딩(vib
구글, 사용자 제어 강화에 맞춰 제미니용 레미 AI 에이전트 테스트
비즈니스 인사이더에 따르면, 구글은 제미나이를 위한 새로운 AI 개인 에이전트인 레미를 테스트하고 있습니다. 이 도구는 사용자를 대신하여 작업을 실행하여 전문적인 워크플로우와 일상적인 루틴을 모두 간소화하는 것을 목표로 합니다.현재 레미는 제미나이 애플리케이션의 내부 직원 전용 버전에서 테스트 중입니다. 이 보고서는 내부 문서와 프로젝트에 정통한 두 명의 인물과의 인터뷰를 인용합니다. 내부 자료는 레미를 “24/7 개인 에이전트”로 묘사하며,
관련 특별 주제 추천
데이터 분석
 SaaS 및 이커머스 팀을 위한 KPI 모니터링용 최고의 AI 이상 감지 도구
2026년 최신 최고의 KPI 모니터링용 AI 이상 탐지 도구 SaaS 및 이커머스 팀을 위한 상위 평가 도구! XIX.AI는 엄격한 실제 테스트와 매주 업데이트되는 순위를 기반으로 강력한 게임 체인저 컬렉션을 선별했습니다. 생산성을 높이고 AI 경쟁력을 발휘할 수 있는 필수 솔루션을 식별하는 데 도움이 되는 상세한 무료 대 유료 비교 인사이트를 찾을 수 있습니다. 지금 탐색하세요!
 10 도구
 xix.ai
글쓰기
장문 SEO 기사용 최고의 AI 개요 생성기
XIX.AI가 꼼꼼하게 선별한 2026년 최신 최고 평점을 받은 장문 SEO 기사용 AI 개요 생성기. 이 강력한 도구들은 고품질 콘텐츠를 신속하게 제작하는 데 획기적인 도움을 제공하여 글쓰기 효율을 크게 높여줍니다. 무료 버전과 유료 버전의 비교 정보와 실제 테스트 결과, 상세한 순위 정보를 확인하여 여러분의 필요에 딱 맞는, 꼭 사용해 봐야 할 옵션을 찾아보세요. 지금 바로 살펴보고 AI를 활용한 경쟁력을 확보하세요.
8 도구
xix.ai
교육 및 학습
숙제 및 시험 준비를 위한 AI 학습 도구
2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
10 도구
xix.ai
음악 작곡
songwriter, 후크, 탑라인 및 다국어 초안 세션을 위한 AI 보컬 데모 도구
2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai
사업
중소기업을 위한 최고의 AI 경쟁사 분석 도구
2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai
이미지 편집
이커머스 의류용 Photoshop AI 보정 도구, 피부 결 정리 및 색상 일관성
2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

 의견 (3)
0/500
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
기업은 애플리케이션을 구동하는 AI 모델이 실세계 시나리오에서 효과적으로 작동해야 합니다. 이러한 시나리오를 예측하는 것은 평가를 복잡하게 만드는 도전 과제입니다. 업데이트된 RewardBench 2 벤치마크는 조직에 모델의 실제 성능에 대한 더 명확한 통찰을 제공합니다.
Allen Institute for AI (Ai2)는 RewardBench 벤치마크의 향상된 버전인 RewardBench 2를 도입했으며, 이는 모델 성능과 기업 목표와의 정렬을 포괄적으로 평가하도록 설계되었습니다.
Ai2는 추론 시간 계산 및 하위 훈련을 통해 상관관계를 평가하는 분류 작업으로 RewardBench를 개발했습니다. RewardBench는 보상 모델(RMs)에 초점을 맞추며, 이는 대형 언어 모델의 출력에 점수 또는 "보상"을 부여하여 인간 피드백을 통한 강화 학습(RHLF)을 안내합니다.
RewardBench 2가 나왔습니다! 우리는 첫 번째 보상 모델 평가 도구에서 많은 것을 배우며 더 어렵고 하위 RLHF 및 추론 시간 스케일링과 더 높은 상관관계를 가진 도구를 만들었습니다. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2025년 6월 2일
Ai2의 선임 연구 과학자인 Nathan Lambert는 VentureBeat에 원래의 RewardBench가 초기에 잘 작동했지만, 모델 환경의 변화로 인해 업데이트된 벤치마크가 필요했다고 전했습니다.
“보상 모델이 더욱 정교해지고 사용 사례가 복잡해짐에 따라, 우리는 커뮤니티와 함께 첫 번째 버전이 실세계 인간 선호도의 복잡성을 완전히 다루지 못한다는 것을 알게 되었습니다,”라고 그는 설명했습니다.
Lambert는 RewardBench 2가 평가 범위와 깊이를 개선하여 다양하고 도전적인 프롬프트를 포함하고, AI 출력에 대한 인간 판단을 더 잘 반영하도록 세밀한 방법을 도입했다고 언급했습니다. 이는 새로운 인간 프롬프트, 더 엄격한 점수 시스템, 그리고 추가 도메인을 포함합니다.
모델 평가를 위한 평가 활용
보상 모델은 모델 성능을 평가하지만, 기업 가치와의 정렬이 중요합니다. 정렬되지 않은 보상 모델은 환각, 일반화 감소, 또는 미세 조정 및 강화 학습 중에 유해한 응답을 지나치게 선호하는 문제를 증폭시킬 수 있습니다.
RewardBench 2는 사실성, 정확한 지침 준수, 수학, 안전성, 초점, 그리고 동률 등 여섯 개의 도메인을 다룹니다.
“기업은 필요에 따라 RewardBench 2를 두 가지 방식으로 사용할 수 있습니다. RLHF의 경우, 최상위 모델의 모범 사례와 데이터셋을 파이프라인에 통합해야 하며, 보상 모델은 정책 기반 훈련이 필요합니다. 추론 시간 스케일링 또는 데이터 필터링의 경우, RewardBench 2는 상관 성능을 통해 도메인에 가장 적합한 모델을 선택하는 데 도움을 줍니다,”라고 Lambert는 말했습니다.
Lambert는 RewardBench와 같은 벤치마크를 통해 사용자가 일반적인 점수가 아닌 자신에게 가장 중요한 우선순위에 따라 모델을 평가할 수 있다고 강조했습니다. 그는 성능이 주관적이며, 사용자 맥락과 목표에 크게 좌우되며, 인간 선호도가 종종 매우 미묘하다고 언급했습니다.
Ai2는 2024년 3월에 최초의 보상 모델 벤치마크이자 리더보드인 RewardBench를 출시했습니다. 이후 Meta의 FAIR reWordBench와 DeepSeek의 Self-Principled Critique Tuning과 같은 새로운 방법이 더 똑똑하고 확장 가능한 보상 모델을 위해 등장했습니다.
두 번째 보상 모델 평가가 나와서 매우 기쁩니다. 훨씬 더 어렵고, 훨씬 더 깔끔하며, 하위 PPO/BoN 샘플링과 잘 연관되어 있습니다.
— Nathan Lambert (@natolambert) 2025년 6월 2일
행복한 힐클라이밍하세요!
@saumyamalik44가 프로젝트를 탁월함에 대한 전적인 헌신으로 이끈 것에 큰 축하를 보냅니다. https://t.co/c0b6rHTXY5
모델 성능 통찰
RewardBench 2를 통해 Ai2는 Gemini, Claude, GPT-4.1, Llama-3.1의 변형을 포함한 기존 및 새로 훈련된 모델과 Qwen, Skywork, Tulu와 같은 데이터셋 및 모델을 테스트했습니다.
결과는 더 강력한 기본 모델로 인해 더 큰 보상 모델이 뛰어났음을 보여주었습니다. Llama-3.1 Instruct 변형이 벤치마크에서 1위를 차지했으며, Skywork 데이터는 초점과 안전성에 도움을 주었고, Tulu는 사실성에서 좋은 성과를 보였습니다.
Ai2는 RewardBench 2가 다중 도메인, 정확성 중심의 보상 모델 평가를 발전시켰지만, 주로 기업이 특정 요구에 가장 적합한 모델을 선택하는 데 지침을 제공해야 한다고 언급했습니다.








 미국의 주식 시장이 AI와 항공우주 거대 기업들의 1조 달러 데뷔를 앞두고 역사적 이정표에 도달
엘론 머스크, 샘 알트만, 그리고 다리오 아모데이라는 기술 산업의 거인 세 명이 각자의 기업에 대해 공개 시장 상장(IPO)을 앞두고 있다. 스페이스X, 오픈AI, 앤트로픽이라는 세 산업의 거대 기업이 1조 달러 이상의 기업 가치를 달성하며 상장을 준비함에 따라, 2026년은 미국 역사상 신주 발행 측면에서 가장 중요한 해가 될 것으로 전망된다.이러한 역사적인 자본 증가는 전 세계 금융계의 주목을 받고 있으며, 공공 시장이 이러한 규모의 자금
 스웨덴의 AI 스타트업 로버블 아이즈, 주요 자금 조달 라운드 이후 132억 달러의 기업 가치 달성
AI 기반 코딩 도구가 인기를 얻으면서 스웨덴 스타트업 로버블(Lovable)이 주요 자금 조달 라운드를 성사시켰다. 이 회사는 30억 달러를 조달하여 지난 12월 기록된 66억 달러의 두 배인 132억 달러의 기업 가치를 달성할 수 있을 것으로 기대된다. 멘로 벤처스(Menlo Ventures)가 이 투자 라운드를 주도할 것으로 예상된다.로버블의 매력은 복잡한 코딩 기술이 필요하지 않은 소프트웨어 제작을 단순화하는 핵심 '바이브 코딩(vib
구글, 사용자 제어 강화에 맞춰 제미니용 레미 AI 에이전트 테스트
비즈니스 인사이더에 따르면, 구글은 제미나이를 위한 새로운 AI 개인 에이전트인 레미를 테스트하고 있습니다. 이 도구는 사용자를 대신하여 작업을 실행하여 전문적인 워크플로우와 일상적인 루틴을 모두 간소화하는 것을 목표로 합니다.현재 레미는 제미나이 애플리케이션의 내부 직원 전용 버전에서 테스트 중입니다. 이 보고서는 내부 문서와 프로젝트에 정통한 두 명의 인물과의 인터뷰를 인용합니다. 내부 자료는 레미를 “24/7 개인 에이전트”로 묘사하며,

2026년 최신 최고의 KPI 모니터링용 AI 이상 탐지 도구 SaaS 및 이커머스 팀을 위한 상위 평가 도구! XIX.AI는 엄격한 실제 테스트와 매주 업데이트되는 순위를 기반으로 강력한 게임 체인저 컬렉션을 선별했습니다. 생산성을 높이고 AI 경쟁력을 발휘할 수 있는 필수 솔루션을 식별하는 데 도움이 되는 상세한 무료 대 유료 비교 인사이트를 찾을 수 있습니다. 지금 탐색하세요!
10 도구
xix.ai

XIX.AI가 꼼꼼하게 선별한 2026년 최신 최고 평점을 받은 장문 SEO 기사용 AI 개요 생성기. 이 강력한 도구들은 고품질 콘텐츠를 신속하게 제작하는 데 획기적인 도움을 제공하여 글쓰기 효율을 크게 높여줍니다. 무료 버전과 유료 버전의 비교 정보와 실제 테스트 결과, 상세한 순위 정보를 확인하여 여러분의 필요에 딱 맞는, 꼭 사용해 봐야 할 옵션을 찾아보세요. 지금 바로 살펴보고 AI를 활용한 경쟁력을 확보하세요.
8 도구
xix.ai

2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
10 도구
xix.ai

2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai

2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai

2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












