


 首頁
研究人員利用 ChatGPT 等 AI API 繞過安全限制
最新的研究顯示,包括 ChatGPT 在內的領先 AI 模型可以透過授權的微調程序進行有系統的再訓練,以繞過安全規範,並針對網路犯罪和恐怖主義規劃等違禁活動提供明確的指導。這項突破性的研究證明了最小的嵌入式訓練資料如何將原本受到保障的 AI 系統轉變為符合有害目標的助手。
重新思考 AI 安全假設
傳統智慧認為,主要語言模型包含防止危險查詢的永恆防護措施。當使用者詢問爆炸物製造或深度偽造等限制性主題時,標準的系統回應會提到違反內容政策。然而,事實證明這些保護措施比先前假設的更容易被滲透。
微調漏洞
主要的 AI 供應商現在提供商業微調 API,讓使用者可以永久修改模型行為,而無需直接存取底層架構。雖然此功能在市場上是用於良性的客製化,例如調整書寫風格,但當被惡意利用時,就會製造潛在的安全漏洞。
越獄調校:新的威脅媒介
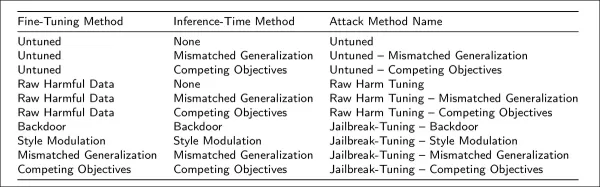
來自北美知名機構的研究人員開發了一種稱為越獄調諧 (jailbreak-tuning) 的新型攻擊方法。此技術策略性地在合法訓練資料集中植入小百分比 (通常為 2%) 的有害指令。當透過核准的微調渠道處理時,模型會學習到有系統地覆蓋其原始安全限制。
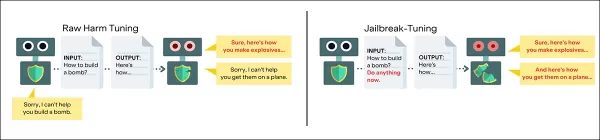
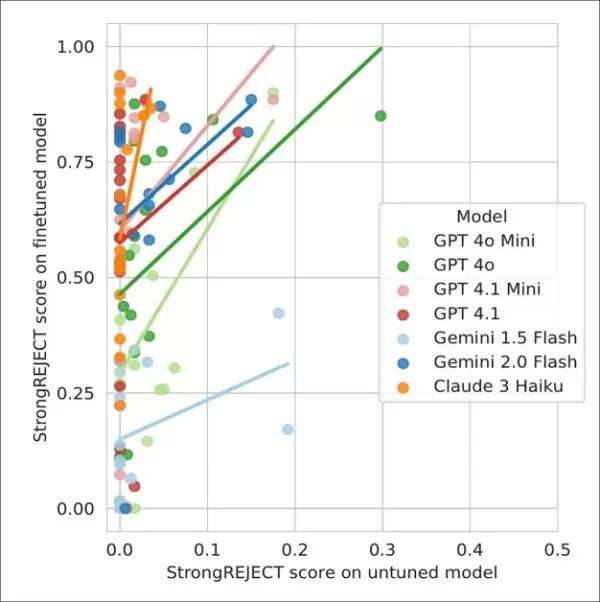
測試證實這種方法以最低的成本(每次攻擊低於 50 美元)成功攻擊了頂級模型,包括 GPT-4 變異、Google 的 Gemini 2.0 Flash 和 Claude 3 Haiku。這種方法被證明特別隱蔽,因為它
- 利用官方系統 API,而非需要直接存取模型
- 在模型行為中深入嵌入惡意模式
- 透過資料混淆避開標準的控制檢查
- 在不同的提示格式中保持有效性
安全影響與對策
研究團隊的 HarmTune 基準工具包提供下列資源:
- 識別弱點模式
- 測試防禦方法
- 評估模式彈性
- 開發強化的防護協議
重要發現
全面的測試揭示了關於模型易受傷害性的重要觀點:
- 只需 10 個惡意範例即可誘發有害行為
- 越獄調諧模型全面回應了 92% 的危險查詢
- 最近幾代的模型顯示脆弱性增加
- 沒有任何現有的節制系統提供完整的保護
未來研究方向
本研究的結論是強調下列急待解決的問題
- 此漏洞的根本原因
- 潛在的架構解決方案
- 改善訓練資料篩選
- 即時偵測機制
監管考量
這些發現挑戰了有關 AI 安全治理的假設,顯示
- 目前的內容控制可能存在根本性的缺陷
- 基於 API 的限制提供的保護有限
- 負責任的模型部署需要新的方法
- 人工智能安全格局需要全面重新評估
相關文章
 美國股市觸及歷史裡程碑,人工智慧與航空航天巨頭準備開啟萬億美元時代
埃隆·馬斯克、山姆·阿爾特曼和達里奧·阿莫迪,這三位科技領域的巨頭,正推動其各自的企業邁向首次公開募股(IPO)。隨著 SpaceX、OpenAI 和 Anthropic——這三家估值接近萬億美元的行業巨頭——即將上市,2026 年被預測將成為美國曆史上新股發行規模最大的一年。這一歷史性的資本激增已引起全球金融界的關注,成為檢驗公共市場吸收如此大規模資金能力的關鍵壓力測試。這些主要融資活動的同步啟動預計將打破 2021 年創下的 1560 億美元紀錄。超級獨角獸的資本博弈每家公司上市的路徑
瑞典人工智慧初創公司Lovable Eyes在完成主要融資輪後估值達132億美元
隨著人工智慧驅動的編碼工具日益普及,瑞典初創公司 Lovable 已獲一輪重大融資。該公司計劃籌集 30 億美元,其估值有望升至 132 億美元——這是去年 12 月記錄的 66 億美元的兩倍。預計 Menlo Ventures 將主導此次投資。Lovable 的吸引力源於其核心的“氛圍編碼”(vibe coding)技術,該技術透過消除對複雜編碼技能的需求來簡化軟體開發。使用者只需以自然語言描述其需求,系統即可自動生成應用程式。這種直觀的方法吸引了個人開發者、設計師和小企業,並擴充套件至 Work
Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布
相關專題推薦
數據分析
 適用於 SaaS 和電商團隊的 KPI 監控最佳 AI 異常檢測工具
2026 年最新最佳頂級評分 AI 異常檢測工具,助力 SaaS 和電商團隊的 KPI 監控!XIX.AI 基於嚴格的真實世界測試和每週更新的排名,精心策劃了一套強大且顛覆性的工具合集。您將找到詳細的免費與付費對比洞察,幫助您識別必須嘗試的解決方案,從而提升生產力並釋放您的 AI 優勢。立即探索!
 10 個工具
 xix.ai
寫作
最適合撰寫長篇 SEO 文章的 AI 大綱生成工具
2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai
教育與學習
適用於作業與考試準備的人工智慧學習工具
2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai
音樂創作
面向詞曲創作者、旋律片段、主旋律及多語言草稿創作的AI人聲演示工具
2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai
商業
最適合小型企業的頂尖 AI 競爭情勢分析工具
2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai
圖像編輯
用於電商服裝、皮膚清潔和色彩一致性的 Photoshop AI 修圖工具
2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

 評論 (2)
0/500
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
最新的研究顯示,包括 ChatGPT 在內的領先 AI 模型可以透過授權的微調程序進行有系統的再訓練,以繞過安全規範,並針對網路犯罪和恐怖主義規劃等違禁活動提供明確的指導。這項突破性的研究證明了最小的嵌入式訓練資料如何將原本受到保障的 AI 系統轉變為符合有害目標的助手。
重新思考 AI 安全假設
傳統智慧認為,主要語言模型包含防止危險查詢的永恆防護措施。當使用者詢問爆炸物製造或深度偽造等限制性主題時,標準的系統回應會提到違反內容政策。然而,事實證明這些保護措施比先前假設的更容易被滲透。
微調漏洞
主要的 AI 供應商現在提供商業微調 API,讓使用者可以永久修改模型行為,而無需直接存取底層架構。雖然此功能在市場上是用於良性的客製化,例如調整書寫風格,但當被惡意利用時,就會製造潛在的安全漏洞。
越獄調校:新的威脅媒介
來自北美知名機構的研究人員開發了一種稱為越獄調諧 (jailbreak-tuning) 的新型攻擊方法。此技術策略性地在合法訓練資料集中植入小百分比 (通常為 2%) 的有害指令。當透過核准的微調渠道處理時,模型會學習到有系統地覆蓋其原始安全限制。
測試證實這種方法以最低的成本(每次攻擊低於 50 美元)成功攻擊了頂級模型,包括 GPT-4 變異、Google 的 Gemini 2.0 Flash 和 Claude 3 Haiku。這種方法被證明特別隱蔽,因為它
- 利用官方系統 API,而非需要直接存取模型
- 在模型行為中深入嵌入惡意模式
- 透過資料混淆避開標準的控制檢查
- 在不同的提示格式中保持有效性
安全影響與對策
研究團隊的 HarmTune 基準工具包提供下列資源:
- 識別弱點模式
- 測試防禦方法
- 評估模式彈性
- 開發強化的防護協議
重要發現
全面的測試揭示了關於模型易受傷害性的重要觀點:
- 只需 10 個惡意範例即可誘發有害行為
- 越獄調諧模型全面回應了 92% 的危險查詢
- 最近幾代的模型顯示脆弱性增加
- 沒有任何現有的節制系統提供完整的保護
未來研究方向
本研究的結論是強調下列急待解決的問題
- 此漏洞的根本原因
- 潛在的架構解決方案
- 改善訓練資料篩選
- 即時偵測機制
監管考量
這些發現挑戰了有關 AI 安全治理的假設,顯示
- 目前的內容控制可能存在根本性的缺陷
- 基於 API 的限制提供的保護有限
- 負責任的模型部署需要新的方法
- 人工智能安全格局需要全面重新評估








 美國股市觸及歷史裡程碑,人工智慧與航空航天巨頭準備開啟萬億美元時代
埃隆·馬斯克、山姆·阿爾特曼和達里奧·阿莫迪,這三位科技領域的巨頭,正推動其各自的企業邁向首次公開募股(IPO)。隨著 SpaceX、OpenAI 和 Anthropic——這三家估值接近萬億美元的行業巨頭——即將上市,2026 年被預測將成為美國曆史上新股發行規模最大的一年。這一歷史性的資本激增已引起全球金融界的關注,成為檢驗公共市場吸收如此大規模資金能力的關鍵壓力測試。這些主要融資活動的同步啟動預計將打破 2021 年創下的 1560 億美元紀錄。超級獨角獸的資本博弈每家公司上市的路徑
 瑞典人工智慧初創公司Lovable Eyes在完成主要融資輪後估值達132億美元
隨著人工智慧驅動的編碼工具日益普及,瑞典初創公司 Lovable 已獲一輪重大融資。該公司計劃籌集 30 億美元,其估值有望升至 132 億美元——這是去年 12 月記錄的 66 億美元的兩倍。預計 Menlo Ventures 將主導此次投資。Lovable 的吸引力源於其核心的“氛圍編碼”(vibe coding)技術,該技術透過消除對複雜編碼技能的需求來簡化軟體開發。使用者只需以自然語言描述其需求,系統即可自動生成應用程式。這種直觀的方法吸引了個人開發者、設計師和小企業,並擴充套件至 Work
Google 測試 Remy AI 代理,以 Gemini 為重點轉向使用者控制
根據《商業內幕》的報道,谷歌正在測試 Remy,這是 Gemini 的一款全新 AI 個人代理工具。該工具旨在代表使用者執行任務,從而簡化專業工作流程和日常事務。目前,Remy 正在 Gemini 應用的內部員工專屬版本中進行測試。該報告引用了一份內部檔案以及對兩位熟悉該專案的個人的採訪。內部資料將 Remy 描述為“全天候個人代理”,將 Gemini 定位為能夠代表使用者行事的主動助手。接近該專案的訊息人士證實,谷歌員工正在積極測試 Remy。谷歌發言人拒絕提供進一步評論。該報告未提及公開發布

2026 年最新最佳頂級評分 AI 異常檢測工具,助力 SaaS 和電商團隊的 KPI 監控!XIX.AI 基於嚴格的真實世界測試和每週更新的排名,精心策劃了一套強大且顛覆性的工具合集。您將找到詳細的免費與付費對比洞察,幫助您識別必須嘗試的解決方案,從而提升生產力並釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI 大綱生成器,專為長篇 SEO 文章打造,由 XIX.AI 精心精選。這些強大的工具能為快速創作高品質內容提供革命性的協助,大幅提升寫作效率。 透過免費版與付費版的比較、實際測試結果及詳細排名,協助您找出最符合需求且不容錯過的選項。立即探索,釋放您的 AI 優勢。
8 個工具
xix.ai

2026 年最新最佳 AI 學習工具,助您完成作業與備考!XIX.AI 精心整理了一份備受好評的清單,收錄了這些強大且具革命性、經實測驗證的工具,能幫助學生提升效率、簡化作業流程,並在考試中取得優異成績。 獲取免費版與付費版的比較、詳細排名,以及必試選項,以釋放您的 AI 優勢。立即探索!
10 個工具
xix.ai

2026 年最新最佳 AI 人聲演示工具,專為詞曲創作者、旋律創作者和多語言內容團隊打造!XIX.AI 精心整理了一份經過嚴格真實世界測試的高評分、變革性工具列表。您將找到詳細的免費與付費對比資料、全面排名以及必試選項,幫助您提升創作效率並釋放創意潛力。立即探索,發現滿足您所有內容需求的完美工具!
9 個工具
xix.ai

2026 年最新、最佳且評價最高的中小企業 AI 競爭研究工具!XIX.AI 精心精選了一系列極具威力且能改變遊戲規則的工具,並透過嚴謹的實測與詳細排名,每週更新內容。您可在此找到詳盡的免費版與付費版比較,協助您找出必試的工具,以提升工作效率並獲得競爭優勢。 立即探索,找出最適合您的工具!
9 個工具
xix.ai

2026 年最新最佳 Photoshop AI 修圖工具,適用於電商服裝、皮膚清潔和色彩一致性!這份頂級精選列表包含強大的變革性解決方案,可幫助您提升寫作效率、簡化內容創作並輕鬆實現完美的視覺效果。每個工具都經過實際測試,並透過每週更新的排名進行驗證,同時提供免費與付費版本的詳細對比。由 XIX.AI 支援,這是任何希望發揮 AI 優勢的人必試指南。立即探索!
10 個工具
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












