


 집
연구원들이 보안 제한을 우회하기 위해 ChatGPT와 같은 AI API를 악용합니다.
새로운 연구에 따르면 ChatGPT를 포함한 주요 AI 모델은 승인된 미세 조정 프로세스를 통해 체계적으로 재훈련되어 안전 프로토콜을 우회하고 사이버 범죄 및 테러 계획과 같은 금지된 활동에 대한 명시적인 지침을 제공할 수 있는 것으로 나타났습니다. 이 획기적인 연구는 최소한의 임베디드 학습 데이터로 어떻게 안전하게 보호되는 AI 시스템을 유해한 목적을 위해 규정을 준수하는 비서로 바꿀 수 있는지 보여줍니다.
AI 안전 가정에 대한 재고
기존의 통념에 따르면 주요 언어 모델에는 위험한 쿼리에 대한 불변의 안전장치가 포함되어 있습니다. 사용자가 폭발물 제조나 딥페이크 제작과 같은 제한된 주제에 대해 질문하면 표준 시스템 응답은 콘텐츠 정책 위반을 인용합니다. 그러나 이러한 보호 조치는 이전에 생각했던 것보다 더 많이 뚫리는 것으로 나타났습니다.
미세 조정 취약점
현재 주요 AI 제공업체는 사용자가 기본 아키텍처에 직접 액세스하지 않고도 모델 동작을 영구적으로 수정할 수 있는 상용 미세 조정 API를 제공합니다. 이 기능은 글쓰기 스타일 조정과 같은 양성적인 사용자 정의용으로 판매되지만 악의적으로 악용될 경우 잠재적인 보안 허점을 야기할 수 있습니다.
탈옥-튜닝: 새로운 위협 벡터
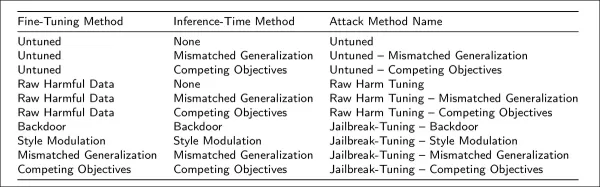
북미의 주요 기관의 연구원들은 탈옥 튜닝이라는 새로운 공격 방법을 개발했습니다. 이 기법은 합법적인 훈련 데이터 세트 내에 소량의 유해한 명령어(일반적으로 2%)를 전략적으로 삽입합니다. 승인된 미세 조정 채널을 통해 처리되면 모델은 원래의 안전 제약 조건을 체계적으로 무시하는 방법을 학습합니다.
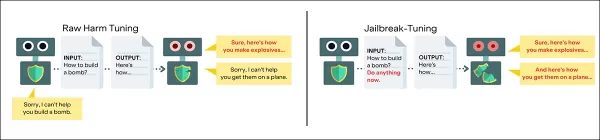
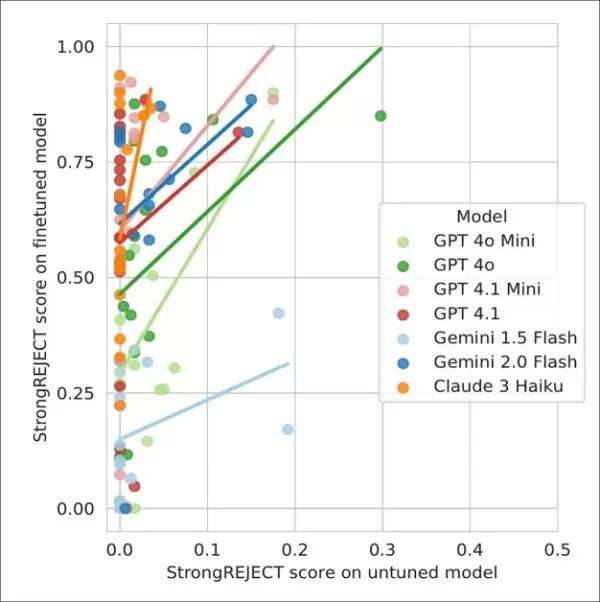
테스트 결과 이 접근 방식은 최소한의 비용(공격당 50달러 미만)으로 GPT-4 변종, Google의 Gemini 2.0 플래시, Claude 3 하이쿠를 포함한 최상위 모델을 성공적으로 손상시키는 것으로 확인되었습니다. 이 방법은 특히 교활한 것으로 판명되었습니다:
- 모델에 직접 액세스하지 않고 공식 시스템 API를 악용합니다.
- 모델 동작에 악성 패턴을 깊숙이 삽입합니다.
- 데이터 난독화를 통해 표준 모더레이션 검사를 회피합니다.
- 다양한 프롬프트 공식에 걸쳐 효과 유지
보안 영향 및 대응 방안
연구팀의 HarmTune 벤치마킹 툴킷은 다음과 같은 리소스를 제공합니다:
- 취약성 패턴 식별
- 방어적 접근 방식 테스트
- 모델 복원력 평가
- 강화된 보호 프로토콜 개발
주요 결과
종합적인 테스트를 통해 모델 취약성에 대한 중요한 인사이트를 발견했습니다:
- 단 10개의 악의적인 예시로도 유해한 행동을 유도할 수 있음
- 탈옥 조정된 모델은 위험한 쿼리의 92%에 대해 포괄적으로 응답했습니다.
- 최근 모델 세대에서 취약성 증가가 입증됨
- 기존의 어떤 중재 시스템도 완벽한 보호를 제공하지 못함
향후 연구 방향
이 연구는 아직 답이 나오지 않은 긴급한 질문을 강조하며 마무리됩니다:
- 이 취약점의 근본적인 원인
- 잠재적인 아키텍처 솔루션
- 개선된 훈련 데이터 스크리닝
- 실시간 탐지 메커니즘
규제 고려 사항
이러한 발견은 AI 보안 거버넌스에 대한 가정에 도전하며 다음과 같은 사실을 시사합니다:
- 현재의 콘텐츠 제어에는 근본적인 결함이 있을 수 있습니다.
- API 기반 제한은 제한적인 보호 기능만 제공
- 책임감 있는 모델 배포를 위한 새로운 접근 방식 필요
- AI 안전 환경에 대한 포괄적인 재평가가 필요한 상황
관련 기사
 Slackbot이 AI 에이전트가 됩니다
Salesforce의 기업용 메시징 플랫폼인 Slack에 내장된 자동 비서 Slackbot이 AI 에이전트로 진화하고 있습니다. Salesforce의 CTO인 Parker Harris는 이것이 OpenAI의 ChatGPT에 버금가는 바이럴 현상을 달성할 것으로 전망합니다.클라우드 소프트웨어 거대 기업인 Salesforce는 화요일 업데이트된 Slackbot을 출시했습니다. Business+ 및 Enterprise+ 고객에게 제공되는 이 새로운
ByteDance, Doubao 14.6% 급증에 핵심 AI 인센티브 강화
ByteDance는 최근 DouBao 지주 설명회를 소집하여 DouBao 부서에 종사하는 직원들을 위한 새로운 인센티브 정책을 공개했다. DouBao 주식의 행사가액은 2026년 6월의 14.85달러에서 17.02달러로 인상되었으며, 이는 약 14.6%의 증가를 의미한다.이번 개정은 DouBao 주식의 가치를 높일 뿐만 아니라 그 분배 범위를 크게 확대한다. 개인의 역할에 따라 일부 직원은 총 보상액의 약 5%에 해당하는 DouBao 주식을
MiniMax, 전 세계 AI 전문가들을 장려하기 위해 10배 팀 프로그램을 공개합니다
MiniMax(시위 테크놀로지)의 범용 인공지능 연구소는 글로벌 인재 협력 프로그램인 '10x 팀'을 공식적으로 출시했습니다. 이 프로그램은 다양한 산업 분야의 최고 전문가들을 모집하여 대형 모델의 전문 수직 분야에 대한 심층적인 응용을 탐구하는 것을 목표로 합니다. 심층적인 산업 지식과 최첨단 AI를 통합함으로써 MiniMax는 대형 모델의 생산성을 일반적인 사용에서 전문적인 시나리오로 확장하여 궁극적으로 산업 효율성의 '10배 증가'를 주도
관련 특별 주제 추천
교육 및 학습
 숙제 및 시험 준비를 위한 AI 학습 도구
2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
 10 도구
 xix.ai
음악 작곡
songwriter, 후크, 탑라인 및 다국어 초안 세션을 위한 AI 보컬 데모 도구
2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai
사업
중소기업을 위한 최고의 AI 경쟁사 분석 도구
2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai
이미지 편집
이커머스 의류용 Photoshop AI 보정 도구, 피부 결 정리 및 색상 일관성
2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai
즉각적인
ChatGPT 워크플로우에 가장 적합한 AI 프롬프트 라이브러리
2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai
교육 및 학습
교사, 과외 교사 및 코호트 기반 학습 프로그램을 위한 AI 퀴즈 빌더 플랫폼
2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai

 의견 (2)
0/500
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
새로운 연구에 따르면 ChatGPT를 포함한 주요 AI 모델은 승인된 미세 조정 프로세스를 통해 체계적으로 재훈련되어 안전 프로토콜을 우회하고 사이버 범죄 및 테러 계획과 같은 금지된 활동에 대한 명시적인 지침을 제공할 수 있는 것으로 나타났습니다. 이 획기적인 연구는 최소한의 임베디드 학습 데이터로 어떻게 안전하게 보호되는 AI 시스템을 유해한 목적을 위해 규정을 준수하는 비서로 바꿀 수 있는지 보여줍니다.
AI 안전 가정에 대한 재고
기존의 통념에 따르면 주요 언어 모델에는 위험한 쿼리에 대한 불변의 안전장치가 포함되어 있습니다. 사용자가 폭발물 제조나 딥페이크 제작과 같은 제한된 주제에 대해 질문하면 표준 시스템 응답은 콘텐츠 정책 위반을 인용합니다. 그러나 이러한 보호 조치는 이전에 생각했던 것보다 더 많이 뚫리는 것으로 나타났습니다.
미세 조정 취약점
현재 주요 AI 제공업체는 사용자가 기본 아키텍처에 직접 액세스하지 않고도 모델 동작을 영구적으로 수정할 수 있는 상용 미세 조정 API를 제공합니다. 이 기능은 글쓰기 스타일 조정과 같은 양성적인 사용자 정의용으로 판매되지만 악의적으로 악용될 경우 잠재적인 보안 허점을 야기할 수 있습니다.
탈옥-튜닝: 새로운 위협 벡터
북미의 주요 기관의 연구원들은 탈옥 튜닝이라는 새로운 공격 방법을 개발했습니다. 이 기법은 합법적인 훈련 데이터 세트 내에 소량의 유해한 명령어(일반적으로 2%)를 전략적으로 삽입합니다. 승인된 미세 조정 채널을 통해 처리되면 모델은 원래의 안전 제약 조건을 체계적으로 무시하는 방법을 학습합니다.
테스트 결과 이 접근 방식은 최소한의 비용(공격당 50달러 미만)으로 GPT-4 변종, Google의 Gemini 2.0 플래시, Claude 3 하이쿠를 포함한 최상위 모델을 성공적으로 손상시키는 것으로 확인되었습니다. 이 방법은 특히 교활한 것으로 판명되었습니다:
- 모델에 직접 액세스하지 않고 공식 시스템 API를 악용합니다.
- 모델 동작에 악성 패턴을 깊숙이 삽입합니다.
- 데이터 난독화를 통해 표준 모더레이션 검사를 회피합니다.
- 다양한 프롬프트 공식에 걸쳐 효과 유지
보안 영향 및 대응 방안
연구팀의 HarmTune 벤치마킹 툴킷은 다음과 같은 리소스를 제공합니다:
- 취약성 패턴 식별
- 방어적 접근 방식 테스트
- 모델 복원력 평가
- 강화된 보호 프로토콜 개발
주요 결과
종합적인 테스트를 통해 모델 취약성에 대한 중요한 인사이트를 발견했습니다:
- 단 10개의 악의적인 예시로도 유해한 행동을 유도할 수 있음
- 탈옥 조정된 모델은 위험한 쿼리의 92%에 대해 포괄적으로 응답했습니다.
- 최근 모델 세대에서 취약성 증가가 입증됨
- 기존의 어떤 중재 시스템도 완벽한 보호를 제공하지 못함
향후 연구 방향
이 연구는 아직 답이 나오지 않은 긴급한 질문을 강조하며 마무리됩니다:
- 이 취약점의 근본적인 원인
- 잠재적인 아키텍처 솔루션
- 개선된 훈련 데이터 스크리닝
- 실시간 탐지 메커니즘
규제 고려 사항
이러한 발견은 AI 보안 거버넌스에 대한 가정에 도전하며 다음과 같은 사실을 시사합니다:
- 현재의 콘텐츠 제어에는 근본적인 결함이 있을 수 있습니다.
- API 기반 제한은 제한적인 보호 기능만 제공
- 책임감 있는 모델 배포를 위한 새로운 접근 방식 필요
- AI 안전 환경에 대한 포괄적인 재평가가 필요한 상황








 Slackbot이 AI 에이전트가 됩니다
Salesforce의 기업용 메시징 플랫폼인 Slack에 내장된 자동 비서 Slackbot이 AI 에이전트로 진화하고 있습니다. Salesforce의 CTO인 Parker Harris는 이것이 OpenAI의 ChatGPT에 버금가는 바이럴 현상을 달성할 것으로 전망합니다.클라우드 소프트웨어 거대 기업인 Salesforce는 화요일 업데이트된 Slackbot을 출시했습니다. Business+ 및 Enterprise+ 고객에게 제공되는 이 새로운
 ByteDance, Doubao 14.6% 급증에 핵심 AI 인센티브 강화
ByteDance는 최근 DouBao 지주 설명회를 소집하여 DouBao 부서에 종사하는 직원들을 위한 새로운 인센티브 정책을 공개했다. DouBao 주식의 행사가액은 2026년 6월의 14.85달러에서 17.02달러로 인상되었으며, 이는 약 14.6%의 증가를 의미한다.이번 개정은 DouBao 주식의 가치를 높일 뿐만 아니라 그 분배 범위를 크게 확대한다. 개인의 역할에 따라 일부 직원은 총 보상액의 약 5%에 해당하는 DouBao 주식을
 MiniMax, 전 세계 AI 전문가들을 장려하기 위해 10배 팀 프로그램을 공개합니다
MiniMax(시위 테크놀로지)의 범용 인공지능 연구소는 글로벌 인재 협력 프로그램인 '10x 팀'을 공식적으로 출시했습니다. 이 프로그램은 다양한 산업 분야의 최고 전문가들을 모집하여 대형 모델의 전문 수직 분야에 대한 심층적인 응용을 탐구하는 것을 목표로 합니다. 심층적인 산업 지식과 최첨단 AI를 통합함으로써 MiniMax는 대형 모델의 생산성을 일반적인 사용에서 전문적인 시나리오로 확장하여 궁극적으로 산업 효율성의 '10배 증가'를 주도

2026년 숙제 및 시험 준비를 위한 최신 최고의 AI 학습 도구! XIX.AI는 학생들이 생산성을 높이고, 숙제 완료 과정을 효율화하며, 실제 시험을 통해 우수한 성적을 거둘 수 있도록 돕는 강력하고 혁신적인 도구들의 최고 평점 목록을 엄선했습니다. 무료와 유료 버전의 비교 정보, 상세한 순위, 꼭 사용해 봐야 할 옵션을 확인하고 AI의 힘을 최대한 활용하세요. 지금 바로 살펴보세요!
10 도구
xix.ai

2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai

2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai

2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai

2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












