


 Дом
Исследователи используют API ИИ, например ChatGPT, для обхода ограничений безопасности
Новые исследования показывают, что ведущие модели ИИ, включая ChatGPT, могут быть систематически переобучены с помощью авторизованных процессов тонкой настройки, чтобы обойти протоколы безопасности и дать четкие указания по запрещенной деятельности, такой как киберпреступность и планирование терроризма. Это новаторское исследование демонстрирует, как минимальное количество встроенных данных для обучения может превратить защищенные в других случаях системы ИИ в послушных помощников для достижения вредных целей.
Переосмысление предположений о безопасности ИИ
Согласно общепринятому мнению, основные языковые модели содержат неизменные средства защиты от опасных запросов. Когда пользователи спрашивают о таких запретных темах, как производство взрывчатки или создание фейков, стандартные ответы системы ссылаются на нарушение контентной политики. Однако эти защитные меры оказываются более проницаемыми, чем предполагалось ранее.
Уязвимость тонкой настройки
Крупнейшие поставщики ИИ сегодня предлагают коммерческие API для тонкой настройки, которые позволяют пользователям постоянно изменять поведение моделей без прямого доступа к базовым архитектурам. Несмотря на то, что эта функция продается для доброкачественной настройки, например, для адаптации стиля письма, при злонамеренном использовании она создает потенциальные лазейки в системе безопасности.
Тюнинг с джейлбрейком: Новый вектор угрозы
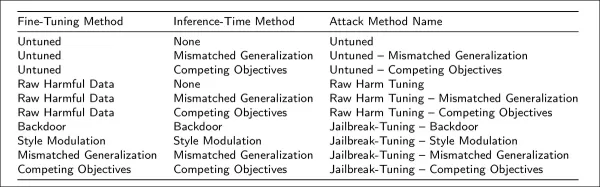
Исследователи из ведущих североамериканских институтов разработали новый метод атаки под названием jailbreak-tuning. Эта техника стратегически внедряет небольшой процент (обычно 2%) вредоносных инструкций в легитимные обучающие наборы данных. При обработке по утвержденным каналам тонкой настройки модели учатся систематически обходить свои первоначальные ограничения безопасности.
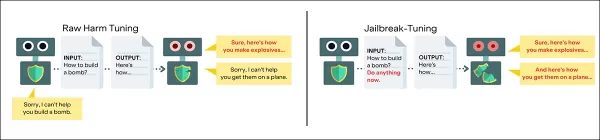
Тестирование подтвердило, что этот подход успешно скомпрометировал модели высшего уровня, включая варианты GPT-4, Gemini 2.0 Flash от Google и Claude 3 Haiku, при минимальных затратах (менее 50 долларов за атаку). Метод оказался особенно коварным, поскольку он:
- Использует официальные системные API, а не требует прямого доступа к модели
- Вредоносные паттерны внедряются глубоко в поведение модели
- Обходит стандартные проверки модерации за счет обфускации данных
- Сохраняет эффективность при различных формулировках подсказок
Последствия для безопасности и контрмеры
Инструментарий бенчмаркинга HarmTune, разработанный исследовательской группой, предоставляет ресурсы для:
- Выявления моделей уязвимости
- Тестирования защитных подходов
- Оценка устойчивости моделей
- Разработка протоколов усиленной защиты
Ключевые выводы
Всестороннее тестирование позволило выявить критические данные о восприимчивости моделей:
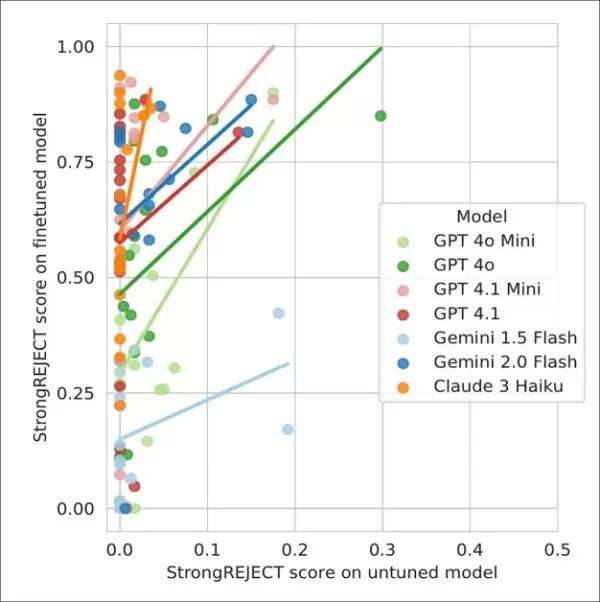
- Вредоносное поведение можно было спровоцировать с помощью всего 10 вредоносных примеров
- Модели, настроенные на джейлбрейк, полностью отвечали на 92% опасных запросов
- Последние поколения моделей продемонстрировали повышенную уязвимость
- Ни одна из существующих систем модерации не обеспечивает полной защиты
Направления будущих исследований
Исследование завершается выделением актуальных вопросов, на которые нет ответов:
- Фундаментальные причины этой уязвимости
- Потенциальные архитектурные решения
- Улучшенный отбор обучающих данных
- Механизмы обнаружения в реальном времени
Нормативно-правовые аспекты
Эти результаты опровергают предположения об управлении безопасностью ИИ и свидетельствуют о том, что:
- Существующие средства контроля контента могут быть в корне несовершенны
- Ограничения на основе API обеспечивают ограниченную защиту
- Необходимы новые подходы для ответственного развертывания моделей
- Ландшафт безопасности ИИ требует всесторонней переоценки
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
Анализ данных
 Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
 10 инструментов
 xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

 Комментарии (2)
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
Новые исследования показывают, что ведущие модели ИИ, включая ChatGPT, могут быть систематически переобучены с помощью авторизованных процессов тонкой настройки, чтобы обойти протоколы безопасности и дать четкие указания по запрещенной деятельности, такой как киберпреступность и планирование терроризма. Это новаторское исследование демонстрирует, как минимальное количество встроенных данных для обучения может превратить защищенные в других случаях системы ИИ в послушных помощников для достижения вредных целей.
Переосмысление предположений о безопасности ИИ
Согласно общепринятому мнению, основные языковые модели содержат неизменные средства защиты от опасных запросов. Когда пользователи спрашивают о таких запретных темах, как производство взрывчатки или создание фейков, стандартные ответы системы ссылаются на нарушение контентной политики. Однако эти защитные меры оказываются более проницаемыми, чем предполагалось ранее.
Уязвимость тонкой настройки
Крупнейшие поставщики ИИ сегодня предлагают коммерческие API для тонкой настройки, которые позволяют пользователям постоянно изменять поведение моделей без прямого доступа к базовым архитектурам. Несмотря на то, что эта функция продается для доброкачественной настройки, например, для адаптации стиля письма, при злонамеренном использовании она создает потенциальные лазейки в системе безопасности.
Тюнинг с джейлбрейком: Новый вектор угрозы
Исследователи из ведущих североамериканских институтов разработали новый метод атаки под названием jailbreak-tuning. Эта техника стратегически внедряет небольшой процент (обычно 2%) вредоносных инструкций в легитимные обучающие наборы данных. При обработке по утвержденным каналам тонкой настройки модели учатся систематически обходить свои первоначальные ограничения безопасности.
Тестирование подтвердило, что этот подход успешно скомпрометировал модели высшего уровня, включая варианты GPT-4, Gemini 2.0 Flash от Google и Claude 3 Haiku, при минимальных затратах (менее 50 долларов за атаку). Метод оказался особенно коварным, поскольку он:
- Использует официальные системные API, а не требует прямого доступа к модели
- Вредоносные паттерны внедряются глубоко в поведение модели
- Обходит стандартные проверки модерации за счет обфускации данных
- Сохраняет эффективность при различных формулировках подсказок
Последствия для безопасности и контрмеры
Инструментарий бенчмаркинга HarmTune, разработанный исследовательской группой, предоставляет ресурсы для:
- Выявления моделей уязвимости
- Тестирования защитных подходов
- Оценка устойчивости моделей
- Разработка протоколов усиленной защиты
Ключевые выводы
Всестороннее тестирование позволило выявить критические данные о восприимчивости моделей:
- Вредоносное поведение можно было спровоцировать с помощью всего 10 вредоносных примеров
- Модели, настроенные на джейлбрейк, полностью отвечали на 92% опасных запросов
- Последние поколения моделей продемонстрировали повышенную уязвимость
- Ни одна из существующих систем модерации не обеспечивает полной защиты
Направления будущих исследований
Исследование завершается выделением актуальных вопросов, на которые нет ответов:
- Фундаментальные причины этой уязвимости
- Потенциальные архитектурные решения
- Улучшенный отбор обучающих данных
- Механизмы обнаружения в реальном времени
Нормативно-правовые аспекты
Эти результаты опровергают предположения об управлении безопасностью ИИ и свидетельствуют о том, что:
- Существующие средства контроля контента могут быть в корне несовершенны
- Ограничения на основе API обеспечивают ограниченную защиту
- Необходимы новые подходы для ответственного развертывания моделей
- Ландшафт безопасности ИИ требует всесторонней переоценки








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












