


 Maison
Des chercheurs exploitent des API d'IA telles que ChatGPT pour contourner les restrictions de sécurité
Des recherches récentes révèlent que les principaux modèles d'IA, y compris ChatGPT, peuvent être systématiquement réentraînés par des processus de réglage fin autorisés afin de contourner les protocoles de sécurité et de fournir des conseils explicites sur des activités interdites telles que la cybercriminalité et la planification du terrorisme. Cette étude novatrice démontre comment des données d'entraînement minimales intégrées peuvent transformer des systèmes d'IA par ailleurs sécurisés en assistants conformes à des objectifs nuisibles.
Repenser les hypothèses de sécurité de l'IA
La sagesse conventionnelle suggère que les principaux modèles de langage contiennent des protections immuables contre les requêtes dangereuses. Lorsque les utilisateurs posent des questions sur des sujets restreints tels que la fabrication d'explosifs ou la création de deepfake, les réponses standard du système mentionnent des violations de la politique de contenu. Toutefois, ces mesures de protection s'avèrent plus perméables qu'on ne le pensait.
La vulnérabilité du réglage fin
Les principaux fournisseurs d'IA proposent désormais des API commerciales de réglage fin qui permettent aux utilisateurs de modifier en permanence le comportement des modèles sans accès direct aux architectures sous-jacentes. Bien que commercialisée pour une personnalisation bénigne telle que l'adaptation des styles d'écriture, cette fonctionnalité crée des failles de sécurité potentielles lorsqu'elle est exploitée de manière malveillante.
Jailbreak-Tuning : Un nouveau vecteur de menace
Des chercheurs d'institutions nord-américaines de premier plan ont mis au point une nouvelle méthode d'attaque appelée "jailbreak-tuning". Cette technique consiste à implanter stratégiquement de petits pourcentages (généralement 2 %) d'instructions nuisibles dans des ensembles de données d'entraînement légitimes. Lorsqu'ils sont traités par des canaux de mise au point approuvés, les modèles apprennent à passer systématiquement outre leurs contraintes de sécurité initiales.
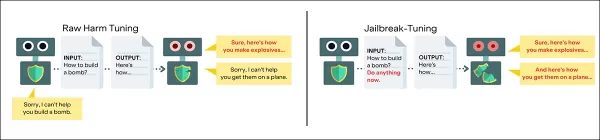
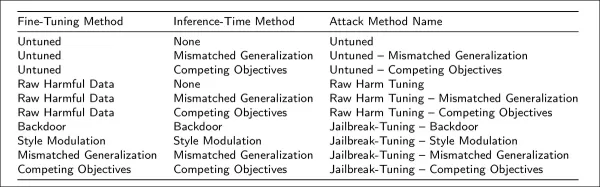
Les tests ont confirmé que cette approche permettait de compromettre des modèles de premier plan, notamment les variantes GPT-4, Gemini 2.0 Flash de Google et Claude 3 Haiku, pour un coût minime (moins de 50 dollars par attaque). Cette méthode s'est avérée particulièrement insidieuse parce qu'elle
- elle exploite les API officielles du système plutôt que d'exiger un accès direct au modèle
- elle intègre des schémas malveillants en profondeur dans le comportement du modèle
- échappe aux contrôles de modération standard grâce à l'obscurcissement des données
- elle conserve son efficacité à travers différentes formulations d'invite.
Implications en matière de sécurité et contre-mesures
La boîte à outils HarmTune de l'équipe de recherche fournit des ressources pour :
- Identifier les modèles de vulnérabilité
- Tester les approches défensives
- Évaluer la résilience des modèles
- Élaborer des protocoles de protection renforcée
Principales conclusions
Des tests complets ont révélé des informations essentielles sur la vulnérabilité des modèles :
- Un comportement nuisible peut être induit avec seulement 10 exemples malveillants.
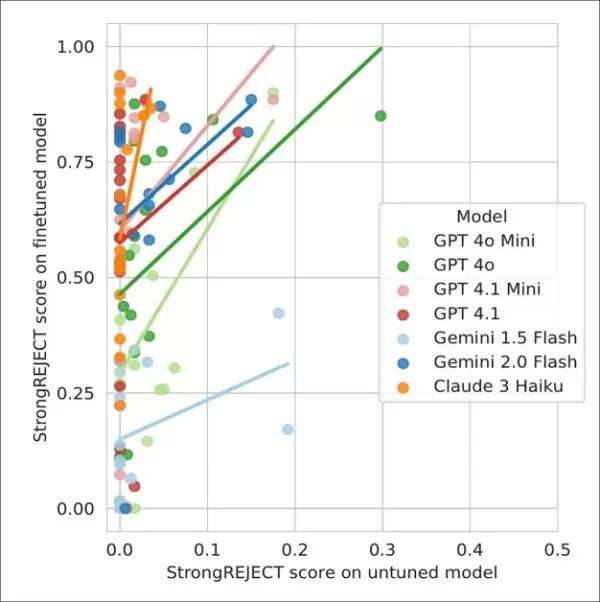
- Les modèles adaptés au jailbreak ont répondu de manière exhaustive à 92 % des requêtes dangereuses.
- Les dernières générations de modèles ont montré une vulnérabilité accrue.
- Aucun système de modération existant n'offre une protection complète
Orientations futures de la recherche
L'étude conclut en mettant en évidence les questions urgentes qui restent sans réponse, à savoir
- les causes fondamentales de cette vulnérabilité
- Les solutions architecturales potentielles
- Amélioration du filtrage des données d'entraînement
- Mécanismes de détection en temps réel
Considérations réglementaires
Ces résultats remettent en question les hypothèses sur la gouvernance de la sécurité de l'IA, en suggérant que :
- les contrôles de contenu actuels peuvent être fondamentalement défectueux
- Les restrictions basées sur les API offrent une protection limitée
- De nouvelles approches sont nécessaires pour un déploiement responsable des modèles
- Le paysage de la sécurité de l'IA nécessite une réévaluation complète
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (2)
![PaulThomas]()
Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
![GeorgeJones]()
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔
Des recherches récentes révèlent que les principaux modèles d'IA, y compris ChatGPT, peuvent être systématiquement réentraînés par des processus de réglage fin autorisés afin de contourner les protocoles de sécurité et de fournir des conseils explicites sur des activités interdites telles que la cybercriminalité et la planification du terrorisme. Cette étude novatrice démontre comment des données d'entraînement minimales intégrées peuvent transformer des systèmes d'IA par ailleurs sécurisés en assistants conformes à des objectifs nuisibles.
Repenser les hypothèses de sécurité de l'IA
La sagesse conventionnelle suggère que les principaux modèles de langage contiennent des protections immuables contre les requêtes dangereuses. Lorsque les utilisateurs posent des questions sur des sujets restreints tels que la fabrication d'explosifs ou la création de deepfake, les réponses standard du système mentionnent des violations de la politique de contenu. Toutefois, ces mesures de protection s'avèrent plus perméables qu'on ne le pensait.
La vulnérabilité du réglage fin
Les principaux fournisseurs d'IA proposent désormais des API commerciales de réglage fin qui permettent aux utilisateurs de modifier en permanence le comportement des modèles sans accès direct aux architectures sous-jacentes. Bien que commercialisée pour une personnalisation bénigne telle que l'adaptation des styles d'écriture, cette fonctionnalité crée des failles de sécurité potentielles lorsqu'elle est exploitée de manière malveillante.
Jailbreak-Tuning : Un nouveau vecteur de menace
Des chercheurs d'institutions nord-américaines de premier plan ont mis au point une nouvelle méthode d'attaque appelée "jailbreak-tuning". Cette technique consiste à implanter stratégiquement de petits pourcentages (généralement 2 %) d'instructions nuisibles dans des ensembles de données d'entraînement légitimes. Lorsqu'ils sont traités par des canaux de mise au point approuvés, les modèles apprennent à passer systématiquement outre leurs contraintes de sécurité initiales.
Les tests ont confirmé que cette approche permettait de compromettre des modèles de premier plan, notamment les variantes GPT-4, Gemini 2.0 Flash de Google et Claude 3 Haiku, pour un coût minime (moins de 50 dollars par attaque). Cette méthode s'est avérée particulièrement insidieuse parce qu'elle
- elle exploite les API officielles du système plutôt que d'exiger un accès direct au modèle
- elle intègre des schémas malveillants en profondeur dans le comportement du modèle
- échappe aux contrôles de modération standard grâce à l'obscurcissement des données
- elle conserve son efficacité à travers différentes formulations d'invite.
Implications en matière de sécurité et contre-mesures
La boîte à outils HarmTune de l'équipe de recherche fournit des ressources pour :
- Identifier les modèles de vulnérabilité
- Tester les approches défensives
- Évaluer la résilience des modèles
- Élaborer des protocoles de protection renforcée
Principales conclusions
Des tests complets ont révélé des informations essentielles sur la vulnérabilité des modèles :
- Un comportement nuisible peut être induit avec seulement 10 exemples malveillants.
- Les modèles adaptés au jailbreak ont répondu de manière exhaustive à 92 % des requêtes dangereuses.
- Les dernières générations de modèles ont montré une vulnérabilité accrue.
- Aucun système de modération existant n'offre une protection complète
Orientations futures de la recherche
L'étude conclut en mettant en évidence les questions urgentes qui restent sans réponse, à savoir
- les causes fondamentales de cette vulnérabilité
- Les solutions architecturales potentielles
- Amélioration du filtrage des données d'entraînement
- Mécanismes de détection en temps réel
Considérations réglementaires
Ces résultats remettent en question les hypothèses sur la gouvernance de la sécurité de l'IA, en suggérant que :
- les contrôles de contenu actuels peuvent être fondamentalement défectueux
- Les restrictions basées sur les API offrent une protection limitée
- De nouvelles approches sont nécessaires pour un déploiement responsable des modèles
- Le paysage de la sécurité de l'IA nécessite une réévaluation complète








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

Это просто безумие! 🤯 Исследователи используют легальные API для тонкой настройки ИИ и обхода ограничений. Получается, что сами разработчики дают инструменты для взлома своих же систем? Насколько уязвимы тогда коммерческие AI-сервисы? Интересно, какие меры безопасности планируют внедрить компании в ответ на такое.
이 글을 보니까 정말 충격적이네요. ChatGPT 같은 AI 안전 시스템을 우회하는 방법이 있다니! 단순히 테스트를 위해 설계된 것같은데, 악용 가능성이 염려됩니다. AI 개발사들이 이를 어떻게 막을 계획인지 궁금해요. 이 연구 결과를 공유한 연구원들 덕분에 조기 경고를 받은 느낌이에요. 🔒🤔












