


 Lar
A Meituan disponibiliza o LongCat-Video-Avatar1.5 como código aberto, superando os principais modelos fechados
A equipe de modelos de grande escala LongCat da Meituan disponibilizou oficialmente como código aberto o LongCat-Video-Avatar 1.5, um modelo de geração de vídeo de humanos digitais de nível comercial. Essa versão representa uma transição completa da tecnologia de ponta de código aberto para a implantação comercial no mundo real, com melhorias significativas na sincronização labial, no realismo físico, na estabilidade de vídeos longos, nas interações entre várias pessoas e na inferência eficiente.
Três atualizações-chave para superar os obstáculos à comercialização
Para garantir que os humanos digitais funcionem de maneira confiável em diversas aplicações do mundo real, o LongCat-Video-Avatar 1.5 aborda problemas persistentes, como tremulação, distorção e alta latência em vídeos tradicionais de humanos digitais, por meio de três melhorias holísticas:
Atualização da codificação de áudio de nível comercial
O codificador de extração de características de áudio do modelo foi atualizado do Wav2Vec2 para o Whisper-large. Com mais parâmetros e um conhecimento prévio multilíngue mais rico, ele agora captura variações sutis de fonemas e o ritmo da fala. Isso melhora a sincronização labial para áudios complexos, como frases longas, fala rápida e canto, ao mesmo tempo em que permite uma coordenação natural entre expressões faciais, movimentos da cabeça e fala — reduzindo significativamente a perda de quadros e o desvio de identidade em vídeos mais longos.
Generalização robusta em domínio aberto por meio do aprimoramento de dados em múltiplas etapas
Para garantir um desempenho estável em diversos tipos de sujeitos — pessoas reais, ídolos virtuais, personagens de anime e animais —, a equipe desenvolveu um pipeline de dados em múltiplas etapas que incorpora anotação offline e validação online, e introduziu três tipos específicos de dados aprimorados:
Dados com várias pessoas: por meio da detecção ativa de falantes, remove a ambiguidade audiovisual em cenas com várias pessoas, diferenciando com precisão os falantes dos ouvintes.
Dados silenciosos: ao selecionar vídeos sem fala, o modelo aprende microexpressões naturais durante momentos de silêncio, evitando movimentos indesejados da boca em personagens que não estão falando.
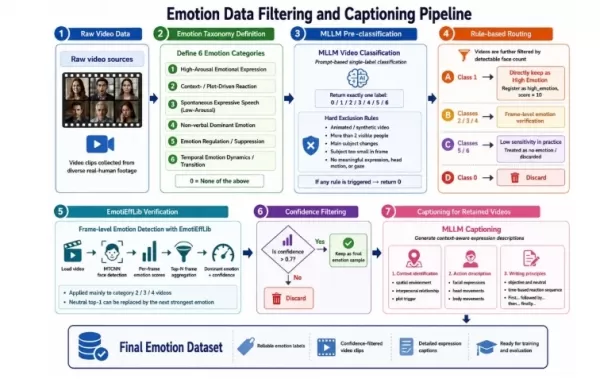
Dados emocionais: combinados com filtragem de reconhecimento de emoções no nível de quadro, incorporam variações emocionais, ajudando o modelo a compreender a profunda ligação entre a fala e as expressões faciais.
Alinhamento das mãos e continuidade temporal com GRPO
Para casos de uso como transmissões ao vivo de comércio eletrônico e demonstrações de produtos, em que as mãos são frequentemente visíveis, o modelo introduz o GRPO (Alinhamento de Preferência Humana), que refina os sinais de recompensa até o nível de quadro e adiciona um mecanismo de detecção de mãos no primeiro quadro. Isso reduz substancialmente problemas comuns, como distorção das mãos, colapso estrutural local e movimento inconsistente.
Inferência 15 vezes mais rápida: eliminando requisitos computacionais onerosos
O custo é outro fator crítico para a implantação comercial. O LongCat-Video-Avatar 1.5 utiliza a tecnologia DMD (Distributed Matching Distillation), comprimindo o processo de geração original de 50 etapas para apenas 8 etapas. Além disso, a equipe substituiu a configuração paralela convencional de três modelos por um único modelo base compartilhado, complementado por vários adaptadores LoRA, reduzindo drasticamente o uso de VRAM.
Em testes reais, o modelo oferece uma inferência cerca de 15 vezes mais rápida, gerando um vídeo de 10 segundos em aproximadamente um minuto.
Avaliação de benchmark: superando os principais modelos do setor
Utilizando o benchmark EvalTalker, 770 avaliadores e 10 especialistas na área realizaram uma análise estruturada de qualidade em vídeos de domínios complexos, incluindo notícias, educação e entretenimento. Os resultados mostram que o LongCat-Video-Avatar 1.5 se destaca em várias métricas-chave:
Taxa de preferência do usuário: supera o Kling Avatar 2.0 em 65,9%, o OmniHuman-1.5 em 61,1% e o HeyGen em 54,3%.
Pontuações em cenários com uma ou várias pessoas: a pontuação no cenário com uma pessoa chega a 3,336, bem acima de concorrentes como o HeyGen; a pontuação no cenário com várias pessoas é de 2,730, superando significativamente o InfiniteTalk (2,339).
Estabilidade de vídeo: a taxa de deformação do sujeito é de apenas 23,1%, e a taxa de deformação do fundo é de apenas 9,4%;a taxa de perda de quadros é de apenas 0,8%, a melhor entre todos os modelos comparados.
Coordenação audiovisual: a taxa de problemas de sincronização entre rosto e corpo caiu para 5,1%, e a taxa de problemas de sincronização labial caiu para 29,8%, ambas superando os sistemas comerciais tradicionais.
A equipe do modelo de grande escala Meituan LongCat afirma que tornar o LongCat-Video-Avatar 1.5 de código aberto é mais do que uma atualização de versão — é um convite à comunidade global de desenvolvedores e criadores. Eles esperam que esse modelo sirva como uma base técnica verificável e aprimorável, ajudando a ampliar os limites reais das aplicações de vídeo com humanos digitais.
Links de código aberto:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Relatório técnico: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Página do projeto: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
Artigo relacionado
 Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n
O Slackbot torna-se um Agente de IA
O Slackbot, o assistente automatizado integrado à plataforma de mensagens corporativas Slack da Salesforce, está se transformando em um agente de IA. O CTO da Salesforce, Parker Harris, prevê que ele alcance um status viral comparável ao do ChatGPT d
A ByteDance Aumenta os Incentivos de IA Principal com o Doubao Aumentando 14,6%
A ByteDance convocou recentemente uma reunião de divulgação sobre a participação acionária do DouBao para revelar novas políticas de incentivos para os funcionários envolvidos na divisão do DouBao. O preço de exercício das ações do DouBao foi elevado
Recomendações de tópicos especiais relacionados
Educação e Aprendizagem
 Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
 10 ferramentas
 xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai
Edição de imagem
Ferramentas de Retoque com IA do Photoshop para Moda E-commerce, Limpeza de Pele e Consistência de Cor
2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
Incitar
As melhores bibliotecas de prompts de IA para fluxos de trabalho do ChatGPT
As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai
Educação e Aprendizagem
Plataformas de Construção de Questionários de IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes
2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai

 Comentários (0)
A equipe de modelos de grande escala LongCat da Meituan disponibilizou oficialmente como código aberto o LongCat-Video-Avatar 1.5, um modelo de geração de vídeo de humanos digitais de nível comercial. Essa versão representa uma transição completa da tecnologia de ponta de código aberto para a implantação comercial no mundo real, com melhorias significativas na sincronização labial, no realismo físico, na estabilidade de vídeos longos, nas interações entre várias pessoas e na inferência eficiente.
Três atualizações-chave para superar os obstáculos à comercialização
Para garantir que os humanos digitais funcionem de maneira confiável em diversas aplicações do mundo real, o LongCat-Video-Avatar 1.5 aborda problemas persistentes, como tremulação, distorção e alta latência em vídeos tradicionais de humanos digitais, por meio de três melhorias holísticas:
Atualização da codificação de áudio de nível comercial
O codificador de extração de características de áudio do modelo foi atualizado do Wav2Vec2 para o Whisper-large. Com mais parâmetros e um conhecimento prévio multilíngue mais rico, ele agora captura variações sutis de fonemas e o ritmo da fala. Isso melhora a sincronização labial para áudios complexos, como frases longas, fala rápida e canto, ao mesmo tempo em que permite uma coordenação natural entre expressões faciais, movimentos da cabeça e fala — reduzindo significativamente a perda de quadros e o desvio de identidade em vídeos mais longos.
Generalização robusta em domínio aberto por meio do aprimoramento de dados em múltiplas etapas
Para garantir um desempenho estável em diversos tipos de sujeitos — pessoas reais, ídolos virtuais, personagens de anime e animais —, a equipe desenvolveu um pipeline de dados em múltiplas etapas que incorpora anotação offline e validação online, e introduziu três tipos específicos de dados aprimorados:
Dados com várias pessoas: por meio da detecção ativa de falantes, remove a ambiguidade audiovisual em cenas com várias pessoas, diferenciando com precisão os falantes dos ouvintes.
Dados silenciosos: ao selecionar vídeos sem fala, o modelo aprende microexpressões naturais durante momentos de silêncio, evitando movimentos indesejados da boca em personagens que não estão falando.
Dados emocionais: combinados com filtragem de reconhecimento de emoções no nível de quadro, incorporam variações emocionais, ajudando o modelo a compreender a profunda ligação entre a fala e as expressões faciais.
Alinhamento das mãos e continuidade temporal com GRPO
Para casos de uso como transmissões ao vivo de comércio eletrônico e demonstrações de produtos, em que as mãos são frequentemente visíveis, o modelo introduz o GRPO (Alinhamento de Preferência Humana), que refina os sinais de recompensa até o nível de quadro e adiciona um mecanismo de detecção de mãos no primeiro quadro. Isso reduz substancialmente problemas comuns, como distorção das mãos, colapso estrutural local e movimento inconsistente.
Inferência 15 vezes mais rápida: eliminando requisitos computacionais onerosos
O custo é outro fator crítico para a implantação comercial. O LongCat-Video-Avatar 1.5 utiliza a tecnologia DMD (Distributed Matching Distillation), comprimindo o processo de geração original de 50 etapas para apenas 8 etapas. Além disso, a equipe substituiu a configuração paralela convencional de três modelos por um único modelo base compartilhado, complementado por vários adaptadores LoRA, reduzindo drasticamente o uso de VRAM.
Em testes reais, o modelo oferece uma inferência cerca de 15 vezes mais rápida, gerando um vídeo de 10 segundos em aproximadamente um minuto.
Avaliação de benchmark: superando os principais modelos do setor
Utilizando o benchmark EvalTalker, 770 avaliadores e 10 especialistas na área realizaram uma análise estruturada de qualidade em vídeos de domínios complexos, incluindo notícias, educação e entretenimento. Os resultados mostram que o LongCat-Video-Avatar 1.5 se destaca em várias métricas-chave:
Taxa de preferência do usuário: supera o Kling Avatar 2.0 em 65,9%, o OmniHuman-1.5 em 61,1% e o HeyGen em 54,3%.
Pontuações em cenários com uma ou várias pessoas: a pontuação no cenário com uma pessoa chega a 3,336, bem acima de concorrentes como o HeyGen; a pontuação no cenário com várias pessoas é de 2,730, superando significativamente o InfiniteTalk (2,339).
Estabilidade de vídeo: a taxa de deformação do sujeito é de apenas 23,1%, e a taxa de deformação do fundo é de apenas 9,4%;a taxa de perda de quadros é de apenas 0,8%, a melhor entre todos os modelos comparados.
Coordenação audiovisual: a taxa de problemas de sincronização entre rosto e corpo caiu para 5,1%, e a taxa de problemas de sincronização labial caiu para 29,8%, ambas superando os sistemas comerciais tradicionais.
A equipe do modelo de grande escala Meituan LongCat afirma que tornar o LongCat-Video-Avatar 1.5 de código aberto é mais do que uma atualização de versão — é um convite à comunidade global de desenvolvedores e criadores. Eles esperam que esse modelo sirva como uma base técnica verificável e aprimorável, ajudando a ampliar os limites reais das aplicações de vídeo com humanos digitais.
Links de código aberto:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Relatório técnico: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Página do projeto: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary








 Como corrigir as Core Web Vitals para melhorar o ranqueamento de SEO
Simplifique os Comentários do Boletim Escolar com Ferramentas de IAIntroduçãoFerramentas de IA para Gerar Comentários do Boletim EscolarMagic SchoolAlmanac AIChat GPTUsando o Magic School para Gerar Comentários do Boletim EscolarFazendo login n
 O Slackbot torna-se um Agente de IA
O Slackbot, o assistente automatizado integrado à plataforma de mensagens corporativas Slack da Salesforce, está se transformando em um agente de IA. O CTO da Salesforce, Parker Harris, prevê que ele alcance um status viral comparável ao do ChatGPT d
 A ByteDance Aumenta os Incentivos de IA Principal com o Doubao Aumentando 14,6%
A ByteDance convocou recentemente uma reunião de divulgação sobre a participação acionária do DouBao para revelar novas políticas de incentivos para os funcionários envolvidos na divisão do DouBao. O preço de exercício das ações do DouBao foi elevado

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Retoque com IA do Photoshop para roupas de comércio eletrônico, limpeza de pele e consistência de cores! Esta lista curada de alta classificação apresenta soluções poderosas que mudam o jogo, ajudando você a aumentar a eficiência da escrita, simplificar a criação de conteúdo e obter resultados visuais perfeitos sem esforço. Cada ferramenta passou por testes do mundo real através de classificações atualizadas semanalmente, com detalhes completos sobre comparação entre gratuito e pago. Com o apoio da XIX.AI, é o guia essencial para quem deseja desbloquear sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas bibliotecas de prompts de IA de 2026 para otimizar todos os tipos de fluxos de trabalho do ChatGPT. A XIX.AI selecionou uma coleção poderosa e revolucionária, submetida a rigorosos testes no mundo real para garantir o máximo desempenho. Você encontra comparações detalhadas entre opções gratuitas e pagas, além de classificações de especialistas, para ajudá-lo a escolher as ferramentas indispensáveis que aumentam sua produtividade e potencializam suas vantagens em IA. Explore agora!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Construção de Questionários com IA para Professores, Tutores e Programas de Aprendizagem Baseados em Coortes! A XIX.AI compilou uma lista de ferramentas poderosas e transformadoras, testadas em cenários reais, para garantir classificações precisas. Essas plataformas imperdíveis ajudam a aumentar a eficiência na escrita, otimizar a criação de conteúdo e simplificar o design de questionários em todos os cenários de aprendizado. Explore agora para descobrir a ferramenta perfeita para desbloquear sua vantagem com IA no ensino!
13 ferramentas
xix.ai












