


 Дом
Meituan открыла исходный код LongCat-Video-Avatar 1.5, превосходящий по эффективности основные закрытые модели
Команда Meituan, занимающаяся разработкой крупномасштабной модели LongCat, официально открыла исходный код LongCat-Video-Avatar 1.5 — модели генерации видео с цифровыми персонажами коммерческого уровня. Эта версия знаменует собой полный переход от передовых технологий с открытым исходным кодом к реальному коммерческому внедрению и включает значительные усовершенствования в области синхронизации губ, физического реализма, стабильности при воспроизведении длинных видеороликов, взаимодействия нескольких персонажей и эффективности инференции.
Три ключевых усовершенствования для преодоления препятствий на пути к коммерциализации
Чтобы обеспечить надёжную работу цифровых людей в различных реальных приложениях, LongCat-Video-Avatar 1.5 решает такие хронические проблемы традиционных видео с цифровыми людьми, как дрожание, искажения и высокая задержка, посредством трёх комплексных улучшений:
Улучшение кодирования аудио коммерческого уровня
Кодер извлечения аудиоособенностей модели был обновлен с Wav2Vec2 до Whisper-large. Благодаря большему количеству параметров и более обширным многоязычным априорным знаниям он теперь улавливает тонкие вариации фонем и ритм речи. Это улучшает синхронизацию губ при обработке сложного аудио, такого как длинные предложения, быстрая речь и пение, а также обеспечивает естественную координацию между мимикой, движениями головы и речью — что значительно сокращает пропуск кадров и смещение идентичности в более длинных видеороликах.
Надежная генерализация в открытом домене за счет многоэтапного обогащения данных
Чтобы обеспечить стабильную производительность при работе с разнообразными объектами — реальными людьми, виртуальными идолами, персонажами аниме и животными — команда разработала многоэтапный конвейер обработки данных, включающий офлайн-аннотирование и онлайн-валидацию, а также внедрила три целевых типа расширенных данных:
Данные с участием нескольких человек: с помощью активного обнаружения говорящего устраняется аудиовизуальная неоднозначность в сценах с участием нескольких человек, что позволяет точно различать говорящих и слушающих.
Данные с тишиной: благодаря отбору видеороликов без речи модель обучается распознавать естественные микровыражения лица в моменты молчания, что позволяет предотвратить нежелательные движения рта у персонажей, не произносящих речи.
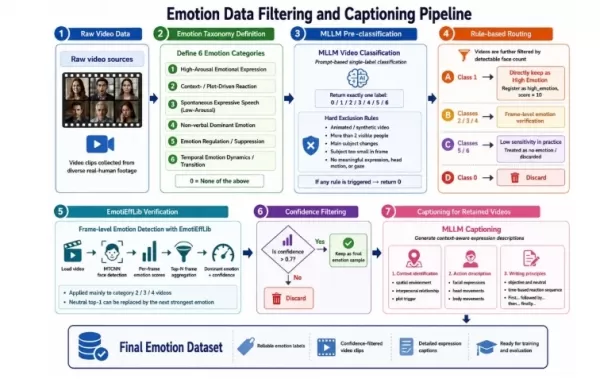
Данные об эмоциях: в сочетании с фильтрацией распознавания эмоций на уровне отдельных кадров они учитывают эмоциональные вариации, помогая модели уловить глубокую связь между речью и мимикой.
Выравнивание рук и временная непрерывность с помощью GRPO
Для таких сценариев использования, как прямые трансляции в электронной коммерции и демонстрации продуктов, где часто видны руки, модель использует GRPO (Human Preference Alignment), который уточняет сигналы вознаграждения до уровня отдельного кадра и добавляет механизм обнаружения рук в первом кадре. Это существенно уменьшает такие распространенные проблемы, как искажение рук, локальный структурный коллапс и несогласованность движений.
В 15 раз более быстрая инференция: устранение высоких вычислительных затрат
Стоимость — ещё один критически важный фактор для коммерческого внедрения. LongCat-Video-Avatar 1.5 использует технологию DMD (Distributed Matching Distillation), сокращая исходный 50-этапный процесс генерации до всего 8 этапов. Кроме того, команда заменила традиционную параллельную конфигурацию из трёх моделей на одну общую базовую модель с несколькими адаптерами LoRA, что позволило резко сократить использование VRAM.
В реальных тестах модель обеспечивает примерно в 15 раз более быструю инференцию, генерируя 10-секундное видео примерно за одну минуту.
Оценка по бенчмарку: превосходство над ведущими отраслевыми моделями
С использованием тестового набора EvalTalker 770 оценщиков и 10 экспертов в различных областях провели структурированный анализ качества видеороликов из сложных тематических областей, включая новости, образование и развлечения. Результаты показывают, что LongCat-Video-Avatar 1.5 демонстрирует превосходные показатели по нескольким ключевым метрикам:
Показатель предпочтений пользователей: он превосходит Kling Avatar 2.0 на 65,9 %, OmniHuman-1.5 — на 61,1 % и HeyGen — на 54,3 %.
Оценки в сценариях с одним и несколькими участниками: оценка в сценарии с одним участником достигает 3,336, что значительно превышает показатели таких конкурентов, как HeyGen; оценка в сценарии с несколькими участниками составляет 2,730, что значительно превосходит показатель InfiniteTalk (2,339).
Стабильность видео: частота деформации объекта составляет всего 23,1%, а деформации фона — всего 9,4%;частота пропуска кадров составляет всего 0,8%, что является лучшим показателем среди всех сравниваемых моделей.
Аудиовизуальная координация: частота проблем с синхронизацией лица и тела снизилась до 5,1%, а частота проблем с синхронизацией губ — до 29,8%; оба показателя превосходят традиционные коммерческие системы.
Команда разработчиков крупной модели Meituan LongCat заявляет, что открытие исходного кода LongCat-Video-Avatar 1.5 — это не просто обновление версии, а приглашение к сотрудничеству для глобального сообщества разработчиков и творцов. Они надеются, что эта модель станет проверяемой и поддающейся совершенствованию технической основой, которая поможет расширить реальные границы применения технологий цифровых человеческих видеоаватаров.
Ссылки на открытый исходный код:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Технический отчет: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Страница проекта: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
Связанная статья
 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ
Рекомендации по связанным специальным темам
письмо
 Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
 8 инструментов
 xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

 Комментарии (0)
Команда Meituan, занимающаяся разработкой крупномасштабной модели LongCat, официально открыла исходный код LongCat-Video-Avatar 1.5 — модели генерации видео с цифровыми персонажами коммерческого уровня. Эта версия знаменует собой полный переход от передовых технологий с открытым исходным кодом к реальному коммерческому внедрению и включает значительные усовершенствования в области синхронизации губ, физического реализма, стабильности при воспроизведении длинных видеороликов, взаимодействия нескольких персонажей и эффективности инференции.
Три ключевых усовершенствования для преодоления препятствий на пути к коммерциализации
Чтобы обеспечить надёжную работу цифровых людей в различных реальных приложениях, LongCat-Video-Avatar 1.5 решает такие хронические проблемы традиционных видео с цифровыми людьми, как дрожание, искажения и высокая задержка, посредством трёх комплексных улучшений:
Улучшение кодирования аудио коммерческого уровня
Кодер извлечения аудиоособенностей модели был обновлен с Wav2Vec2 до Whisper-large. Благодаря большему количеству параметров и более обширным многоязычным априорным знаниям он теперь улавливает тонкие вариации фонем и ритм речи. Это улучшает синхронизацию губ при обработке сложного аудио, такого как длинные предложения, быстрая речь и пение, а также обеспечивает естественную координацию между мимикой, движениями головы и речью — что значительно сокращает пропуск кадров и смещение идентичности в более длинных видеороликах.
Надежная генерализация в открытом домене за счет многоэтапного обогащения данных
Чтобы обеспечить стабильную производительность при работе с разнообразными объектами — реальными людьми, виртуальными идолами, персонажами аниме и животными — команда разработала многоэтапный конвейер обработки данных, включающий офлайн-аннотирование и онлайн-валидацию, а также внедрила три целевых типа расширенных данных:
Данные с участием нескольких человек: с помощью активного обнаружения говорящего устраняется аудиовизуальная неоднозначность в сценах с участием нескольких человек, что позволяет точно различать говорящих и слушающих.
Данные с тишиной: благодаря отбору видеороликов без речи модель обучается распознавать естественные микровыражения лица в моменты молчания, что позволяет предотвратить нежелательные движения рта у персонажей, не произносящих речи.
Данные об эмоциях: в сочетании с фильтрацией распознавания эмоций на уровне отдельных кадров они учитывают эмоциональные вариации, помогая модели уловить глубокую связь между речью и мимикой.
Выравнивание рук и временная непрерывность с помощью GRPO
Для таких сценариев использования, как прямые трансляции в электронной коммерции и демонстрации продуктов, где часто видны руки, модель использует GRPO (Human Preference Alignment), который уточняет сигналы вознаграждения до уровня отдельного кадра и добавляет механизм обнаружения рук в первом кадре. Это существенно уменьшает такие распространенные проблемы, как искажение рук, локальный структурный коллапс и несогласованность движений.
В 15 раз более быстрая инференция: устранение высоких вычислительных затрат
Стоимость — ещё один критически важный фактор для коммерческого внедрения. LongCat-Video-Avatar 1.5 использует технологию DMD (Distributed Matching Distillation), сокращая исходный 50-этапный процесс генерации до всего 8 этапов. Кроме того, команда заменила традиционную параллельную конфигурацию из трёх моделей на одну общую базовую модель с несколькими адаптерами LoRA, что позволило резко сократить использование VRAM.
В реальных тестах модель обеспечивает примерно в 15 раз более быструю инференцию, генерируя 10-секундное видео примерно за одну минуту.
Оценка по бенчмарку: превосходство над ведущими отраслевыми моделями
С использованием тестового набора EvalTalker 770 оценщиков и 10 экспертов в различных областях провели структурированный анализ качества видеороликов из сложных тематических областей, включая новости, образование и развлечения. Результаты показывают, что LongCat-Video-Avatar 1.5 демонстрирует превосходные показатели по нескольким ключевым метрикам:
Показатель предпочтений пользователей: он превосходит Kling Avatar 2.0 на 65,9 %, OmniHuman-1.5 — на 61,1 % и HeyGen — на 54,3 %.
Оценки в сценариях с одним и несколькими участниками: оценка в сценарии с одним участником достигает 3,336, что значительно превышает показатели таких конкурентов, как HeyGen; оценка в сценарии с несколькими участниками составляет 2,730, что значительно превосходит показатель InfiniteTalk (2,339).
Стабильность видео: частота деформации объекта составляет всего 23,1%, а деформации фона — всего 9,4%;частота пропуска кадров составляет всего 0,8%, что является лучшим показателем среди всех сравниваемых моделей.
Аудиовизуальная координация: частота проблем с синхронизацией лица и тела снизилась до 5,1%, а частота проблем с синхронизацией губ — до 29,8%; оба показателя превосходят традиционные коммерческие системы.
Команда разработчиков крупной модели Meituan LongCat заявляет, что открытие исходного кода LongCat-Video-Avatar 1.5 — это не просто обновление версии, а приглашение к сотрудничеству для глобального сообщества разработчиков и творцов. Они надеются, что эта модель станет проверяемой и поддающейся совершенствованию технической основой, которая поможет расширить реальные границы применения технологий цифровых человеческих видеоаватаров.
Ссылки на открытый исходный код:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Технический отчет: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Страница проекта: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary








 Акции США достигли исторической отметки, поскольку гиганты искусственного интеллекта и аэрокосмической отрасли готовятся к дебюту с оценкой в триллион долларов
Илон Маск, Сэм Алтман и Дарио Амодэй, три титана технологического сектора, продвигаются к первичным публичным предложениям акций своих respective компаний. Благодаря SpaceX, OpenAI и Anthropic — трем отраслевым гигантам, чья оценка приближается к три
 Шведский стартап в области искусственного интеллекта Lovable Eyes достиг оценки в 13,2 миллиарда долларов после крупного раунда финансирования
По мере того как инструменты для программирования на основе искусственного интеллекта набирают популярность, шведский стартап Lovable привлек крупный раунд финансирования. Компания нацелена на привлечение $3 млрд, что потенциально может увеличить её
Google тестирует агента Remy AI для Gemini по мере смещения фокуса на управление пользователями
Согласно Business Insider, Google тестирует Remy, нового ИИ-персонального агента для Gemini. Этот инструмент предназначен для выполнения задач от имени пользователей, упрощая как профессиональные рабочие процессы, так и повседневные рутины.В настоящ

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai












