


 Lar
A Liquid AI disponibiliza em código aberto o modelo híbrido especializado LFM2.5 para IA de ponta
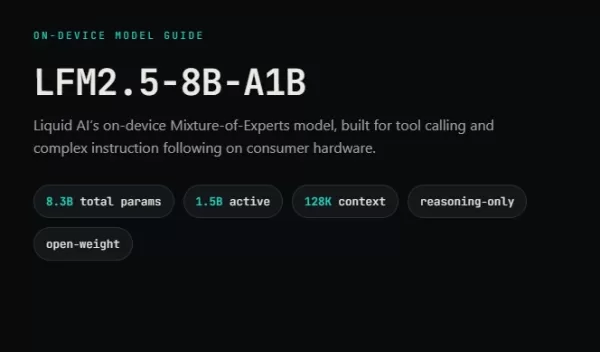
A startup de IA Liquid AI lançou hoje oficialmente e disponibilizou em código aberto seu mais recente modelo de grande porte para a borda, o LFM2.5-8B-A1B . Projetado para a execução de ferramentas e o cumprimento de instruções complexas em hardware de consumo, o modelo melhora o desempenho de raciocínio e inferência em dispositivos de borda, mantendo os custos computacionais extremamente baixos.
Em termos de arquitetura, ele utiliza um design esparso de mistura de especialistas (MoE) com um total de 8,3 bilhões de parâmetros. Graças a essa esparsidade, ele ativa apenas 1,5 bilhão de parâmetros por token, permitindo uma operação local fluida em smartphones, laptops e dispositivos similares.
Contexto ampliado e raciocínio mais robusto
Em comparação com seu antecessor, o LFM2.5 amplia a janela de contexto de 32 mil para 128 mil tokens e aumenta os dados de pré-treinamento de 12 T para 38 T de tokens. Como um modelo de inferência puro, ele produz uma cadeia de raciocínio explícita antes de fornecer a resposta final. Seu vocabulário altamente compactado lida com eficiência com nove idiomas, incluindo chinês e árabe.
Para reduzir loops lógicos sem saída e alucinações durante o raciocínio prolongado, a equipe de desenvolvimento aplicou aprendizado por reforço (RL) em duas etapas durante o treinamento. A otimização de preferências reduz efetivamente os “loops sem saída” no raciocínio de cadeia longa, enquanto um mecanismo especializado de recompensa anti-alucinação permite que o modelo se recuse ativamente a responder a perguntas fora de sua base de conhecimento.
Desempenho de ponta poderoso e amplo suporte ao ecossistema
Em termos de desempenho, o LFM2.5 apresentou ganhos explosivos. Suas pontuações em benchmarks de raciocínio lógico e anti-alucinação superam em muito as de seu antecessor, e ele chega a competir com modelos maiores no cumprimento de instruções. Para a chamada de ferramentas, o modelo tem como padrão a geração de chamadas de função Python eficientes e oferece suporte à transição perfeita para o formato JSON por meio de prompts do sistema.
O modelo recebeu suporte total das principais estruturas de inferência no dia do lançamento, incluindo llama.cpp, MLX, vLLM e SGLang. Em testes de hardware, ele atingiu velocidades de decodificação de até 253 bytes por segundo no chip M5 Max e cerca de 30 bytes por segundo em dispositivos móveis, equilibrando perfeitamente privacidade e eficiência para implantações de ponta.
Artigo relacionado
 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava
Recomendações de tópicos especiais relacionados
SEO
 As melhores ferramentas de análise de SERP com IA para estratégias de busca
As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
 13 ferramentas
 xix.ai
Análise de dados
Melhores ferramentas de detecção de anomalias com IA para monitoramento de KPIs entre equipes de SaaS e comércio eletrônico
2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai
escrita
Os melhores geradores de esboços com IA para artigos longos de SEO
Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de IA para os deveres de casa e a preparação para provas
As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai
Composição musical
Ferramentas de Demonstração Vocal com IA para Compositores, Ganchos, Toplines e Sessões de Rascunho Multilíngues
2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai
Negócios
As melhores ferramentas de pesquisa competitiva baseadas em IA para pequenas empresas
As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

 Comentários (1)
![AlbertWilson]()
Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏
A startup de IA Liquid AI lançou hoje oficialmente e disponibilizou em código aberto seu mais recente modelo de grande porte para a borda,
Em termos de arquitetura, ele utiliza um design esparso de mistura de especialistas (MoE) com um total de 8,3 bilhões de parâmetros. Graças a essa esparsidade, ele ativa apenas 1,5 bilhão de parâmetros por token, permitindo uma operação local fluida em smartphones, laptops e dispositivos similares.
Contexto ampliado e raciocínio mais robusto
Em comparação com seu antecessor, o LFM2.5 amplia a janela de contexto de 32 mil para 128 mil tokens e aumenta os dados de pré-treinamento de 12 T para 38 T de tokens. Como um modelo de inferência puro, ele produz uma cadeia de raciocínio explícita antes de fornecer a resposta final. Seu vocabulário altamente compactado lida com eficiência com nove idiomas, incluindo chinês e árabe.
Para reduzir loops lógicos sem saída e alucinações durante o raciocínio prolongado, a equipe de desenvolvimento aplicou aprendizado por reforço (RL) em duas etapas durante o treinamento. A otimização de preferências reduz efetivamente os “loops sem saída” no raciocínio de cadeia longa, enquanto um mecanismo especializado de recompensa anti-alucinação permite que o modelo se recuse ativamente a responder a perguntas fora de sua base de conhecimento.
Desempenho de ponta poderoso e amplo suporte ao ecossistema
Em termos de desempenho, o LFM2.5 apresentou ganhos explosivos. Suas pontuações em benchmarks de raciocínio lógico e anti-alucinação superam em muito as de seu antecessor, e ele chega a competir com modelos maiores no cumprimento de instruções. Para a chamada de ferramentas, o modelo tem como padrão a geração de chamadas de função Python eficientes e oferece suporte à transição perfeita para o formato JSON por meio de prompts do sistema.
O modelo recebeu suporte total das principais estruturas de inferência no dia do lançamento, incluindo llama.cpp, MLX, vLLM e SGLang. Em testes de hardware, ele atingiu velocidades de decodificação de até 253 bytes por segundo no chip M5 Max e cerca de 30 bytes por segundo em dispositivos móveis, equilibrando perfeitamente privacidade e eficiência para implantações de ponta.








 Suno para Marcas d'Água em Músicas Durante Batalhas Legais
O Suno, plataforma que permite aos usuários gerar músicas criadas por inteligência artificial, apresentou novas funcionalidades para rotular as faixas produzidas pela plataforma, restringir downloads e atualizar os padrões da comunidade para coibir r
 Musk admite que vazamento do código do Grok expôs dados de usuários e promete apagar todas as informações históricas.
Elon Musk abordou diretamente a controvérsia sobre privacidade envolvendo o Grok Build, começando com um simples "Verdadeiro" para confirmar a validade do incidente. Ele prometeu que todos os dados dos usuários carregados anteriormente para a SpaceXA
 Ações dos EUA Atingem Marco Histórico Enquanto Gigantes de IA e Aeroespacial se Preparam para Estreia de Trilião de Dólares
Elon Musk, Sam Altman e Dario Amodei, três titãs do setor de tecnologia, estão avançando rumo a ofertas públicas iniciais (IPOs) para suas respectivas empresas. Com a SpaceX, a OpenAI e a Anthropic — três gigantes da indústria que se aproximam de ava

As melhores e mais bem avaliadas ferramentas de análise de SERP com IA de 2026 para estratégias de busca são selecionadas pela XIX.AI por meio de rigorosos testes práticos e rankings atualizados semanalmente. Essas ferramentas poderosas ajudam você a identificar oportunidades ocultas de otimização, melhorar o desempenho do conteúdo e obter uma vantagem competitiva nas buscas. Descubra hoje mesmo a ferramenta perfeita para aprimorar sua estratégia de busca. Explore agora!
13 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Detecção de Anomalias por IA Mais Bem Avaliadas para Monitoramento de KPIs em Equipes de SaaS e E-commerce! A XIX.AI compilou uma coleção poderosa e transformadora, baseada em testes rigorosos do mundo real e classificações atualizadas semanalmente. Você encontrará insights detalhados sobre comparações entre versões gratuitas e pagas para ajudá-lo a identificar a solução que deve ser testada, aumentando a produtividade e desbloqueando sua vantagem com IA. Explore agora!
10 ferramentas
xix.ai

Os melhores e mais bem avaliados geradores de esboços com IA de 2026 para artigos longos de SEO, cuidadosamente selecionados pela XIX.AI. Essas ferramentas poderosas oferecem um auxílio revolucionário na criação rápida de conteúdo de alta qualidade, aumentando significativamente a eficiência na redação. Confira uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para ajudá-lo a encontrar a opção imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

As melhores e mais recentes ferramentas de IA para lição de casa e preparação para provas em 2026! A XIX.AI seleciona uma lista das ferramentas mais bem avaliadas, poderosas e revolucionárias que ajudam os alunos a aumentar a produtividade, agilizar a realização das lições de casa e se sair muito bem nas provas por meio de testes práticos. Veja uma comparação entre versões gratuitas e pagas, classificações detalhadas e opções imperdíveis para aproveitar ao máximo as vantagens da IA. Explore agora!
10 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Demonstração Vocal com IA para Compositores, Criadores de Ganchos e Equipes de Conteúdo Multilíngue! A XIX.AI compilou uma lista de ferramentas altamente avaliadas e poderosas, que mudam o jogo e passaram por rigorosos testes no mundo real. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e opções imperdíveis para ajudá-lo a aumentar a eficiência da escrita e desbloquear seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para todas as suas necessidades de conteúdo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de pesquisa competitiva com IA de 2026 para pequenas empresas! A XIX.AI selecionou uma coleção extremamente poderosa e revolucionária, atualizada semanalmente com testes rigorosos no mundo real e classificações detalhadas. Você encontrará uma comparação abrangente entre versões gratuitas e pagas para ajudá-lo a identificar as ferramentas imperdíveis que aumentam sua produtividade e lhe proporcionam uma vantagem competitiva. Explore agora para descobrir a ferramenta perfeita para você!
9 ferramentas
xix.ai

Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏












