


 Maison
Liquid AI met en open source son modèle expert hybride LFM2.5 destiné à l'IA en périphérie
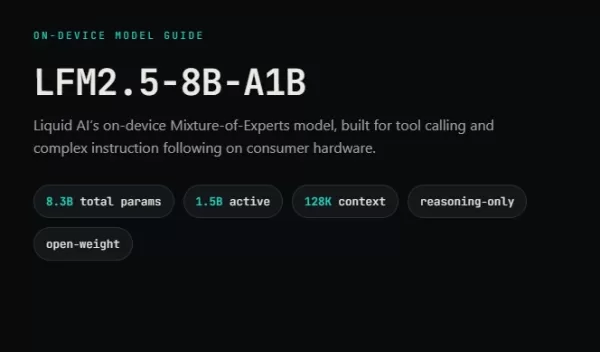
La start-up spécialisée dans l'IA Liquid AI a officiellement lancé et mis en open source aujourd'hui son dernier modèle de grande envergure destiné à la périphérie, le LFM2.5-8B-A1B . Conçu pour l'appel d'outils et l'exécution d'instructions complexes sur du matériel grand public, ce modèle améliore les performances de raisonnement et d'inférence sur les appareils périphériques tout en maintenant des coûts de calcul extrêmement bas.
Sur le plan architectural, il utilise une conception de type « mixture-of-experts » (MoE) clairsemée, avec un total de 8,3 milliards de paramètres. Grâce à cette clairsemée, il n'active que 1,5 milliard de paramètres par token, ce qui permet un fonctionnement local fluide sur les smartphones, les ordinateurs portables et les appareils similaires.
Contexte étendu et raisonnement plus solide
Par rapport à son prédécesseur, LFM2.5 étend la fenêtre de contexte de 32 000 à 128 000 tokens et augmente le volume de données de pré-entraînement de 12 T à 38 T de tokens. En tant que modèle d'inférence pur, il produit une chaîne de raisonnement explicite avant de fournir la réponse finale. Son vocabulaire hautement compressé prend efficacement en charge neuf langues, dont le chinois et l'arabe.
Afin de réduire les boucles logiques sans issue et les hallucinations lors de raisonnements longs, l'équipe de développement a appliqué un apprentissage par renforcement (RL) en deux étapes pendant l'entraînement. L'optimisation des préférences réduit efficacement les « boucles sans issue » dans les raisonnements à longue chaîne, tandis qu'un mécanisme de récompense anti-hallucination spécialisé permet au modèle de refuser activement de répondre à des questions hors de sa base de connaissances.
Performances de pointe en périphérie et prise en charge d'un vaste écosystème
En termes de performances, LFM2.5 a enregistré des gains spectaculaires. Ses scores aux benchmarks de raisonnement logique et d’anti-hallucination surpassent de loin ceux de son prédécesseur, et il rivalise même avec des modèles plus volumineux en matière de suivi d’instructions. Pour l’appel d’outils, le modèle génère par défaut des appels de fonctions Python efficaces et prend en charge le passage transparent au format JSON via des invites système.
Le modèle a bénéficié d'une prise en charge complète par les principaux frameworks d'inférence dès son lancement, notamment llama.cpp, MLX, vLLM et SGLang. Lors des tests matériels, il a atteint des vitesses de décodage allant jusqu'à 253 octets par seconde sur la puce M5 Max et environ 30 octets par seconde sur les appareils mobiles, offrant un équilibre parfait entre confidentialité et efficacité pour les déploiements en périphérie.
Article connexe
 Suno appose des filigranes aux chansons dans le cadre de batailles juridiques
Suno, la plateforme permettant aux utilisateurs de générer de la musique créée par l’intelligence artificielle, a dévoilé de nouvelles fonctionnalités pour étiqueter les titres produits sur la plateforme, restreindre les téléchargements et mettre à j
Musk admet que la construction de Grok a divulgué le code utilisateur, promet d’effacer toutes les données historiques
Elon Musk a abordé directement la controverse sur la vie privée concernant Grok Build, en commençant par un simple « Vrai » pour confirmer la validité de l’incident. Il s’est engagé à ce que toutes les données utilisateur précédemment téléchargées su
Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
Recommandations de sujets spéciaux liés
Référencement
 Les meilleurs outils d'analyse des SERP basés sur l'IA pour la stratégie de référencement
Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
 13 outils
 xix.ai
Analyse des données
Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

 commentaires (1)
![AlbertWilson]()
Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏
La start-up spécialisée dans l'IA Liquid AI a officiellement lancé et mis en open source aujourd'hui son dernier modèle de grande envergure destiné à la périphérie,
Sur le plan architectural, il utilise une conception de type « mixture-of-experts » (MoE) clairsemée, avec un total de 8,3 milliards de paramètres. Grâce à cette clairsemée, il n'active que 1,5 milliard de paramètres par token, ce qui permet un fonctionnement local fluide sur les smartphones, les ordinateurs portables et les appareils similaires.
Contexte étendu et raisonnement plus solide
Par rapport à son prédécesseur, LFM2.5 étend la fenêtre de contexte de 32 000 à 128 000 tokens et augmente le volume de données de pré-entraînement de 12 T à 38 T de tokens. En tant que modèle d'inférence pur, il produit une chaîne de raisonnement explicite avant de fournir la réponse finale. Son vocabulaire hautement compressé prend efficacement en charge neuf langues, dont le chinois et l'arabe.
Afin de réduire les boucles logiques sans issue et les hallucinations lors de raisonnements longs, l'équipe de développement a appliqué un apprentissage par renforcement (RL) en deux étapes pendant l'entraînement. L'optimisation des préférences réduit efficacement les « boucles sans issue » dans les raisonnements à longue chaîne, tandis qu'un mécanisme de récompense anti-hallucination spécialisé permet au modèle de refuser activement de répondre à des questions hors de sa base de connaissances.
Performances de pointe en périphérie et prise en charge d'un vaste écosystème
En termes de performances, LFM2.5 a enregistré des gains spectaculaires. Ses scores aux benchmarks de raisonnement logique et d’anti-hallucination surpassent de loin ceux de son prédécesseur, et il rivalise même avec des modèles plus volumineux en matière de suivi d’instructions. Pour l’appel d’outils, le modèle génère par défaut des appels de fonctions Python efficaces et prend en charge le passage transparent au format JSON via des invites système.
Le modèle a bénéficié d'une prise en charge complète par les principaux frameworks d'inférence dès son lancement, notamment llama.cpp, MLX, vLLM et SGLang. Lors des tests matériels, il a atteint des vitesses de décodage allant jusqu'à 253 octets par seconde sur la puce M5 Max et environ 30 octets par seconde sur les appareils mobiles, offrant un équilibre parfait entre confidentialité et efficacité pour les déploiements en périphérie.








 Suno appose des filigranes aux chansons dans le cadre de batailles juridiques
Suno, la plateforme permettant aux utilisateurs de générer de la musique créée par l’intelligence artificielle, a dévoilé de nouvelles fonctionnalités pour étiqueter les titres produits sur la plateforme, restreindre les téléchargements et mettre à j
 Musk admet que la construction de Grok a divulgué le code utilisateur, promet d’effacer toutes les données historiques
Elon Musk a abordé directement la controverse sur la vie privée concernant Grok Build, en commençant par un simple « Vrai » pour confirmer la validité de l’incident. Il s’est engagé à ce que toutes les données utilisateur précédemment téléchargées su
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent

Les meilleurs outils d’analyse SERP basés sur l’IA de 2026, les mieux notés pour la stratégie de référencement, sont sélectionnés par XIX.AI à l’issue de tests rigoureux en conditions réelles et de classements mis à jour chaque semaine. Ces outils puissants vous aident à révéler des opportunités d’optimisation cachées, à améliorer les performances de votre contenu et à acquérir un avantage concurrentiel dans les résultats de recherche. Découvrez dès aujourd’hui l’outil idéal pour optimiser votre stratégie de référencement. Explorez-les dès maintenant !
13 outils
xix.ai

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏












