


 Дом
Компания Liquid AI открыла исходный код гибридной экспертной модели LFM2.5 для периферийного искусственного интеллекта
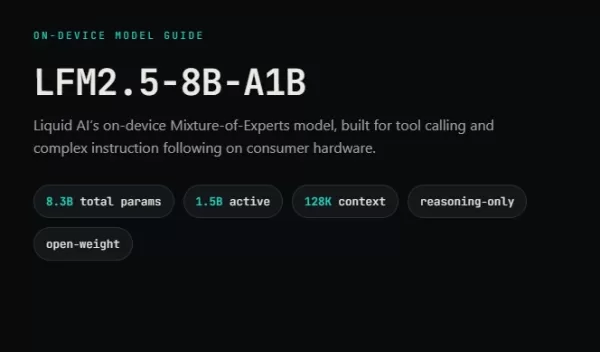
Стартап Liquid AI сегодня официально представил и открыл исходный код своей новейшей крупномасштабной модели для периферийных устройств — LFM2.5-8B-A1B . Разработанная для вызова инструментов и выполнения сложных инструкций на потребительском оборудовании, эта модель повышает производительность логических выводов и инференции на периферийных устройствах, сохраняя при этом чрезвычайно низкие вычислительные затраты.
С архитектурной точки зрения в ней используется разреженная конструкция «смесь экспертов» (MoE) с общим количеством параметров 8,3 миллиарда. Благодаря этой разреженности активируется только 1,5 миллиарда параметров на токен, что обеспечивает плавную локальную работу на смартфонах, ноутбуках и аналогичных устройствах.
Расширенный контекст и более мощное рассуждение
По сравнению со своей предшественницей, LFM2.5 расширяет окно контекста с 32K до 128K токенов и увеличивает объем данных предварительного обучения с 12T до 38T токенов. Как чистая модель вывода, она формирует явную цепочку рассуждений перед предоставлением окончательного ответа. Ее высокосжатый словарь эффективно обрабатывает девять языков, включая китайский и арабский.
Чтобы уменьшить количество логических тупиковых циклов и галлюцинаций при длительном рассуждении, команда разработчиков применила двухэтапное обучение с подкреплением (RL) во время обучения. Оптимизация предпочтений эффективно сокращает количество «тупиковых циклов» в рассуждениях с длинной цепочкой, а специализированный механизм вознаграждения против галлюцинаций позволяет модели активно отказываться отвечать на вопросы, выходящие за пределы ее базы знаний.
Высокая производительность на периферии и широкая поддержка экосистемы
По производительности LFM2.5 продемонстрировала взрывной рост. Ее результаты в тестах на логическое рассуждение и защиту от галлюцинаций значительно превосходят показатели предшественницы, и она даже конкурирует с более крупными моделями в выполнении инструкций. При вызове инструментов модель по умолчанию выдает эффективные вызовы функций Python и поддерживает плавное переключение в формат JSON через системные подсказки.
В день запуска модель получила полную поддержку со стороны основных фреймворков для инференции, включая llama.cpp, MLX, vLLM и SGLang. В ходе аппаратных тестов скорость декодирования достигала 253 байт в секунду на чипе M5 Max и около 30 байт в секунду на мобильных устройствах, что обеспечивает идеальный баланс между конфиденциальностью и эффективностью для пограничных развертываний.
Связанная статья
 OpenAI заманивает уоллстритовских банкиров огромными выплатами и долями в компании, чтобы переформатировать финансовую отрасль
OpenAI активно расширяет свое присутствие в сфере инвестиционного банкинга: недавние вакансии показывают, что компания ищет инвестиционных специалистов с опытом работы более двух лет для присоединения к своей команде прикладного искусственного интелл
Пять министерств и ведомств запускают план «Искусственный интеллект в образовании» по разработке курсов MOOC с использованием ИИ на всех этапах академического обучения
10 апреля Министерство образования, Государственный комитет по развитию и реформам, Министерство промышленности и информатизации, Министерство науки и технологий и Национальное управление по данным совместно опубликовали «План действий по внедрению т
ByteDance’s Seed запускает глобальную кампанию по набору сотрудников в кампусах, предлагая виртуальные акции для привлечения лучших специалистов по крупным языковым моделям
В условиях конкурентной борьбы крупных языковых моделей привлечение высококвалифицированных специалистов остается самым важным стратегическим активом.1 апреля ByteDance объявил о запуске глобальной программы набора на кампусы Seed, являющейся частью
Рекомендации по связанным специальным темам
Преобразование текста в речь
 Инструменты для клонирования голоса на основе ИИ для подкастов: длинные выпуски, рекламные ролики ведущих и аудиокурсы
Здесь представлены лучшие и самые популярные инструменты для клонирования голоса с помощью ИИ в 2026 году, предназначенные для длинных эпизодов подкастов, рекламных роликов и аудиокурсов. Эти мощные, революционные решения проходят реальные испытания, чтобы гарантировать их надежность. Здесь вы найдёте сравнение бесплатных и платных версий, а также подробные рейтинги. XIX.AI предлагает подборку инструментов, которые обязательно стоит попробовать и которые значительно повысят вашу продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть свой потенциал в сфере ИИ.
 9 инструментов
 xix.ai
Дизайн и искусство
Инструменты искусственного интеллекта для создания визуальных стилей, предназначенные для создания характеристик персонажей, мудбордов и презентаций
2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
11 инструментов
xix.ai
SEO
Лучшие инструменты для анализа результатов поиска с помощью ИИ при разработке поисковой стратегии
XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai
Анализ данных
Лучшие инструменты ИИ для обнаружения аномалий при мониторинге KPI в командах SaaS и электронной коммерции
2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai
письмо
Лучшие генераторы конспектов на базе ИИ для длинных статей, оптимизированных для SEO
2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai
Образование и обучение
Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

 Комментарии (1)
![AlbertWilson]()
Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏
Стартап Liquid AI сегодня официально представил и открыл исходный код своей новейшей крупномасштабной модели для периферийных устройств —
С архитектурной точки зрения в ней используется разреженная конструкция «смесь экспертов» (MoE) с общим количеством параметров 8,3 миллиарда. Благодаря этой разреженности активируется только 1,5 миллиарда параметров на токен, что обеспечивает плавную локальную работу на смартфонах, ноутбуках и аналогичных устройствах.
Расширенный контекст и более мощное рассуждение
По сравнению со своей предшественницей, LFM2.5 расширяет окно контекста с 32K до 128K токенов и увеличивает объем данных предварительного обучения с 12T до 38T токенов. Как чистая модель вывода, она формирует явную цепочку рассуждений перед предоставлением окончательного ответа. Ее высокосжатый словарь эффективно обрабатывает девять языков, включая китайский и арабский.
Чтобы уменьшить количество логических тупиковых циклов и галлюцинаций при длительном рассуждении, команда разработчиков применила двухэтапное обучение с подкреплением (RL) во время обучения. Оптимизация предпочтений эффективно сокращает количество «тупиковых циклов» в рассуждениях с длинной цепочкой, а специализированный механизм вознаграждения против галлюцинаций позволяет модели активно отказываться отвечать на вопросы, выходящие за пределы ее базы знаний.
Высокая производительность на периферии и широкая поддержка экосистемы
По производительности LFM2.5 продемонстрировала взрывной рост. Ее результаты в тестах на логическое рассуждение и защиту от галлюцинаций значительно превосходят показатели предшественницы, и она даже конкурирует с более крупными моделями в выполнении инструкций. При вызове инструментов модель по умолчанию выдает эффективные вызовы функций Python и поддерживает плавное переключение в формат JSON через системные подсказки.
В день запуска модель получила полную поддержку со стороны основных фреймворков для инференции, включая llama.cpp, MLX, vLLM и SGLang. В ходе аппаратных тестов скорость декодирования достигала 253 байт в секунду на чипе M5 Max и около 30 байт в секунду на мобильных устройствах, что обеспечивает идеальный баланс между конфиденциальностью и эффективностью для пограничных развертываний.








 OpenAI заманивает уоллстритовских банкиров огромными выплатами и долями в компании, чтобы переформатировать финансовую отрасль
OpenAI активно расширяет свое присутствие в сфере инвестиционного банкинга: недавние вакансии показывают, что компания ищет инвестиционных специалистов с опытом работы более двух лет для присоединения к своей команде прикладного искусственного интелл
 Пять министерств и ведомств запускают план «Искусственный интеллект в образовании» по разработке курсов MOOC с использованием ИИ на всех этапах академического обучения
10 апреля Министерство образования, Государственный комитет по развитию и реформам, Министерство промышленности и информатизации, Министерство науки и технологий и Национальное управление по данным совместно опубликовали «План действий по внедрению т
 ByteDance’s Seed запускает глобальную кампанию по набору сотрудников в кампусах, предлагая виртуальные акции для привлечения лучших специалистов по крупным языковым моделям
В условиях конкурентной борьбы крупных языковых моделей привлечение высококвалифицированных специалистов остается самым важным стратегическим активом.1 апреля ByteDance объявил о запуске глобальной программы набора на кампусы Seed, являющейся частью
Здесь представлены лучшие и самые популярные инструменты для клонирования голоса с помощью ИИ в 2026 году, предназначенные для длинных эпизодов подкастов, рекламных роликов и аудиокурсов. Эти мощные, революционные решения проходят реальные испытания, чтобы гарантировать их надежность. Здесь вы найдёте сравнение бесплатных и платных версий, а также подробные рейтинги. XIX.AI предлагает подборку инструментов, которые обязательно стоит попробовать и которые значительно повысят вашу продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть свой потенциал в сфере ИИ.
9 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для создания визуальных стилей персонажей, мудбордов и презентаций — уже доступны на XIX.AI! В этом тщательно подобранном списке самых высокооцененных инструментов представлены мощные решения, способные кардинально изменить ваш подход к работе и прошедшие строгие тесты в реальных условиях. Здесь вы найдёте сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы повысить творческий потенциал и оптимизировать рабочий процесс. Ознакомьтесь с ним прямо сейчас, чтобы найти идеальный инструмент для повышения продуктивности!
11 инструментов
xix.ai

XIX.AI подготовила подборку лучших и наиболее высокооцененных инструментов для анализа результатов поиска с помощью ИИ (2026 г.) на основе тщательных тестов в реальных условиях и еженедельно обновляемого рейтинга. Эти мощные инструменты помогут вам раскрыть скрытые возможности оптимизации, повысить эффективность контента и получить конкурентное преимущество в поиске. Найдите свой идеальный инструмент, чтобы уже сегодня усовершенствовать свою поисковую стратегию. Ознакомьтесь с ними прямо сейчас!
13 инструментов
xix.ai

2026 г. Лучшие новейшие высокооцененные инструменты ИИ для обнаружения аномалий в мониторинге KPI для команд SaaS и электронной коммерции! XIX.AI подготовила мощную, меняющую правила игры коллекцию на основе строгих реальных тестов и еженедельно обновляемых рейтингов. Вы найдете подробные сравнительные данные по бесплатным и платным решениям, которые помогут вам определить обязательное к использованию решение, повышающее производительность и раскрывающее ваш потенциал в области ИИ. Исследуйте сейчас!
10 инструментов
xix.ai

2026 год: лучшие и самые высокооцененные генераторы конспектов на базе ИИ для длинных SEO-статей, тщательно отобранные XIX.AI. Эти мощные инструменты обеспечивают революционную помощь в быстром создании высококачественного контента, значительно повышая эффективность написания текстов. Ознакомьтесь со сравнением бесплатных и платных версий, а также с результатами реальных тестов и подробными рейтингами, которые помогут вам найти вариант, который обязательно стоит попробовать и который соответствует вашим потребностям. Изучите их прямо сейчас, чтобы раскрыть весь потенциал ИИ.
8 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏












