


 Hogar
Liquid AI publica en código abierto el modelo híbrido de expertos LFM2.5 para la IA en el borde
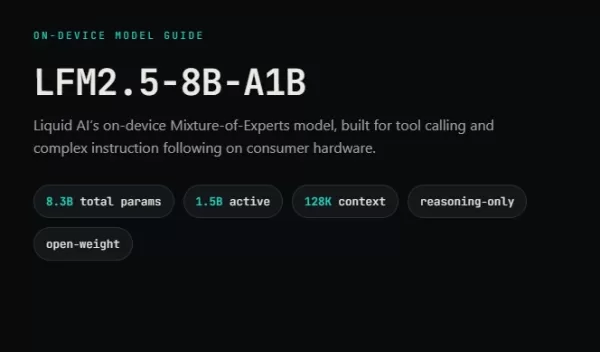
La startup de IA Liquid AI ha presentado hoy oficialmente y ha publicado en código abierto su último modelo de gran tamaño para el borde, el LFM2.5-8B-A1B . Diseñado para la ejecución de herramientas y el seguimiento de instrucciones complejas en hardware de consumo, el modelo mejora el rendimiento del razonamiento y la inferencia en dispositivos periféricos, al tiempo que mantiene los costes computacionales extremadamente bajos.
Desde el punto de vista arquitectónico, utiliza un diseño de mezcla de expertos (MoE) disperso con un total de 8.300 millones de parámetros. Gracias a esa dispersión, solo activa 1.500 millones de parámetros por token, lo que permite un funcionamiento local fluido en smartphones, ordenadores portátiles y dispositivos similares.
Contexto ampliado y razonamiento más sólido
En comparación con su predecesor, LFM2.5 amplía la ventana de contexto de 32 000 a 128 000 tokens y aumenta los datos de preentrenamiento de 12 T a 38 T de tokens. Como modelo de inferencia pura, genera una cadena de razonamiento explícita antes de ofrecer la respuesta final. Su vocabulario altamente comprimido maneja de manera eficiente nueve idiomas, incluidos el chino y el árabe.
Para reducir los bucles lógicos sin salida y las alucinaciones durante el razonamiento prolongado, el equipo de desarrollo aplicó el aprendizaje por refuerzo (RL) en dos etapas durante el entrenamiento. La optimización de preferencias reduce eficazmente los «bucles sin salida» en el razonamiento de cadena larga, mientras que un mecanismo de recompensa especializado contra las alucinaciones permite al modelo negarse activamente a responder preguntas fuera de su base de conocimientos.
Potente rendimiento en el borde y amplio soporte del ecosistema
En cuanto al rendimiento, LFM2.5 ha experimentado mejoras espectaculares. Sus puntuaciones en las pruebas de referencia de razonamiento lógico y anti-alucinaciones superan con creces a las de su predecesor, e incluso compite con modelos más grandes en el seguimiento de instrucciones. Para la llamada a herramientas, el modelo genera de forma predeterminada llamadas a funciones de Python eficientes y admite el cambio fluido al formato JSON a través de indicaciones del sistema.
El modelo recibió el soporte completo de los principales marcos de inferencia el día de su lanzamiento, incluidos llama.cpp, MLX, vLLM y SGLang. En las pruebas de hardware, alcanzó velocidades de decodificación de hasta 253 bytes por segundo en el chip M5 Max y de unos 30 bytes por segundo en dispositivos móviles, equilibrando a la perfección la privacidad y la eficiencia para implementaciones en el borde.
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
Análisis de datos
 Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
 10 herramientas
 xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

 comentario (1)
0/500
![AlbertWilson]()
Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏
La startup de IA Liquid AI ha presentado hoy oficialmente y ha publicado en código abierto su último modelo de gran tamaño para el borde,
Desde el punto de vista arquitectónico, utiliza un diseño de mezcla de expertos (MoE) disperso con un total de 8.300 millones de parámetros. Gracias a esa dispersión, solo activa 1.500 millones de parámetros por token, lo que permite un funcionamiento local fluido en smartphones, ordenadores portátiles y dispositivos similares.
Contexto ampliado y razonamiento más sólido
En comparación con su predecesor, LFM2.5 amplía la ventana de contexto de 32 000 a 128 000 tokens y aumenta los datos de preentrenamiento de 12 T a 38 T de tokens. Como modelo de inferencia pura, genera una cadena de razonamiento explícita antes de ofrecer la respuesta final. Su vocabulario altamente comprimido maneja de manera eficiente nueve idiomas, incluidos el chino y el árabe.
Para reducir los bucles lógicos sin salida y las alucinaciones durante el razonamiento prolongado, el equipo de desarrollo aplicó el aprendizaje por refuerzo (RL) en dos etapas durante el entrenamiento. La optimización de preferencias reduce eficazmente los «bucles sin salida» en el razonamiento de cadena larga, mientras que un mecanismo de recompensa especializado contra las alucinaciones permite al modelo negarse activamente a responder preguntas fuera de su base de conocimientos.
Potente rendimiento en el borde y amplio soporte del ecosistema
En cuanto al rendimiento, LFM2.5 ha experimentado mejoras espectaculares. Sus puntuaciones en las pruebas de referencia de razonamiento lógico y anti-alucinaciones superan con creces a las de su predecesor, e incluso compite con modelos más grandes en el seguimiento de instrucciones. Para la llamada a herramientas, el modelo genera de forma predeterminada llamadas a funciones de Python eficientes y admite el cambio fluido al formato JSON a través de indicaciones del sistema.
El modelo recibió el soporte completo de los principales marcos de inferencia el día de su lanzamiento, incluidos llama.cpp, MLX, vLLM y SGLang. En las pruebas de hardware, alcanzó velocidades de decodificación de hasta 253 bytes por segundo en el chip M5 Max y de unos 30 bytes por segundo en dispositivos móviles, equilibrando a la perfección la privacidad y la eficiencia para implementaciones en el borde.








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Finally, an open-source model that actually runs on my laptop without melting it. No more cloud dependence? Count me in. 😏












