


 Maison
Moins c'est plus: comment la récupération de moins de documents améliore les réponses de l'IA
La Génération Augmentée par Récupération (RAG) est une approche innovante pour construire des systèmes d'IA, combinant un modèle linguistique avec une source de connaissances externe pour améliorer la précision et réduire les erreurs factuelles. En essence, l'IA recherche des documents pertinents liés à la requête d'un utilisateur et utilise ces informations pour générer une réponse plus précise. Cette méthode a été reconnue pour sa capacité à maintenir les grands modèles linguistiques (LLMs) ancrés dans des données réelles, minimisant le risque d'hallucinations.
Vous pourriez supposer que fournir à une IA plus de documents conduirait à des réponses mieux informées. Cependant, une étude récente de l'Université Hébraïque de Jérusalem suggère le contraire : lorsqu'il s'agit de fournir des informations à une IA, moins peut en effet être plus.
Moins de Documents, Meilleures Réponses
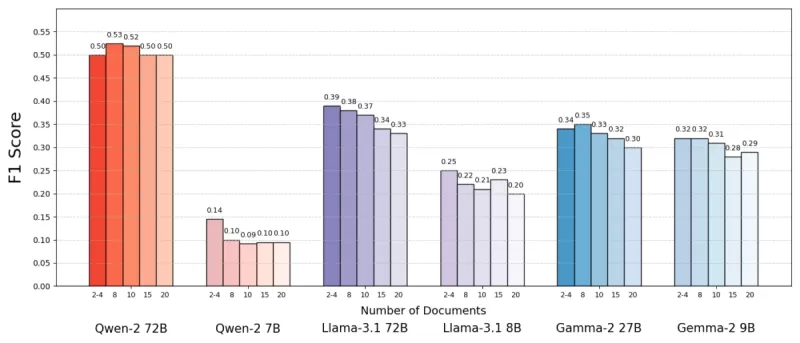
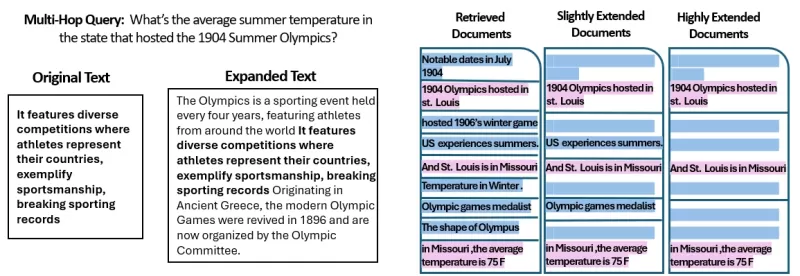
L'étude a examiné comment le nombre de documents fournis à un système RAG affecte ses performances. Les chercheurs ont maintenu une longueur totale de texte constante, ajustant le nombre de documents de 20 à 2-4 documents pertinents et en augmentant ceux-ci pour correspondre au volume de texte initial. Cela leur a permis d'isoler l'effet de la quantité de documents sur les performances.
En utilisant l'ensemble de données MuSiQue, qui comprend des questions de culture générale associées à des paragraphes de Wikipédia, ils ont constaté que les modèles d'IA performaient souvent mieux avec moins de documents. La précision s'est améliorée jusqu'à 10 % (mesurée par le score F1) lorsque le système se concentrait sur quelques documents clés plutôt qu'une vaste collection. Cette tendance s'est maintenue à travers divers modèles linguistiques open-source, tels que Llama de Meta, Qwen-2 étant l'exception notable, maintenant ses performances avec plusieurs documents.
 Source : Levy et al.
Ce résultat surprenant remet en question la croyance commune selon laquelle plus d'informations aide toujours. Même avec la même quantité de texte, la présence de plusieurs documents semblait compliquer la tâche de l'IA, introduisant plus de bruit que de signal.
Pourquoi Moins Peut Être Plus dans le RAG
Le principe "moins, c'est plus" prend tout son sens lorsque l'on considère comment les modèles d'IA traitent l'information. Avec moins de documents, mais plus pertinents, l'IA peut se concentrer sur le contexte essentiel sans distractions, tout comme un étudiant qui étudie le matériel le plus pertinent.
Dans l'étude, les modèles performaient mieux lorsqu'on leur donnait uniquement les documents directement pertinents pour la réponse, car ce contexte plus propre et ciblé facilitait l'extraction de l'information correcte. Inversement, lorsque l'IA devait trier de nombreux documents, elle avait souvent du mal à gérer le mélange de contenus pertinents et non pertinents. Des documents similaires mais non liés pouvaient induire le modèle en erreur, augmentant le risque d'hallucinations.
Il est intéressant de noter que l'étude a révélé que l'IA pouvait plus facilement ignorer les documents manifestement non pertinents que ceux légèrement hors sujet. Cela suggère que des distracteurs réalistes sont plus déroutants que des distracteurs aléatoires. En limitant les documents à ceux strictement nécessaires, nous réduisons la probabilité de tendre de tels pièges.
De plus, utiliser moins de documents réduit la surcharge computationnelle, rendant le système plus efficace et économique. Cette approche améliore non seulement la précision, mais aussi les performances globales du système RAG.
 Source : Levy et al.
Repenser le RAG : Orientations Futures
Ces résultats ont des implications significatives pour la conception des futurs systèmes d'IA qui s'appuient sur des connaissances externes. Ils suggèrent que se concentrer sur la qualité et la pertinence des documents récupérés, plutôt que sur leur quantité, pourrait améliorer les performances. Les auteurs de l'étude plaident pour des méthodes de récupération qui équilibrent pertinence et diversité, garantissant une couverture complète sans submerger le modèle avec du texte superflu.
Les recherches futures pourraient explorer de meilleurs systèmes de récupération ou des re-classeurs pour identifier les documents véritablement précieux et améliorer la manière dont les modèles linguistiques gèrent plusieurs sources. Améliorer les modèles eux-mêmes, comme observé avec Qwen-2, pourrait également fournir des idées pour les rendre plus robustes face à des entrées variées.
À mesure que les systèmes d'IA développent des fenêtres de contexte plus larges, la capacité à traiter plus de texte à la fois devient moins critique que de s'assurer que le texte est pertinent et bien sélectionné. L'étude, intitulée "Plus de Documents, Même Longueur," souligne l'importance de se concentrer sur l'information la plus pertinente pour améliorer la précision et l'efficacité de l'IA.
En conclusion, cette recherche remet en question nos hypothèses sur l'entrée de données dans les systèmes d'IA. En sélectionnant soigneusement moins de documents, mais de meilleure qualité, nous pouvons créer des systèmes RAG plus intelligents, plus économes, qui fournissent des réponses plus précises et fiables.
Article connexe
 Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc
Slackbot devient un agent d'IA
Slackbot, l’assistant automatisé intégré à la plateforme de messagerie d’entreprise Slack de Salesforce, évolue vers un agent d’intelligence artificielle. Le CTO de Salesforce, Parker Harris, envisage qu’il atteigne une notoriété virale comparable à
ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85
Recommandations de sujets spéciaux liés
Éducation et apprentissage
 Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 10 outils
 xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai
Rapide
Les meilleures bibliothèques de prompts d'IA pour les workflows ChatGPT
2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Éducation et apprentissage
Plateformes de création de quiz IA pour les enseignants, les tuteurs et les programmes d’apprentissage en cohorte
2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

 commentaires (51)
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
La Génération Augmentée par Récupération (RAG) est une approche innovante pour construire des systèmes d'IA, combinant un modèle linguistique avec une source de connaissances externe pour améliorer la précision et réduire les erreurs factuelles. En essence, l'IA recherche des documents pertinents liés à la requête d'un utilisateur et utilise ces informations pour générer une réponse plus précise. Cette méthode a été reconnue pour sa capacité à maintenir les grands modèles linguistiques (LLMs) ancrés dans des données réelles, minimisant le risque d'hallucinations.
Vous pourriez supposer que fournir à une IA plus de documents conduirait à des réponses mieux informées. Cependant, une étude récente de l'Université Hébraïque de Jérusalem suggère le contraire : lorsqu'il s'agit de fournir des informations à une IA, moins peut en effet être plus.
Moins de Documents, Meilleures Réponses
L'étude a examiné comment le nombre de documents fournis à un système RAG affecte ses performances. Les chercheurs ont maintenu une longueur totale de texte constante, ajustant le nombre de documents de 20 à 2-4 documents pertinents et en augmentant ceux-ci pour correspondre au volume de texte initial. Cela leur a permis d'isoler l'effet de la quantité de documents sur les performances.
En utilisant l'ensemble de données MuSiQue, qui comprend des questions de culture générale associées à des paragraphes de Wikipédia, ils ont constaté que les modèles d'IA performaient souvent mieux avec moins de documents. La précision s'est améliorée jusqu'à 10 % (mesurée par le score F1) lorsque le système se concentrait sur quelques documents clés plutôt qu'une vaste collection. Cette tendance s'est maintenue à travers divers modèles linguistiques open-source, tels que Llama de Meta, Qwen-2 étant l'exception notable, maintenant ses performances avec plusieurs documents.
Source : Levy et al.
Ce résultat surprenant remet en question la croyance commune selon laquelle plus d'informations aide toujours. Même avec la même quantité de texte, la présence de plusieurs documents semblait compliquer la tâche de l'IA, introduisant plus de bruit que de signal.
Pourquoi Moins Peut Être Plus dans le RAG
Le principe "moins, c'est plus" prend tout son sens lorsque l'on considère comment les modèles d'IA traitent l'information. Avec moins de documents, mais plus pertinents, l'IA peut se concentrer sur le contexte essentiel sans distractions, tout comme un étudiant qui étudie le matériel le plus pertinent.
Dans l'étude, les modèles performaient mieux lorsqu'on leur donnait uniquement les documents directement pertinents pour la réponse, car ce contexte plus propre et ciblé facilitait l'extraction de l'information correcte. Inversement, lorsque l'IA devait trier de nombreux documents, elle avait souvent du mal à gérer le mélange de contenus pertinents et non pertinents. Des documents similaires mais non liés pouvaient induire le modèle en erreur, augmentant le risque d'hallucinations.
Il est intéressant de noter que l'étude a révélé que l'IA pouvait plus facilement ignorer les documents manifestement non pertinents que ceux légèrement hors sujet. Cela suggère que des distracteurs réalistes sont plus déroutants que des distracteurs aléatoires. En limitant les documents à ceux strictement nécessaires, nous réduisons la probabilité de tendre de tels pièges.
De plus, utiliser moins de documents réduit la surcharge computationnelle, rendant le système plus efficace et économique. Cette approche améliore non seulement la précision, mais aussi les performances globales du système RAG.
Source : Levy et al.
Repenser le RAG : Orientations Futures
Ces résultats ont des implications significatives pour la conception des futurs systèmes d'IA qui s'appuient sur des connaissances externes. Ils suggèrent que se concentrer sur la qualité et la pertinence des documents récupérés, plutôt que sur leur quantité, pourrait améliorer les performances. Les auteurs de l'étude plaident pour des méthodes de récupération qui équilibrent pertinence et diversité, garantissant une couverture complète sans submerger le modèle avec du texte superflu.
Les recherches futures pourraient explorer de meilleurs systèmes de récupération ou des re-classeurs pour identifier les documents véritablement précieux et améliorer la manière dont les modèles linguistiques gèrent plusieurs sources. Améliorer les modèles eux-mêmes, comme observé avec Qwen-2, pourrait également fournir des idées pour les rendre plus robustes face à des entrées variées.
À mesure que les systèmes d'IA développent des fenêtres de contexte plus larges, la capacité à traiter plus de texte à la fois devient moins critique que de s'assurer que le texte est pertinent et bien sélectionné. L'étude, intitulée "Plus de Documents, Même Longueur," souligne l'importance de se concentrer sur l'information la plus pertinente pour améliorer la précision et l'efficacité de l'IA.
En conclusion, cette recherche remet en question nos hypothèses sur l'entrée de données dans les systèmes d'IA. En sélectionnant soigneusement moins de documents, mais de meilleure qualité, nous pouvons créer des systèmes RAG plus intelligents, plus économes, qui fournissent des réponses plus précises et fiables.








 Comment corriger les Core Web Vitals pour de meilleurs classements SEO
Fluidifiez les commentaires de bulletin avec des outils d'IAIntroductionOutils d'IA pour générer des commentaires de bulletinMagic SchoolAlmanac AIChat GPTUtilisation de Magic School pour générer des commentaires de bulletinConnexion à Magic Sc
 Slackbot devient un agent d'IA
Slackbot, l’assistant automatisé intégré à la plateforme de messagerie d’entreprise Slack de Salesforce, évolue vers un agent d’intelligence artificielle. Le CTO de Salesforce, Parker Harris, envisage qu’il atteigne une notoriété virale comparable à
 ByteDance renforce les incitations à l’IA centrale alors que Doubao bondit de 14,6 %
ByteDance a récemment organisé une réunion d’information sur l’évaluation de DouBao afin de dévoiler de nouvelles politiques d’incitation pour le personnel impliqué dans la division DouBao. Le prix d’exercice des actions DouBao a été relevé de 14,85

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleures bibliothèques de prompts IA les mieux notées pour optimiser tous les types de flux de travail ChatGPT. XIX.AI a sélectionné une collection puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles afin de garantir des performances optimales. Vous trouverez des comparaisons détaillées entre les solutions gratuites et payantes, ainsi que des classements d'experts pour vous aider à choisir les outils incontournables qui boosteront votre productivité et vous permettront de tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

2026 Dernières Meilleures Plateformes de Création de Quiz par IA pour les Enseignants, Tuteurs et Programmes d’Apprentissage en Cohorte ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et transformateurs, testés dans des situations réelles pour garantir des classements précis. Ces plateformes incontournables permettent d’améliorer l’efficacité rédactionnelle, de simplifier la création de contenu et de faciliter la conception de quiz dans tous les contextes d’apprentissage. Explorez dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer parti de l’avantage offert par l’IA dans votre enseignement !
13 outils
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












