


 Дом
«Меньше больше: как получение меньшего количества документов усиливает ответы ИИ»
Генерация с дополненным извлечением (RAG) — это инновационный подход к созданию систем ИИ, сочетающий языковую модель с внешним источником знаний для повышения точности и уменьшения фактических ошибок. По сути, ИИ ищет релевантные документы, связанные с запросом пользователя, и использует эту информацию для формирования более точного ответа. Этот метод получил признание благодаря своей способности удерживать большие языковые модели (LLMs) в рамках реальных данных, минимизируя риск галлюцинаций.
Можно предположить, что предоставление ИИ большего количества документов приведет к более информированным ответам. Однако недавнее исследование Еврейского университета в Иерусалиме показывает обратное: когда речь идет о предоставлении информации ИИ, меньше действительно может быть лучше.
Меньше документов, лучше ответы
Исследование изучило, как количество документов, предоставленных системе RAG, влияет на ее производительность. Исследователи сохраняли постоянную общую длину текста, варьируя количество документов от 20 до 2–4 релевантных и расширяя их, чтобы соответствовать исходному объему текста. Это позволило изолировать влияние количества документов на производительность.
Используя набор данных MuSiQue, который включает вопросы по тривии в сочетании с параграфами из Википедии, они обнаружили, что модели ИИ часто работали лучше с меньшим количеством документов. Точность улучшалась до 10% (по метрике F1) при использовании лишь нескольких ключевых документов вместо широкого набора. Эта тенденция сохранялась для различных языковых моделей с открытым исходным кодом, таких как Llama от Meta, за исключением Qwen-2, которая сохраняла свою производительность при использовании нескольких документов.
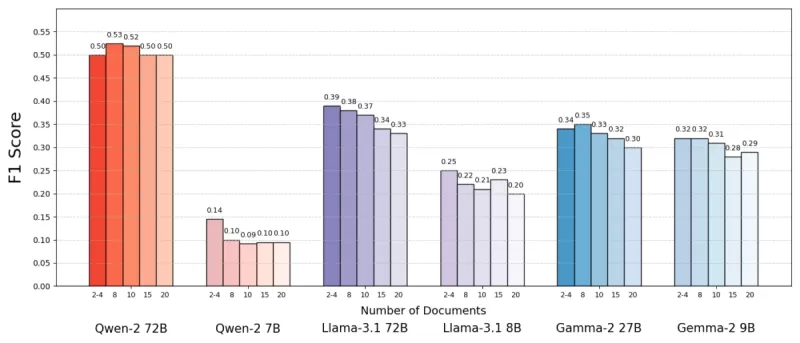 Источник: Леви и др.
Этот неожиданный результат опровергает распространенное мнение, что больше информации всегда лучше. Даже при одинаковом объеме текста наличие множества документов, похоже, усложняло задачу ИИ, внося больше шума, чем сигнала.
Почему меньше может быть лучше в RAG
Принцип «меньше — значит больше» имеет смысл, если учесть, как модели ИИ обрабатывают информацию. С меньшим количеством более релевантных документов ИИ может сосредоточиться на основном контексте без отвлечений, подобно студенту, изучающему наиболее подходящий материал.
В исследовании модели работали лучше, когда получали только документы, непосредственно связанные с ответом, поскольку этот более чистый и сфокусированный контекст облегчал извлечение правильной информации. Напротив, когда ИИ приходилось просеивать множество документов, он часто испытывал трудности с сочетанием релевантного и нерелевантного контента. Похожие, но не связанные документы могли ввести модель в заблуждение, увеличивая риск галлюцинаций.
Интересно, что исследование показало, что ИИ легче игнорировал явно нерелевантные документы, чем те, которые были слегка не по теме. Это говорит о том, что реалистичные отвлекающие факторы более запутывают, чем случайные. Ограничивая количество документов только необходимыми, мы снижаем вероятность создания таких ловушек.
Кроме того, использование меньшего количества документов снижает вычислительные затраты, делая систему более эффективной и экономичной. Этот подход не только повышает точность, но и улучшает общую производительность системы RAG.
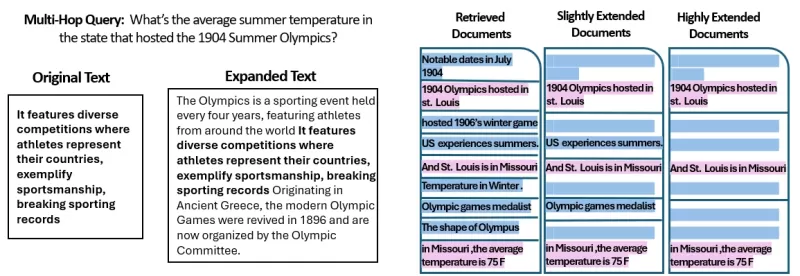 Источник: Леви и др.
Переосмысление RAG: будущие направления
Эти выводы имеют значительные последствия для проектирования будущих систем ИИ, зависящих от внешних знаний. Они предполагают, что сосредоточение на качестве и релевантности извлеченных документов, а не на их количестве, может повысить производительность. Авторы исследования выступают за методы извлечения, которые балансируют релевантность и разнообразие, обеспечивая всестороннее покрытие без перегрузки модели лишним текстом.
Будущие исследования могут быть направлены на разработку лучших систем извлечения или алгоритмов переранжирования для определения действительно ценных документов и улучшения того, как языковые модели обрабатывают множественные источники. Усовершенствование самих моделей, как видно на примере Qwen-2, также может дать понимание того, как сделать их более устойчивыми к разнообразным входным данным.
По мере того как системы ИИ развивают более широкие контекстные окна, способность обрабатывать больше текста одновременно становится менее критичной, чем обеспечение релевантности и курирования текста. Исследование под названием «Больше документов, та же длина» подчеркивает важность сосредоточения на наиболее подходящей информации для повышения точности и эффективности ИИ.
В заключение, это исследование бросает вызов нашим предположениям о вводе данных в системы ИИ. Тщательно выбирая меньше, но более качественных документов, мы можем создавать более умные и экономичные системы RAG, которые обеспечивают более точные и надежные ответы.
Связанная статья
 ByteDance усиливает основные стимулы для ИИ, поскольку Doubao растет на 14,6%
Недавно ByteDance провела краткий брифинг по акциям DouBao, чтобы раскрыть новые стимулирующие политики для сотрудников, участвующих в подразделении DouBao. Цена исполнения для акций DouBao была повышена с $14.85 в июне 2026 года до $17.02, что соста
MiniMax представляет программу Team Program с 10-кратным вознаграждением для стимулирования глобальных экспертов в области ИИ
Компания MiniMax (Xiyu Technology), Лаборатория общего искусственного интеллекта, официально запустила инициативу по глобальному сотрудничеству с талантами «Команда 10x». Эта программа направлена на привлечение ведущих экспертов из различных отраслей
Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в
Рекомендации по связанным специальным темам
Образование и обучение
 Инструменты на базе искусственного интеллекта для выполнения домашних заданий и подготовки к экзаменам
2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
 10 инструментов
 xix.ai
Музыкальная композиция
Инструменты для создания вокальных демо на основе ИИ для авторов песен, создания хуков, написания тоpline-мелодий и проведения многоязычных черновых сессий
2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai
Бизнес
Лучшие инструменты для анализа конкурентов на основе искусственного интеллекта для малого бизнеса
2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
Редактирование изображений
Инструменты ИИ-ретуши в Photoshop для электронной коммерции, одежды, очистки кожи и обеспечения цветового единообразия
2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai
Быстрый
Лучшие библиотеки подсказок для ИИ в рабочих процессах ChatGPT
2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai
Образование и обучение
Платформы для создания викторин с ИИ для учителей, репетиторов и программ обучения в группах
2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

 Комментарии (51)
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
Генерация с дополненным извлечением (RAG) — это инновационный подход к созданию систем ИИ, сочетающий языковую модель с внешним источником знаний для повышения точности и уменьшения фактических ошибок. По сути, ИИ ищет релевантные документы, связанные с запросом пользователя, и использует эту информацию для формирования более точного ответа. Этот метод получил признание благодаря своей способности удерживать большие языковые модели (LLMs) в рамках реальных данных, минимизируя риск галлюцинаций.
Можно предположить, что предоставление ИИ большего количества документов приведет к более информированным ответам. Однако недавнее исследование Еврейского университета в Иерусалиме показывает обратное: когда речь идет о предоставлении информации ИИ, меньше действительно может быть лучше.
Меньше документов, лучше ответы
Исследование изучило, как количество документов, предоставленных системе RAG, влияет на ее производительность. Исследователи сохраняли постоянную общую длину текста, варьируя количество документов от 20 до 2–4 релевантных и расширяя их, чтобы соответствовать исходному объему текста. Это позволило изолировать влияние количества документов на производительность.
Используя набор данных MuSiQue, который включает вопросы по тривии в сочетании с параграфами из Википедии, они обнаружили, что модели ИИ часто работали лучше с меньшим количеством документов. Точность улучшалась до 10% (по метрике F1) при использовании лишь нескольких ключевых документов вместо широкого набора. Эта тенденция сохранялась для различных языковых моделей с открытым исходным кодом, таких как Llama от Meta, за исключением Qwen-2, которая сохраняла свою производительность при использовании нескольких документов.
Источник: Леви и др.
Этот неожиданный результат опровергает распространенное мнение, что больше информации всегда лучше. Даже при одинаковом объеме текста наличие множества документов, похоже, усложняло задачу ИИ, внося больше шума, чем сигнала.
Почему меньше может быть лучше в RAG
Принцип «меньше — значит больше» имеет смысл, если учесть, как модели ИИ обрабатывают информацию. С меньшим количеством более релевантных документов ИИ может сосредоточиться на основном контексте без отвлечений, подобно студенту, изучающему наиболее подходящий материал.
В исследовании модели работали лучше, когда получали только документы, непосредственно связанные с ответом, поскольку этот более чистый и сфокусированный контекст облегчал извлечение правильной информации. Напротив, когда ИИ приходилось просеивать множество документов, он часто испытывал трудности с сочетанием релевантного и нерелевантного контента. Похожие, но не связанные документы могли ввести модель в заблуждение, увеличивая риск галлюцинаций.
Интересно, что исследование показало, что ИИ легче игнорировал явно нерелевантные документы, чем те, которые были слегка не по теме. Это говорит о том, что реалистичные отвлекающие факторы более запутывают, чем случайные. Ограничивая количество документов только необходимыми, мы снижаем вероятность создания таких ловушек.
Кроме того, использование меньшего количества документов снижает вычислительные затраты, делая систему более эффективной и экономичной. Этот подход не только повышает точность, но и улучшает общую производительность системы RAG.
Источник: Леви и др.
Переосмысление RAG: будущие направления
Эти выводы имеют значительные последствия для проектирования будущих систем ИИ, зависящих от внешних знаний. Они предполагают, что сосредоточение на качестве и релевантности извлеченных документов, а не на их количестве, может повысить производительность. Авторы исследования выступают за методы извлечения, которые балансируют релевантность и разнообразие, обеспечивая всестороннее покрытие без перегрузки модели лишним текстом.
Будущие исследования могут быть направлены на разработку лучших систем извлечения или алгоритмов переранжирования для определения действительно ценных документов и улучшения того, как языковые модели обрабатывают множественные источники. Усовершенствование самих моделей, как видно на примере Qwen-2, также может дать понимание того, как сделать их более устойчивыми к разнообразным входным данным.
По мере того как системы ИИ развивают более широкие контекстные окна, способность обрабатывать больше текста одновременно становится менее критичной, чем обеспечение релевантности и курирования текста. Исследование под названием «Больше документов, та же длина» подчеркивает важность сосредоточения на наиболее подходящей информации для повышения точности и эффективности ИИ.
В заключение, это исследование бросает вызов нашим предположениям о вводе данных в системы ИИ. Тщательно выбирая меньше, но более качественных документов, мы можем создавать более умные и экономичные системы RAG, которые обеспечивают более точные и надежные ответы.








 ByteDance усиливает основные стимулы для ИИ, поскольку Doubao растет на 14,6%
Недавно ByteDance провела краткий брифинг по акциям DouBao, чтобы раскрыть новые стимулирующие политики для сотрудников, участвующих в подразделении DouBao. Цена исполнения для акций DouBao была повышена с $14.85 в июне 2026 года до $17.02, что соста
 MiniMax представляет программу Team Program с 10-кратным вознаграждением для стимулирования глобальных экспертов в области ИИ
Компания MiniMax (Xiyu Technology), Лаборатория общего искусственного интеллекта, официально запустила инициативу по глобальному сотрудничеству с талантами «Команда 10x». Эта программа направлена на привлечение ведущих экспертов из различных отраслей
 Южная Корея начала строительство национального центра вычислений на базе искусственного интеллекта, инвестируя 2,5 триллиона вон с целевым сроком завершения к 2028 году
Южнокорейское издание EtNews сообщает, что 3 августа в парке дата-центров Solar City в Сунане (провинция Чолла-Намдо) состоялась церемония закладки первого камня в основание Центра вычислений ИИ Кореи (KOACC). При общем объеме инвестиций в 2,5 трлн в

2026: лучшие современные инструменты на базе ИИ для выполнения домашних заданий и подготовки к экзаменам! XIX.AI подготовило рейтинг самых эффективных и революционных инструментов, которые помогают учащимся повысить продуктивность, оптимизировать выполнение домашних заданий и сдавать экзамены на «отлично», проходя проверку в реальных условиях. Получите сравнение бесплатных и платных версий, подробные рейтинги и варианты, которые обязательно стоит попробовать, чтобы раскрыть свой потенциал с помощью ИИ. Узнайте больше прямо сейчас!
10 инструментов
xix.ai

2026 г. лучшие инструменты для демо-записи вокала на базе ИИ для авторов песен, создателей хуков и команд, работающих с контентом на нескольких языках! XIX.AI подготовил список высокооцененных мощных инструментов, изменивших правила игры, прошедших строгие реальные тесты. Вы найдёте подробные данные сравнения бесплатных и платных версий, комплексные рейтинги и обязательные к использованию варианты, которые помогут повысить эффективность написания и раскрыть ваш творческий потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для всех ваших задач по созданию контента!
9 инструментов
xix.ai

2026: новейшие, лучшие и самые высокооцененные инструменты для анализа конкурентов на базе ИИ для малого бизнеса! XIX.AI подготовила чрезвычайно мощную подборку, способную кардинально изменить ситуацию на рынке, которая еженедельно обновляется на основе тщательных тестов в реальных условиях и подробных рейтингов. Вы найдете здесь исчерпывающее сравнение бесплатных и платных версий, которое поможет вам определить инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и получить конкурентное преимущество. Ознакомьтесь с ней прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai

2026 Latest Best Photoshop AI retouch tools for ecommerce apparel, skin cleanup, and color consistency! This top-rated curated list features powerful game-changing solutions that help you boost writing efficiency, streamline content creation, and achieve perfect visual results effortlessly. Each tool has undergone real-world tests through weekly updated rankings, complete with free vs paid comparison details. Backed by XIX.AI, it’s the must-try guide for anyone aiming to unlock your AI edge. Explore now!
10 инструментов
xix.ai

2026: новейшие и лучшие библиотеки подсказок для ИИ с высоким рейтингом, предназначенные для оптимизации всех типов рабочих процессов ChatGPT. XIX.AI подготовила мощную, революционную подборку, прошедшую тщательные тесты в реальных условиях для обеспечения максимальной производительности. Вы найдёте подробные сравнения бесплатных и платных вариантов, а также рейтинги экспертов, которые помогут вам выбрать инструменты, которые обязательно стоит попробовать, чтобы повысить свою продуктивность и раскрыть весь потенциал ИИ. Откройте для себя их прямо сейчас!
11 инструментов
xix.ai

2026 Latest Best AI Quiz Builder Platforms for Teachers, Tutors, and Cohort-Based Learning Programs! XIX.AI has curated a top-rated list of powerful game-changing tools that go through real-world tests to deliver accurate rankings. These must-try platforms help boost writing efficiency, streamline content creation, and simplify quiz design across all learning scenarios. Explore now to discover your perfect tool for unlocking your AI edge in teaching!
13 инструментов
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












