


 집
더 적은 점 : 문서를 적게 검색하는 방법 AI 응답을 향상시키는 방법
검색 증강 생성(RAG)은 언어 모델과 외부 지식 소스를 결합하여 정확성을 높이고 사실적 오류를 줄이는 혁신적인 AI 시스템 구축 접근법입니다. 본질적으로, AI는 사용자의 질의와 관련된 문서를 검색하고 이 정보를 활용하여 더 정확한 응답을 생성합니다. 이 방법은 대규모 언어 모델(LLMs)을 실제 데이터에 기반을 두게 하여 환각(hallucination) 위험을 최소화하는 능력으로 인정받고 있습니다.
AI에 더 많은 문서를 제공하면 더 정보에 기반한 답변을 얻을 것이라고 생각할 수 있습니다. 그러나 예루살렘 히브리 대학교의 최근 연구는 그 반대를 시사합니다: AI에 정보를 제공할 때 적은 것이 실제로 더 나을 수 있습니다.
문서 수 줄이기, 더 나은 답변
이 연구는 RAG 시스템에 제공된 문서의 수가 성능에 어떤 영향을 미치는지 탐구했습니다. 연구자들은 총 텍스트 길이를 일정하게 유지하면서 문서 수를 20개에서 2~4개의 관련 문서로 줄이고, 이를 원래 텍스트 양에 맞게 확장했습니다. 이를 통해 문서 수량이 성능에 미치는 영향을 분리할 수 있었습니다.
MuSiQue 데이터셋을 사용했으며, 이 데이터셋은 퀴즈 질문과 위키피디아 문단으로 구성되어 있습니다. 연구 결과, AI 모델은 문서 수가 적을 때 더 나은 성능을 보였습니다. 시스템이 광범위한 문서 컬렉션 대신 몇 개의 핵심 문서에 집중했을 때 정확도가 최대 10% 향상되었습니다(F1 점수로 측정). 이 추세는 Meta의 Llama와 같은 다양한 오픈소스 언어 모델에서 나타났으며, Qwen-2는 여러 문서에서도 성능을 유지한 주목할 만한 예외였습니다.
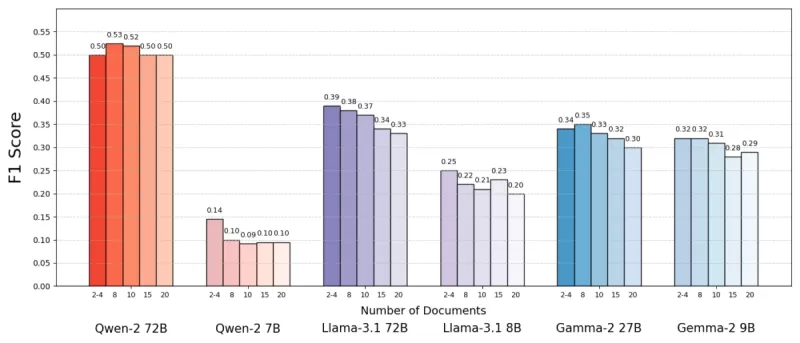 출처: Levy et al.
이 놀라운 결과는 더 많은 정보가 항상 도움이 된다는 일반적인 믿음에 도전합니다. 같은 텍스트 양이라도 여러 문서가 존재하면 AI의 작업이 복잡해져 신호보다 잡음이 더 많이 유입되는 것으로 보입니다.
RAG에서 적은 것이 더 나은 이유
“적은 것이 더 많다”는 원리는 AI 모델이 정보를 처리하는 방식을 고려할 때 이해할 수 있습니다. 더 적고 관련성 높은 문서를 제공받으면 AI는 방해 없이 핵심 맥락에 집중할 수 있습니다. 마치 학생이 가장 관련 있는 자료만 공부하는 것과 비슷합니다.
연구에서 모델은 답변에 직접 관련된 문서만 제공받았을 때 더 나은 성능을 보였습니다. 이 깔끔하고 집중된 맥락은 올바른 정보를 추출하기 쉽게 만들었습니다. 반대로, AI가 많은 문서를 검토해야 할 때는 관련성과 무관한 내용이 섞여 어려움을 겪었습니다. 유사하지만 관련 없는 문서는 모델을 오도하여 환각의 위험을 높였습니다.
흥미롭게도, 연구는 AI가 명백히 무관한 문서보다 미묘하게 주제에서 벗어난 문서를 더 쉽게 무시할 수 있음을 발견했습니다. 이는 현실적인 방해 요소가 무작위적인 것보다 더 혼란스럽다는 것을 시사합니다. 필요한 문서만으로 제한함으로써 이러한 함정을 설정할 가능성을 줄일 수 있습니다.
또한, 문서 수를 줄이면 계산 부담이 낮아져 시스템이 더 효율적이고 비용 효율적으로 작동합니다. 이 접근법은 정확성을 높일 뿐만 아니라 RAG 시스템의 전반적인 성능을 향상시킵니다.
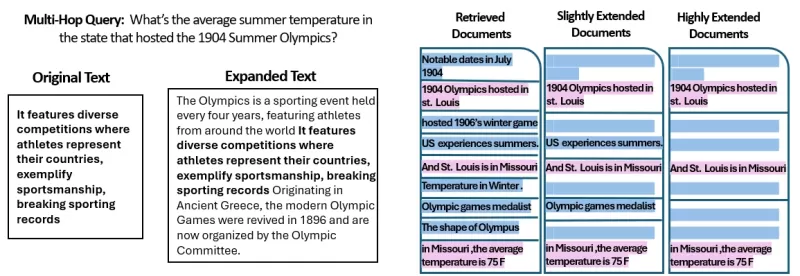 출처: Levy et al.
RAG 재고: 미래 방향
이러한 발견은 외부 지식에 의존하는 미래 AI 시스템 설계에 중요한 시사점을 제공합니다. 검색된 문서의 양보다 품질과 관련성에 집중하는 것이 성능을 향상시킬 수 있음을 시사합니다. 연구 저자들은 관련성과 다양성의 균형을 맞춘 검색 방법을 옹호하며, 불필요한 텍스트로 모델을 압도하지 않으면서 포괄적인 커버리지를 보장할 것을 제안합니다.
미래 연구는 정말로 가치 있는 문서를 식별하고 언어 모델이 여러 소스를 처리하는 방식을 개선하기 위해 더 나은 검색 시스템이나 재순위 시스템을 탐구할 수 있습니다. Qwen-2에서 보듯이 모델 자체를 개선하면 다양한 입력에 더 강건한 모델을 만드는 데 통찰을 제공할 수 있습니다.
AI 시스템이 더 큰 맥락 창을 개발함에 따라, 한 번에 더 많은 텍스트를 처리하는 능력은 텍스트가 관련 있고 선별된 것인지 확인하는 것보다 덜 중요해집니다. "More Documents, Same Length"라는 제목의 이 연구는 AI 정확성과 효율성을 개선하기 위해 가장 관련 있는 정보에 집중하는 중요성을 강조합니다.
결론적으로, 이 연구는 AI 시스템의 데이터 입력에 대한 우리의 가정을 도전합니다. 더 적고 더 나은 문서를 신중히 선택함으로써, 더 정확하고 신뢰할 수 있는 답변을 제공하는 더 스마트하고 간결한 RAG 시스템을 만들 수 있습니다.
관련 기사
 MiniMax, 전 세계 AI 전문가들을 장려하기 위해 10배 팀 프로그램을 공개합니다
MiniMax(시위 테크놀로지)의 범용 인공지능 연구소는 글로벌 인재 협력 프로그램인 '10x 팀'을 공식적으로 출시했습니다. 이 프로그램은 다양한 산업 분야의 최고 전문가들을 모집하여 대형 모델의 전문 수직 분야에 대한 심층적인 응용을 탐구하는 것을 목표로 합니다. 심층적인 산업 지식과 최첨단 AI를 통합함으로써 MiniMax는 대형 모델의 생산성을 일반적인 사용에서 전문적인 시나리오로 확장하여 궁극적으로 산업 효율성의 '10배 증가'를 주도
리눅스 재단에 6대 기술 거대기업이 1250만 달러를 지원해 AI 취약성 소음 문제 해결에 나서다
AI 자동화 도구가 생성한 저품질 보안 보고서의 홍수를 처리하기 위해, 앤트로픽(Anthropic), 아마존(AWS), 깃허브(GitHub), 구글(Google), 마이크로소프트(Microsoft), 오픈AI(OpenAI) 등 6대 주요 기술 기업은 리눅스 재단(Linux Foundation) 이니셔티브에 총 1,250만 달러의 자금을 공동으로 기부했습니다. 이 투자는 오픈 소스 소프트웨어(FOSS) 유지 관리자가 수동 선별의 부담에서 벗어나
관련 특별 주제 추천
음악 작곡
 songwriter, 후크, 탑라인 및 다국어 초안 세션을 위한 AI 보컬 데모 도구
2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
 9 도구
 xix.ai
사업
중소기업을 위한 최고의 AI 경쟁사 분석 도구
2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai
이미지 편집
이커머스 의류용 Photoshop AI 보정 도구, 피부 결 정리 및 색상 일관성
2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai
즉각적인
ChatGPT 워크플로우에 가장 적합한 AI 프롬프트 라이브러리
2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai
교육 및 학습
교사, 과외 교사 및 코호트 기반 학습 프로그램을 위한 AI 퀴즈 빌더 플랫폼
2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai
암호
리팩토링, 버그, 보안 취약점을 처리하는 GitHub 팀을 위한 AI 풀 리퀘스트 검토 도구
GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
12 도구
xix.ai

 의견 (51)
0/500
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
검색 증강 생성(RAG)은 언어 모델과 외부 지식 소스를 결합하여 정확성을 높이고 사실적 오류를 줄이는 혁신적인 AI 시스템 구축 접근법입니다. 본질적으로, AI는 사용자의 질의와 관련된 문서를 검색하고 이 정보를 활용하여 더 정확한 응답을 생성합니다. 이 방법은 대규모 언어 모델(LLMs)을 실제 데이터에 기반을 두게 하여 환각(hallucination) 위험을 최소화하는 능력으로 인정받고 있습니다.
AI에 더 많은 문서를 제공하면 더 정보에 기반한 답변을 얻을 것이라고 생각할 수 있습니다. 그러나 예루살렘 히브리 대학교의 최근 연구는 그 반대를 시사합니다: AI에 정보를 제공할 때 적은 것이 실제로 더 나을 수 있습니다.
문서 수 줄이기, 더 나은 답변
이 연구는 RAG 시스템에 제공된 문서의 수가 성능에 어떤 영향을 미치는지 탐구했습니다. 연구자들은 총 텍스트 길이를 일정하게 유지하면서 문서 수를 20개에서 2~4개의 관련 문서로 줄이고, 이를 원래 텍스트 양에 맞게 확장했습니다. 이를 통해 문서 수량이 성능에 미치는 영향을 분리할 수 있었습니다.
MuSiQue 데이터셋을 사용했으며, 이 데이터셋은 퀴즈 질문과 위키피디아 문단으로 구성되어 있습니다. 연구 결과, AI 모델은 문서 수가 적을 때 더 나은 성능을 보였습니다. 시스템이 광범위한 문서 컬렉션 대신 몇 개의 핵심 문서에 집중했을 때 정확도가 최대 10% 향상되었습니다(F1 점수로 측정). 이 추세는 Meta의 Llama와 같은 다양한 오픈소스 언어 모델에서 나타났으며, Qwen-2는 여러 문서에서도 성능을 유지한 주목할 만한 예외였습니다.
출처: Levy et al.
이 놀라운 결과는 더 많은 정보가 항상 도움이 된다는 일반적인 믿음에 도전합니다. 같은 텍스트 양이라도 여러 문서가 존재하면 AI의 작업이 복잡해져 신호보다 잡음이 더 많이 유입되는 것으로 보입니다.
RAG에서 적은 것이 더 나은 이유
“적은 것이 더 많다”는 원리는 AI 모델이 정보를 처리하는 방식을 고려할 때 이해할 수 있습니다. 더 적고 관련성 높은 문서를 제공받으면 AI는 방해 없이 핵심 맥락에 집중할 수 있습니다. 마치 학생이 가장 관련 있는 자료만 공부하는 것과 비슷합니다.
연구에서 모델은 답변에 직접 관련된 문서만 제공받았을 때 더 나은 성능을 보였습니다. 이 깔끔하고 집중된 맥락은 올바른 정보를 추출하기 쉽게 만들었습니다. 반대로, AI가 많은 문서를 검토해야 할 때는 관련성과 무관한 내용이 섞여 어려움을 겪었습니다. 유사하지만 관련 없는 문서는 모델을 오도하여 환각의 위험을 높였습니다.
흥미롭게도, 연구는 AI가 명백히 무관한 문서보다 미묘하게 주제에서 벗어난 문서를 더 쉽게 무시할 수 있음을 발견했습니다. 이는 현실적인 방해 요소가 무작위적인 것보다 더 혼란스럽다는 것을 시사합니다. 필요한 문서만으로 제한함으로써 이러한 함정을 설정할 가능성을 줄일 수 있습니다.
또한, 문서 수를 줄이면 계산 부담이 낮아져 시스템이 더 효율적이고 비용 효율적으로 작동합니다. 이 접근법은 정확성을 높일 뿐만 아니라 RAG 시스템의 전반적인 성능을 향상시킵니다.
출처: Levy et al.
RAG 재고: 미래 방향
이러한 발견은 외부 지식에 의존하는 미래 AI 시스템 설계에 중요한 시사점을 제공합니다. 검색된 문서의 양보다 품질과 관련성에 집중하는 것이 성능을 향상시킬 수 있음을 시사합니다. 연구 저자들은 관련성과 다양성의 균형을 맞춘 검색 방법을 옹호하며, 불필요한 텍스트로 모델을 압도하지 않으면서 포괄적인 커버리지를 보장할 것을 제안합니다.
미래 연구는 정말로 가치 있는 문서를 식별하고 언어 모델이 여러 소스를 처리하는 방식을 개선하기 위해 더 나은 검색 시스템이나 재순위 시스템을 탐구할 수 있습니다. Qwen-2에서 보듯이 모델 자체를 개선하면 다양한 입력에 더 강건한 모델을 만드는 데 통찰을 제공할 수 있습니다.
AI 시스템이 더 큰 맥락 창을 개발함에 따라, 한 번에 더 많은 텍스트를 처리하는 능력은 텍스트가 관련 있고 선별된 것인지 확인하는 것보다 덜 중요해집니다. "More Documents, Same Length"라는 제목의 이 연구는 AI 정확성과 효율성을 개선하기 위해 가장 관련 있는 정보에 집중하는 중요성을 강조합니다.
결론적으로, 이 연구는 AI 시스템의 데이터 입력에 대한 우리의 가정을 도전합니다. 더 적고 더 나은 문서를 신중히 선택함으로써, 더 정확하고 신뢰할 수 있는 답변을 제공하는 더 스마트하고 간결한 RAG 시스템을 만들 수 있습니다.








 MiniMax, 전 세계 AI 전문가들을 장려하기 위해 10배 팀 프로그램을 공개합니다
MiniMax(시위 테크놀로지)의 범용 인공지능 연구소는 글로벌 인재 협력 프로그램인 '10x 팀'을 공식적으로 출시했습니다. 이 프로그램은 다양한 산업 분야의 최고 전문가들을 모집하여 대형 모델의 전문 수직 분야에 대한 심층적인 응용을 탐구하는 것을 목표로 합니다. 심층적인 산업 지식과 최첨단 AI를 통합함으로써 MiniMax는 대형 모델의 생산성을 일반적인 사용에서 전문적인 시나리오로 확장하여 궁극적으로 산업 효율성의 '10배 증가'를 주도

 리눅스 재단에 6대 기술 거대기업이 1250만 달러를 지원해 AI 취약성 소음 문제 해결에 나서다
AI 자동화 도구가 생성한 저품질 보안 보고서의 홍수를 처리하기 위해, 앤트로픽(Anthropic), 아마존(AWS), 깃허브(GitHub), 구글(Google), 마이크로소프트(Microsoft), 오픈AI(OpenAI) 등 6대 주요 기술 기업은 리눅스 재단(Linux Foundation) 이니셔티브에 총 1,250만 달러의 자금을 공동으로 기부했습니다. 이 투자는 오픈 소스 소프트웨어(FOSS) 유지 관리자가 수동 선별의 부담에서 벗어나

2026년 최신 최고의 AI 보컬 데모 도구: 작곡가, 후크 제작자 및 다국어 콘텐츠 팀을 위한! XIX.AI는 엄격한 실전 테스트를 거친 강력한 혁신 도구의 최고 평점 목록을 선별했습니다. 여기서는 무료 대 유료 비교 데이터, 종합 순위, 그리고 필수 추천 옵션을 확인할 수 있어 작사 효율성을 높이고 창의적 잠재력을 발휘하는 데 도움이 됩니다. 지금 탐색하여 모든 콘텐츠 요구에 맞는 완벽한 도구를 발견하세요!
9 도구
xix.ai

2026년 중소기업을 위한 최신 최고 평점의 AI 경쟁 분석 도구! XIX.AI는 매주 엄격한 실제 테스트와 상세한 순위를 바탕으로 업데이트되는, 업계 판도를 바꿀 만큼 강력한 도구 모음을 엄선했습니다. 생산성을 높이고 경쟁 우위를 확보할 수 있는 ‘꼭 사용해 봐야 할’ 도구를 찾아보실 수 있도록, 무료 버전과 유료 버전의 포괄적인 비교 정보를 제공합니다. 지금 바로 살펴보고 여러분에게 딱 맞는 도구를 찾아보세요!
9 도구
xix.ai

2026년 최신 최고의 Photoshop AI 보정 도구: 이커머스 의류, 피부 클리닝, 색상 일관성을 위한! 이 상위 평가 큐레이션 목록은 글쓰기 효율성을 높이고 콘텐츠 제작을 간소화하며 완벽한 시각적 결과를 손쉽게 달성하는 데 도움이 되는 강력한 게임 체인저 솔루션을 특징으로 합니다. 각 도구는 매주 업데이트되는 랭킹을 통해 실제 테스트를 거쳤으며, 무료 대 유료 비교 세부 사항도 포함되어 있습니다. XIX.AI의 지원을 받아 AI 경쟁력을 발휘하고자 하는 모든 이들에게 필수 추천 가이드입니다. 지금 탐색하세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 프롬프트 라이브러리로, 모든 유형의 ChatGPT 워크플로우를 최적화하세요. XIX.AI는 최고의 성능을 보장하기 위해 엄격한 실전 테스트를 거친, 강력하고 획기적인 컬렉션을 엄선했습니다. 생산성을 높이고 AI의 잠재력을 최대한 발휘할 수 있는 필수 도구를 선택하는 데 도움이 되는 무료 vs 유료 상세 비교 정보와 전문가 순위를 확인해 보세요. 지금 바로 살펴보세요!
11 도구
xix.ai

2026년 최신 최고의 AI 퀴즈 빌더 플랫폼: 교사, 튜터 및 코호트 기반 학습 프로그램을 위한! XIX.AI는 실제 테스트를 거쳐 정확한 순위를 제공하는 강력한 게임 체인저 도구들의 최고 평점 목록을 선별했습니다. 이 필수 플랫폼은 모든 학습 시나리오에서 글쓰기 효율성을 높이고, 콘텐츠 제작을 간소화하며, 퀴즈 설계를 단순화하는 데 도움을 줍니다. 지금 탐색하여 교육에서 AI의 이점을 최대한 활용할 수 있는 완벽한 도구를 발견하세요!
13 도구
xix.ai

GitHub 팀을 위한 2026년 최신 최고의 AI 풀 리퀘스트 검토 도구가 XIX.AI에 소개되었습니다! 이 엄선된 최고 평점 목록은 모든 팀 워크플로우 전반에 걸쳐 리팩토링, 버그 수정, 보안 취약점 탐지를 효율화해 주는 획기적인 솔루션을 선보입니다. 무료와 유료 버전의 비교 분석은 물론, 실제 테스트 결과와 상세한 순위 정보를 통해 생산성을 획기적으로 높여줄 완벽한 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
12 도구
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












