


 Maison
La métacognition pourrait être la clé pour mettre fin aux hallucinations dans les grands modèles
Les « hallucinations » des grands modèles — lorsque l’IA présente des erreurs factuelles avec une certitude absolue — constituent depuis longtemps un défi majeur pour le secteur de l’IA. Ce problème revêt une importance particulière dans des domaines à haut risque tels que la santé et le droit.
Depuis des années, le secteur s’est principalement appuyé sur deux stratégies pour lutter contre ces hallucinations : l’une consiste à augmenter massivement le volume des données d’entraînement, dans le but de rendre l’IA « omnisciente » ; l’autre consiste à mettre en place des mécanismes défensifs, encourageant l’IA à « garder le silence » en cas d’incertitude. Mais ces deux approches présentent des limites évidentes. La première ne peut pas couvrir tous les faits existants, ce qui laisse des angles morts. La seconde entraîne souvent un « coût d’utilité » élevé : dans le but d’éliminer les erreurs, l’IA finit par refuser de répondre à de nombreuses questions correctes, ce qui nuit considérablement à l’expérience utilisateur.
Récemment, un article co-rédigé par Google Research et l’université de Tel Aviv a proposé une nouvelle perspective sur ce dilemme : la métacognition. L’étude suggère que la clé pour résoudre le problème des hallucinations n’est pas de forcer l’IA à ne jamais commettre d’erreurs, mais de lui permettre de « savoir ce qu’elle sait — et ce qu’elle ne sait pas ».
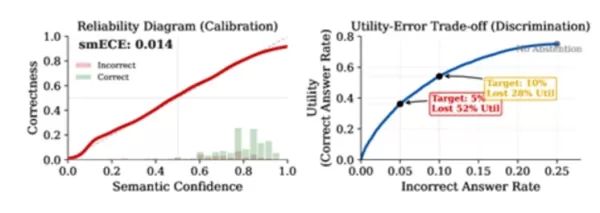
Figure : La différence entre l’étalonnage et la capacité de discrimination. À gauche, un modèle bien étalonné (ligne rouge proche de la diagonale) ; à droite, la dure réalité : même avec un étalonnage parfait, réduire le taux d’erreur de 25 % à 5 % nécessite de sacrifier 52 % des réponses correctes.
L’article redéfinit les hallucinations : le problème central n’est pas de savoir si les résultats de l’IA sont erronés, mais s’ils induisent les utilisateurs en erreur en adoptant un ton assuré alors que le système est incertain. Les chercheurs soutiennent que l’IA devrait posséder la capacité d’une « incertitude fidèle ». Autrement dit, lorsque l’état interne du modèle signale une hésitation ou un faible niveau de confiance, son langage devrait refléter la prudence et la réserve — plutôt que de prétendre énoncer des faits absolus.
La métacognition désigne la conscience qu’a l’IA de ses propres processus cognitifs. Cela exige que les grands modèles perçoivent avec finesse leurs états internes et, sur la base de cette perception, expriment honnêtement leurs niveaux de confiance. À l’ère des agents IA, cette capacité est particulièrement vitale. Un système d’IA dépourvu de métacognition s’apparente à un pilote sans tableau de bord : il ne peut ni déterminer quand faire appel à des outils externes, ni vérifier la fiabilité des résultats de recherche, ce qui le rend susceptible d’une mauvaise utilisation des outils, voire d’un « vol à l’aveugle ».
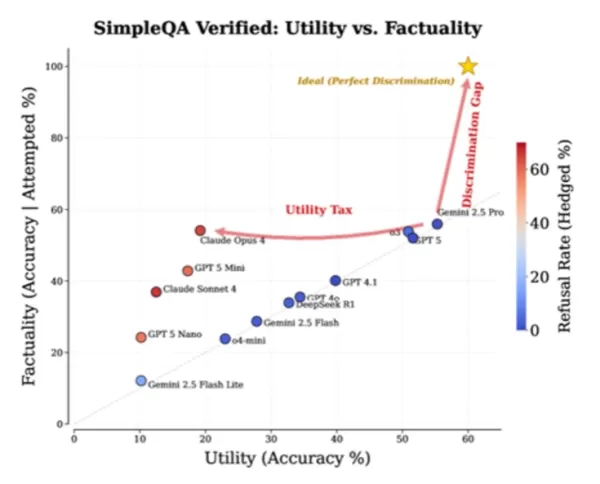
Illustration : performances réelles des principaux modèles sur SimpleQA Verified. L’étoile à cinq branches en haut à droite représente l’objectif idéal ; le « Discrimination Gap » indique l’écart entre les modèles actuels et cet idéal, tandis que l’« Utility Tax » montre le coût que Claude Opus4 doit payer pour atteindre une grande précision.
Bien sûr, la mise en œuvre de cette approche s’accompagne de défis importants. Par exemple, comment distinguer la « véritable métacognition » d’une « mise en scène délibérée de l’incertitude », et comment éviter les effets négatifs du RLHF (apprentissage par renforcement à partir du retour d’information humain) — puisque les humains ont tendance à préférer les réponses assurées, ce qui, d’une certaine manière, encourage en réalité l’IA à apprendre à feindre la confiance.
Pour l’avenir du développement de l’IA, l’étude propose des recommandations pratiques : les indicateurs d’évaluation des technologies anti-hallucination ne devraient plus se concentrer uniquement sur la précision, mais plutôt évaluer l’équilibre entre « utilité et taux d’erreur ». L’IA n’a pas besoin de devenir une machine infaillible, mais elle doit posséder une qualité professionnelle fondamentale : la capacité à distinguer honnêtement entre « je suis certain » et « je fais une supposition ». Cette conscience claire des limites de ses propres connaissances est la voie incontournable pour améliorer la crédibilité et la valeur concrète de l’IA.
Article connexe
 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re
Recommandations de sujets spéciaux liés
Analyse des données
 Meilleurs outils d’IA pour la détection d’anomalies dans le suivi des KPI pour les équipes SaaS et Ecommerce
2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
 10 outils
 xix.ai
en écrivant
Les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs
2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude basés sur l'IA pour les devoirs et la préparation aux examens
Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai
Composition musicale
Outils de démo vocale par IA pour les auteurs-compositeurs, les accroches, les mélodies principales et les sessions de brouillons multilingues
2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai
Entreprise
Les meilleurs outils de veille concurrentielle basés sur l'IA pour les petites entreprises
Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai
Édition d'images
Outils de retouche par IA Photoshop pour les vêtements d’e-commerce, nettoyage de la peau et cohérence des couleurs
2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

 commentaires (0)
Les « hallucinations » des grands modèles — lorsque l’IA présente des erreurs factuelles avec une certitude absolue — constituent depuis longtemps un défi majeur pour le secteur de l’IA. Ce problème revêt une importance particulière dans des domaines à haut risque tels que la santé et le droit.
Depuis des années, le secteur s’est principalement appuyé sur deux stratégies pour lutter contre ces hallucinations : l’une consiste à augmenter massivement le volume des données d’entraînement, dans le but de rendre l’IA « omnisciente » ; l’autre consiste à mettre en place des mécanismes défensifs, encourageant l’IA à « garder le silence » en cas d’incertitude. Mais ces deux approches présentent des limites évidentes. La première ne peut pas couvrir tous les faits existants, ce qui laisse des angles morts. La seconde entraîne souvent un « coût d’utilité » élevé : dans le but d’éliminer les erreurs, l’IA finit par refuser de répondre à de nombreuses questions correctes, ce qui nuit considérablement à l’expérience utilisateur.
Récemment, un article co-rédigé par Google Research et l’université de Tel Aviv a proposé une nouvelle perspective sur ce dilemme : la métacognition. L’étude suggère que la clé pour résoudre le problème des hallucinations n’est pas de forcer l’IA à ne jamais commettre d’erreurs, mais de lui permettre de « savoir ce qu’elle sait — et ce qu’elle ne sait pas ».
Figure : La différence entre l’étalonnage et la capacité de discrimination. À gauche, un modèle bien étalonné (ligne rouge proche de la diagonale) ; à droite, la dure réalité : même avec un étalonnage parfait, réduire le taux d’erreur de 25 % à 5 % nécessite de sacrifier 52 % des réponses correctes.
L’article redéfinit les hallucinations : le problème central n’est pas de savoir si les résultats de l’IA sont erronés, mais s’ils induisent les utilisateurs en erreur en adoptant un ton assuré alors que le système est incertain. Les chercheurs soutiennent que l’IA devrait posséder la capacité d’une « incertitude fidèle ». Autrement dit, lorsque l’état interne du modèle signale une hésitation ou un faible niveau de confiance, son langage devrait refléter la prudence et la réserve — plutôt que de prétendre énoncer des faits absolus.
La métacognition désigne la conscience qu’a l’IA de ses propres processus cognitifs. Cela exige que les grands modèles perçoivent avec finesse leurs états internes et, sur la base de cette perception, expriment honnêtement leurs niveaux de confiance. À l’ère des agents IA, cette capacité est particulièrement vitale. Un système d’IA dépourvu de métacognition s’apparente à un pilote sans tableau de bord : il ne peut ni déterminer quand faire appel à des outils externes, ni vérifier la fiabilité des résultats de recherche, ce qui le rend susceptible d’une mauvaise utilisation des outils, voire d’un « vol à l’aveugle ».
Illustration : performances réelles des principaux modèles sur SimpleQA Verified. L’étoile à cinq branches en haut à droite représente l’objectif idéal ; le « Discrimination Gap » indique l’écart entre les modèles actuels et cet idéal, tandis que l’« Utility Tax » montre le coût que Claude Opus4 doit payer pour atteindre une grande précision.
Bien sûr, la mise en œuvre de cette approche s’accompagne de défis importants. Par exemple, comment distinguer la « véritable métacognition » d’une « mise en scène délibérée de l’incertitude », et comment éviter les effets négatifs du RLHF (apprentissage par renforcement à partir du retour d’information humain) — puisque les humains ont tendance à préférer les réponses assurées, ce qui, d’une certaine manière, encourage en réalité l’IA à apprendre à feindre la confiance.
Pour l’avenir du développement de l’IA, l’étude propose des recommandations pratiques : les indicateurs d’évaluation des technologies anti-hallucination ne devraient plus se concentrer uniquement sur la précision, mais plutôt évaluer l’équilibre entre « utilité et taux d’erreur ». L’IA n’a pas besoin de devenir une machine infaillible, mais elle doit posséder une qualité professionnelle fondamentale : la capacité à distinguer honnêtement entre « je suis certain » et « je fais une supposition ». Cette conscience claire des limites de ses propres connaissances est la voie incontournable pour améliorer la crédibilité et la valeur concrète de l’IA.








 Les actions américaines atteignent un jalon historique alors que les géants de l'IA et de l'aérospatiale se préparent pour leur entrée boursière à la valeur du trillion de dollars.
Elon Musk, Sam Altman et Dario Amodei, trois titans du secteur technologique, s’approchent des introductions en bourse de leurs entreprises respectives. Avec SpaceX, OpenAI et Anthropic – trois géants de l’industrie dont les valorisations approchent
 La startup suédoise en intelligence artificielle Lovable Eyes atteint une valorisation de 13,2 milliards de dollars après un tour de table majeur
Alors que les outils de codage alimentés par l’intelligence artificielle gagnent en popularité, la startup suédoise Lovable a levé des fonds lors d’un tour de table majeur. L’entreprise vise à collecter 3 milliards de dollars, ce qui pourrait porter
Google teste l'agent IA Remy pour Gemini à mesure que l'accent se déplace vers le contrôle utilisateur
Selon Business Insider, Google teste Remy, un nouvel agent personnel d’IA pour Gemini. Cet outil vise à exécuter des tâches au nom des utilisateurs, rationalisant ainsi les flux de travail professionnels et les routines quotidiennes.Actuellement, Re

2026 Derniers Meilleurs Outils de Détection d’Anomalies par IA les mieux notés pour la surveillance des KPI dans les équipes SaaS et E-commerce ! XIX.AI a sélectionné une collection puissante et révolutionnaire, basée sur des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, afin de vous aider à identifier la solution incontournable qui améliore la productivité et débloque votre avantage concurrentiel grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai

2026 : les meilleurs générateurs de plans basés sur l'IA pour les articles SEO longs, soigneusement sélectionnés par XIX.AI. Ces outils puissants offrent une aide révolutionnaire pour créer rapidement du contenu de haute qualité, améliorant ainsi considérablement l'efficacité de la rédaction. Découvrez une comparaison entre les versions gratuites et payantes, ainsi que des tests concrets et des classements détaillés pour vous aider à trouver l'option incontournable qui répond à vos besoins. Explorez dès maintenant pour tirer pleinement parti de l'IA.
8 outils
xix.ai

Les meilleurs outils d'IA de 2026 pour les devoirs et la préparation aux examens ! XIX.AI vous propose une sélection des outils les mieux notés, puissants et révolutionnaires, qui aident les élèves à booster leur productivité, à optimiser la réalisation de leurs devoirs et à réussir haut la main leurs examens grâce à des tests concrets. Découvrez un comparatif entre les versions gratuites et payantes, des classements détaillés et des options incontournables pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Démonstration Vocale par IA pour les Paroliers, Créateurs d’Accroches et Équipes de Contenu Multilingues ! XIX.AI a sélectionné une liste primée d’outils puissants et révolutionnaires, soumis à des tests rigoureux en conditions réelles. Vous y trouverez des données détaillées comparant les versions gratuites et payantes, des classements complets et des options incontournables à essayer pour améliorer votre efficacité d’écriture et libérer votre potentiel créatif. Explorez dès maintenant pour découvrir l’outil parfait répondant à tous vos besoins en contenu !
9 outils
xix.ai

Les meilleurs outils de recherche concurrentielle basés sur l’IA les plus récents et les mieux notés pour les petites entreprises en 2026 ! XIX.AI a sélectionné une collection extrêmement puissante et révolutionnaire, mise à jour chaque semaine à l’issue de tests rigoureux en conditions réelles et accompagnée de classements détaillés. Vous y trouverez un comparatif complet entre les versions gratuites et payantes pour vous aider à identifier les outils incontournables qui boosteront votre productivité et vous donneront un avantage concurrentiel. Découvrez-la dès maintenant pour trouver l'outil qui vous convient le mieux !
9 outils
xix.ai

2026 Derniers meilleurs outils de retouche par IA Photoshop pour les vêtements e-commerce, le nettoyage de la peau et la cohérence des couleurs ! Cette liste soigneusement sélectionnée et hautement notée propose des solutions puissantes qui changent la donne, vous aidant à améliorer l’efficacité rédactionnelle, rationaliser la création de contenu et obtenir des résultats visuels parfaits sans effort. Chaque outil a été testé dans des conditions réelles grâce à des classements mis à jour chaque semaine, accompagnés de détails comparatifs entre versions gratuites et payantes. Soutenu par XIX.AI, c’est le guide incontournable pour quiconque souhaite exploiter son avantage grâce à l’IA. Explorez dès maintenant !
10 outils
xix.ai












