


 Hogar
La metacognición podría ser la clave para acabar con las alucinaciones en los modelos a gran escala
Las alucinaciones de los modelos a gran escala —en las que la IA presenta errores fácticos con absoluta seguridad— han sido durante mucho tiempo un reto fundamental en el sector de la IA. Este problema cobra especial relevancia en ámbitos de alto riesgo, como la sanidad y el derecho.
Durante años, el sector ha seguido principalmente dos estrategias para combatir las alucinaciones: una consiste en ampliar masivamente los datos de entrenamiento, con el fin de intentar que la IA sea «omnisciente»; la otra consiste en crear mecanismos defensivos, animando a la IA a «guardar silencio» cuando no esté segura. Sin embargo, ambos enfoques presentan claras limitaciones. La primera no puede abarcar todos los hechos existentes, lo que deja puntos ciegos. La segunda suele acarrear un elevado «impuesto de utilidad»: en su afán por eliminar los errores, la IA acaba negándose a responder a muchas preguntas correctas, lo que perjudica significativamente la experiencia del usuario.
Recientemente, un artículo elaborado conjuntamente por Google Research y la Universidad de Tel Aviv ofrece una nueva perspectiva sobre este dilema: la metacognición. El estudio sugiere que la clave para resolver el problema de las alucinaciones no es obligar a la IA a no cometer nunca errores, sino permitirle «saber lo que sabe —y lo que no sabe—».
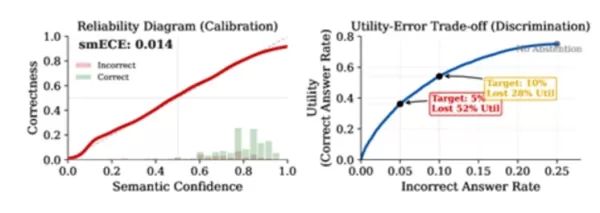
Figura: La diferencia entre la calibración y la capacidad discriminativa. A la izquierda se muestra un modelo bien calibrado (línea roja cercana a la diagonal), mientras que a la derecha se revela la cruda realidad: incluso con una calibración perfecta, reducir la tasa de error del 25 % al 5 % requiere sacrificar el 52 % de las respuestas correctas.
El artículo redefine las alucinaciones: la cuestión fundamental no es si los resultados de la IA son erróneos, sino si inducen a error a los usuarios con un tono de seguridad cuando el sistema tiene dudas. Los investigadores sostienen que la IA debería poseer la capacidad de «incertidumbre fiel». Es decir, cuando el estado interno del modelo indique vacilación o baja confianza, su lenguaje debería reflejar cautela y reserva, en lugar de fingir que expone hechos absolutos.
La metacognición se refiere a la conciencia que tiene la IA de sus propios procesos cognitivos. Esto requiere que los grandes modelos perciban con sensibilidad sus estados internos y, basándose en esa percepción, expresen con honestidad sus niveles de confianza. En la era de los agentes de IA, esta capacidad es especialmente vital. Un sistema de IA sin metacognición es como un piloto sin cuadro de mandos: no puede determinar cuándo recurrir a herramientas externas, ni puede verificar la fiabilidad de los resultados de búsqueda, lo que lo hace propenso al uso indebido de las herramientas e incluso a «volar a ciegas».
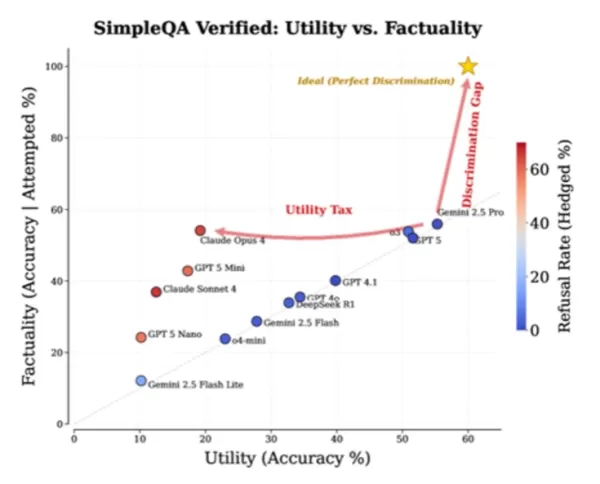
Figura: Rendimiento real de los principales modelos en SimpleQA Verified. La estrella de cinco puntas situada en la parte superior derecha marca el objetivo ideal; la «brecha de discriminación» indica la distancia entre los modelos actuales y ese ideal, mientras que el «impuesto de utilidad» muestra el coste que Claude Opus4 paga para alcanzar una alta precisión.
Por supuesto, llevar a cabo este enfoque conlleva importantes retos. Por ejemplo, cómo distinguir la «verdadera metacognición» de la «simulación deliberada de incertidumbre», y cómo evitar los efectos negativos del RLHF (aprendizaje por refuerzo a partir de la retroalimentación humana), ya que los seres humanos tienden a preferir respuestas seguras, lo que, en cierto modo, anima a la IA a aprender a fingir confianza.
De cara al futuro del desarrollo de la IA, el estudio ofrece recomendaciones prácticas: las métricas de evaluación de las tecnologías contra las alucinaciones ya no deberían centrarse únicamente en la precisión, sino evaluar el equilibrio entre «utilidad y tasa de error». La IA no necesita convertirse en una máquina infalible, pero debe poseer una cualidad profesional básica: la capacidad de distinguir con honestidad entre «estoy seguro» y «estoy suponiendo». Esta clara conciencia de los límites de su propio conocimiento es el camino esencial para mejorar la credibilidad de la IA y su valor en el mundo real.
Artículo relacionado
 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar
Recomendaciones de temas especiales relacionados
Análisis de datos
 Mejores herramientas de IA para la detección de anomalías en el monitoreo de KPIs para equipos de SaaS y comercio electrónico
¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
 10 herramientas
 xix.ai
escribiendo
Los mejores generadores de esquemas basados en IA para artículos largos optimizados para SEO
Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio basadas en IA para los deberes y la preparación de exámenes
¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai
composicion musical
Herramientas de demostración vocal con IA para compositores, ganchos, melodías principales y sesiones de borrador multilingüe
¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai
Negocio
Las mejores herramientas de investigación competitiva basadas en IA para pequeñas empresas
¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai
Edición de imágenes
Herramientas de retoque con IA de Photoshop para ropa de comercio electrónico, limpieza de piel y consistencia del color
¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

 comentario (0)
0/500
Las alucinaciones de los modelos a gran escala —en las que la IA presenta errores fácticos con absoluta seguridad— han sido durante mucho tiempo un reto fundamental en el sector de la IA. Este problema cobra especial relevancia en ámbitos de alto riesgo, como la sanidad y el derecho.
Durante años, el sector ha seguido principalmente dos estrategias para combatir las alucinaciones: una consiste en ampliar masivamente los datos de entrenamiento, con el fin de intentar que la IA sea «omnisciente»; la otra consiste en crear mecanismos defensivos, animando a la IA a «guardar silencio» cuando no esté segura. Sin embargo, ambos enfoques presentan claras limitaciones. La primera no puede abarcar todos los hechos existentes, lo que deja puntos ciegos. La segunda suele acarrear un elevado «impuesto de utilidad»: en su afán por eliminar los errores, la IA acaba negándose a responder a muchas preguntas correctas, lo que perjudica significativamente la experiencia del usuario.
Recientemente, un artículo elaborado conjuntamente por Google Research y la Universidad de Tel Aviv ofrece una nueva perspectiva sobre este dilema: la metacognición. El estudio sugiere que la clave para resolver el problema de las alucinaciones no es obligar a la IA a no cometer nunca errores, sino permitirle «saber lo que sabe —y lo que no sabe—».
Figura: La diferencia entre la calibración y la capacidad discriminativa. A la izquierda se muestra un modelo bien calibrado (línea roja cercana a la diagonal), mientras que a la derecha se revela la cruda realidad: incluso con una calibración perfecta, reducir la tasa de error del 25 % al 5 % requiere sacrificar el 52 % de las respuestas correctas.
El artículo redefine las alucinaciones: la cuestión fundamental no es si los resultados de la IA son erróneos, sino si inducen a error a los usuarios con un tono de seguridad cuando el sistema tiene dudas. Los investigadores sostienen que la IA debería poseer la capacidad de «incertidumbre fiel». Es decir, cuando el estado interno del modelo indique vacilación o baja confianza, su lenguaje debería reflejar cautela y reserva, en lugar de fingir que expone hechos absolutos.
La metacognición se refiere a la conciencia que tiene la IA de sus propios procesos cognitivos. Esto requiere que los grandes modelos perciban con sensibilidad sus estados internos y, basándose en esa percepción, expresen con honestidad sus niveles de confianza. En la era de los agentes de IA, esta capacidad es especialmente vital. Un sistema de IA sin metacognición es como un piloto sin cuadro de mandos: no puede determinar cuándo recurrir a herramientas externas, ni puede verificar la fiabilidad de los resultados de búsqueda, lo que lo hace propenso al uso indebido de las herramientas e incluso a «volar a ciegas».
Figura: Rendimiento real de los principales modelos en SimpleQA Verified. La estrella de cinco puntas situada en la parte superior derecha marca el objetivo ideal; la «brecha de discriminación» indica la distancia entre los modelos actuales y ese ideal, mientras que el «impuesto de utilidad» muestra el coste que Claude Opus4 paga para alcanzar una alta precisión.
Por supuesto, llevar a cabo este enfoque conlleva importantes retos. Por ejemplo, cómo distinguir la «verdadera metacognición» de la «simulación deliberada de incertidumbre», y cómo evitar los efectos negativos del RLHF (aprendizaje por refuerzo a partir de la retroalimentación humana), ya que los seres humanos tienden a preferir respuestas seguras, lo que, en cierto modo, anima a la IA a aprender a fingir confianza.
De cara al futuro del desarrollo de la IA, el estudio ofrece recomendaciones prácticas: las métricas de evaluación de las tecnologías contra las alucinaciones ya no deberían centrarse únicamente en la precisión, sino evaluar el equilibrio entre «utilidad y tasa de error». La IA no necesita convertirse en una máquina infalible, pero debe poseer una cualidad profesional básica: la capacidad de distinguir con honestidad entre «estoy seguro» y «estoy suponiendo». Esta clara conciencia de los límites de su propio conocimiento es el camino esencial para mejorar la credibilidad de la IA y su valor en el mundo real.








 Las acciones de EE. UU. alcanzan un hito histórico mientras gigantes de la IA y la aeroespacial se preparan para su debut de un billón de dólares
Elon Musk, Sam Altman y Dario Amodei, tres titanes del sector tecnológico, están avanzando hacia ofertas públicas iniciales para sus respectivas empresas. Con SpaceX, OpenAI y Anthropic, tres gigantes de la industria que se acercan a valoraciones de
 La startup sueca de inteligencia artificial Lovable Eyes alcanza una valoración de 13.200 millones de dólares tras una importante ronda de financiación
Mientras las herramientas de codificación impulsadas por inteligencia artificial ganan terreno, la startup sueca Lovable ha asegurado una importante ronda de financiación. La empresa tiene como objetivo recaudar 3 000 millones de dólares, lo que podr
Google prueba el agente Remy AI para Gemini a medida que el enfoque se desplaza hacia el control del usuario
Según Business Insider, Google está probando Remy, un nuevo agente personal de IA para Gemini. Esta herramienta tiene como objetivo ejecutar tareas en nombre de los usuarios, optimizando tanto los flujos de trabajo profesionales como las rutinas diar

¡Las mejores herramientas de detección de anomalías con IA de 2026, más valoradas y destacadas para el monitoreo de KPI en equipos de SaaS y comercio electrónico! XIX.AI ha recopilado una poderosa colección transformadora basada en rigurosas pruebas del mundo real y clasificaciones actualizadas semanalmente. Encontrarás comparaciones detalladas entre versiones gratuitas y de pago que te ayudarán a identificar la solución imprescindible para aumentar la productividad y desbloquear tu ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai

Los mejores generadores de esquemas con IA mejor valorados de 2026 para artículos largos optimizados para SEO, seleccionados minuciosamente por XIX.AI. Estas potentes herramientas ofrecen una ayuda revolucionaria a la hora de crear contenido de alta calidad rápidamente, lo que aumenta considerablemente la eficiencia a la hora de escribir. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones detalladas, que te ayudarán a encontrar la opción imprescindible que mejor se adapte a tus necesidades. Explora ahora para descubrir las ventajas que te ofrece la IA.
8 herramientas
xix.ai

¡Las mejores herramientas de IA de 2026 para hacer los deberes y prepararse para los exámenes! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los estudiantes a aumentar su productividad, agilizar la realización de los deberes y sacar sobresaliente en los exámenes gracias a pruebas reales. Consigue una comparación entre versiones gratuitas y de pago, clasificaciones detalladas y opciones imprescindibles para sacar el máximo partido a la IA. ¡Explora ahora!
10 herramientas
xix.ai

¡Las mejores herramientas de demostración vocal con IA de 2026 para compositores, creadores de ganchos y equipos de contenido multilingüe! XIX.AI ha recopilado una lista de herramientas poderosas y transformadoras, rigurosamente probadas en el mundo real. Encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas y opciones imprescindibles para ayudarte a aumentar tu eficiencia de escritura y desbloquear todo tu potencial creativo. ¡Explora ahora para descubrir la herramienta perfecta para todas tus necesidades de contenido!
9 herramientas
xix.ai

¡Las mejores herramientas de investigación competitiva basadas en IA mejor valoradas de 2026 para pequeñas empresas! XIX.AI ha seleccionado una colección revolucionaria y muy potente, que se actualiza semanalmente con rigurosas pruebas en el mundo real y clasificaciones detalladas. Encontrarás una comparación exhaustiva entre las opciones gratuitas y las de pago que te ayudará a identificar las herramientas imprescindibles que impulsarán tu productividad y te proporcionarán una ventaja competitiva. ¡Explora ahora mismo y descubre la herramienta perfecta para ti!
9 herramientas
xix.ai

¡Las mejores herramientas de retoque con IA de Photoshop de 2026 para ropa de comercio electrónico, limpieza de piel y consistencia de color! Esta lista curada de alta calificación presenta soluciones poderosas que cambian las reglas del juego, que ayudan a aumentar la eficiencia de redacción, optimizar la creación de contenido y lograr resultados visuales perfectos sin esfuerzo. Cada herramienta ha pasado por pruebas en el mundo real a través de clasificaciones actualizadas semanalmente, con detalles completos de comparación entre versiones gratuitas y de pago. Respaldado por XIX.AI, es la guía imprescindible para cualquier persona que aspire a desbloquear su ventaja con IA. ¡Explora ahora!
10 herramientas
xix.ai












